Perbandingan rata-rata muncul hampir di setiap analisis data, misalnya menakar apakah satu kelas berbeda dari standar sekolah atau apakah dua metode belajar menghasilkan nilai yang berbeda. Topik ini membahas uji t (t-test) satu sampel dan uji t dua sampel bebas, tiga asumsi yang menyertainya, cara membaca keluaran TtestResult dari SciPy, serta uji permutasi (permutation test) sebagai pembanding berbasis simulasi. Contoh menggunakan data nilai ujian yang dibangkitkan dengan benih (seed) generator acak yang tetap, sehingga setiap angka keluaran dapat direproduksi.
Uji satu sampel terhadap nilai acuan#
Uji t satu sampel memeriksa apakah rata-rata (mean) sebuah sampel berbeda dari nilai acuan tertentu ketika simpangan baku (standard deviation) populasi tidak diketahui. Nilai acuannya dapat berupa standar kelulusan, target kinerja, atau rata-rata historis. Statistik ujinya mengukur jarak rata-rata sampel dari acuan dalam satuan ketidakpastian estimasinya.
Pembilang rumus tersebut adalah selisih rata-rata sampel terhadap acuan , sedangkan penyebutnya adalah standard error rata-rata sampel. Semakin besar ukuran sampel atau semakin kecil sebarannya, semakin kecil penyebut itu, sehingga selisih yang sama menghasilkan t yang lebih besar. Program berikut menguji apakah rata-rata nilai ujian 24 siswa berbeda dari 75.
import numpy as np
from scipy import stats

# Nilai ujian statistika dari 24 siswa satu kelas
rng = np.random.default_rng(42)
nilai = np.round(rng.normal(78.0, 6.0, size=24))

# Uji apakah rata-rata kelas berbeda dari nilai acuan 75
hasil = stats.ttest_1samp(nilai, 75.0)
interval = hasil.confidence_interval(confidence_level=0.95)

print(f"rata-rata kelas          : {nilai.mean():.4f}")
print(f"statistik uji            : {hasil.statistic:.4f}")
print(f"p-value                  : {hasil.pvalue:.4f}")
print(f"derajat kebebasan        : {hasil.df}")
print(f"interval kepercayaan 95% : [{interval.low:.4f}, {interval.high:.4f}]")rata-rata kelas : 77.9167
statistik uji : 2.7887
p-value : 0.0104
derajat kebebasan : 23
interval kepercayaan 95% : [75.7531, 80.0803]SciPy mengembalikan objek TtestResult yang mengumpulkan seluruh angka penting, yaitu atribut statistic untuk statistik uji, pvalue untuk p-value, dan df untuk derajat kebebasan (degrees of freedom). p-value 0.0104 berada di bawah taraf signifikansi 0.05, sehingga hipotesis nol (null hypothesis) yang menyatakan rata-rata kelas sama dengan 75 ditolak. Interval kepercayaan 95 persen berupa [75.7531, 80.0803] tidak memuat 75, dan pesannya konsisten dengan keputusan tersebut. Derajat kebebasannya berupa karena satu parameter, yaitu rata-rata, sudah diestimasi dari data yang sama.
Uji t dua sampel bebas#
Uji t dua sampel bebas membandingkan rata-rata dua kelompok yang anggotanya saling tidak berhubungan, misalnya siswa dari dua kelas dengan metode belajar berbeda. Hipotesis nolnya menyatakan kedua rata-rata populasi sama. Bentuk yang menggabungkan variansi (variance) kedua kelompok menjadi variansi gabungan dituliskan sebagai berikut.
Program berikut menguji dua kelompok dengan ukuran yang tidak seimbang, yaitu 15 siswa kelompok terbimbing dan 45 siswa belajar mandiri. Pengujian yang sama dijalankan dua kali dengan pilihan variansi yang berbeda agar pengaruh pilihannya terlihat jelas. Ukuran kelompok yang timpang sengaja dipilih karena pengaruhnya paling terasa pada variansi gabungan.
import numpy as np
from scipy import stats

# Nilai ujian dua kelompok siswa dengan metode belajar berbeda
rng_a = np.random.default_rng(42)
rng_b = np.random.default_rng(43)
terbimbing = np.round(rng_a.normal(77.0, 6.0, size=15))
mandiri = np.round(rng_b.normal(74.0, 12.0, size=45))

gabungan = stats.ttest_ind(terbimbing, mandiri, equal_var=True)
welch = stats.ttest_ind(terbimbing, mandiri, equal_var=False)

print(f"rata-rata terbimbing = {terbimbing.mean():.4f}, rata-rata mandiri = {mandiri.mean():.4f}")
print(f"variansi terbimbing  = {terbimbing.var(ddof=1):.4f}, variansi mandiri  = {mandiri.var(ddof=1):.4f}")
print(f"equal_var=True : t = {gabungan.statistic:.4f}, df = {gabungan.df:.0f}, p-value = {gabungan.pvalue:.4f}")
print(f"equal_var=False: t = {welch.statistic:.4f}, df = {welch.df:.0f}, p-value = {welch.pvalue:.4f}")rata-rata terbimbing = 77.0667, rata-rata mandiri = 71.1778
variansi terbimbing = 31.9238, variansi mandiri = 137.0131
equal_var=True : t = 1.8693, df = 58, p-value = 0.0666
equal_var=False: t = 2.5892, df = 50, p-value = 0.0126Variansi kedua kelompok berbeda sekitar empat kali lipat, yaitu 31.9238 berbanding 137.0131, dan ukuran kelompoknya tidak seimbang. Dengan equal_var=True, p-value 0.0666 berada di atas taraf 0.05 sehingga perbedaan dinyatakan tidak signifikan. Dengan equal_var=False, yang dikenal sebagai koreksi Welch, p-value 0.0126 menyatakan perbedaan itu signifikan. Dua keputusan yang berlawanan lahir dari data yang sama, sehingga argumen equal_var merupakan bagian dari model yang dipilih dan bukan sekadar pengaturan tampilan.
Asumsi uji t#
Uji t bertumpu pada tiga asumsi yang masing-masing perlu diperiksa sebelum hasilnya dipercaya. Pertama, observasi harus saling bebas, artinya satu nilai tidak memengaruhi nilai lain, dan asumsi ini dijamin oleh cara pengambilan sampel. Kedua, nilai pada setiap kelompok diperkirakan berdistribusi normal, tetapi uji t cukup tahan terhadap pelanggaran ringan ketika ukuran sampel cukup besar karena efek teorema limit pusat. Ketiga, variansi kedua kelompok kira-kira sama bila variansi gabungan dipakai.
Apabila variansi kelompok berbeda jauh atau ukuran kelompok tidak seimbang, gunakan koreksi Welch melalui equal_var=False. Koreksi ini tetap memakai selisih rata-rata yang sama, tetapi menghitung standard error langsung dari masing-masing variansi. Derajat kebebasannya kemudian ditaksir ulang dengan rumus aproksimasi Welch berikut.
Derajat kebebasan hasil taksiran itu menjelaskan mengapa keluaran Welch pada contoh sebelumnya menunjukkan df = 50, bukan 58. Angka yang lebih kecil berarti ekor distribusi t yang sedikit lebih tebal dan ambang keputusan yang sedikit lebih longgar. Karena standard error Welch dihitung langsung dari masing-masing variansi, variansi kelompok besar tidak lagi ikut membesarkan penyebut, sehingga uji tidak lagi melemah. Pada data yang seimbang dan variansinya serupa, pilihan equal_var praktis tidak mengubah hasilnya.
Pembanding permutasi#
Aturan praktis jalur ini menempatkan simulasi sebelum pengujian formal agar intuisinya terbangun lebih dahulu. Untuk uji satu sampel, distribusi nol dapat dibangun tanpa rumus t melalui pembalikan tanda (sign-flipping). Apabila hipotesis nol benar dan data simetris di sekitar acuan, membalik tanda selisih tiap nilai secara acak menghasilkan sampel lain yang berperilaku sama dengan data asli.
Uji permutasi mengulang pembalikan itu 10.000 kali, menghitung rata-rata selisih pada setiap pembalikan, lalu meletakkan data asli di antara tumpukan hasil tersebut. Proporsi pembalikan yang rata-ratanya sama ekstremnya atau lebih ekstrem daripada data asli menjadi p-value-nya. Program berikut menjalankan prosedur itu pada data kelas yang sama dan menggambarkan distribusi nolnya.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Data satu kelas yang sama dengan contoh pertama
rng = np.random.default_rng(42)
nilai = np.round(rng.normal(78.0, 6.0, size=24))
selisih = nilai - 75.0

# Uji t formal sebagai pembanding
formal = stats.ttest_1samp(nilai, 75.0)
print(f"Uji t formal : t = {formal.statistic:.4f}, p-value = {formal.pvalue:.4f}")

# Uji permutasi tanda dengan 10.000 pembalikan tanda selisih
rng_tanda = np.random.default_rng(43)
jumlah = 10_000
tanda = rng_tanda.choice(np.array([-1.0, 1.0]), size=(jumlah, len(selisih)))
rata_acak = (selisih * tanda).mean(axis=1)
p_perm = (np.count_nonzero(np.abs(rata_acak) >= abs(selisih.mean())) + 1) / (jumlah + 1)
print(f"Uji permutasi: rata-rata selisih = {selisih.mean():.4f}, p-value = {p_perm:.4f}")

fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.hist(rata_acak, bins=40, color="#4c72b0", edgecolor="white")
ax.axvline(selisih.mean(), color="#c44e52", linestyle="--", linewidth=2)
ax.set_title("Distribusi rata-rata selisih dari 10.000 pembalikan tanda")
ax.set_xlabel("Rata-rata selisih terhadap 75 (poin)")
ax.set_ylabel("Frekuensi")
fig.savefig("uji-t-permutasi.png", dpi=110)Uji t formal : t = 2.7887, p-value = 0.0104
Uji permutasi: rata-rata selisih = 2.9167, p-value = 0.0112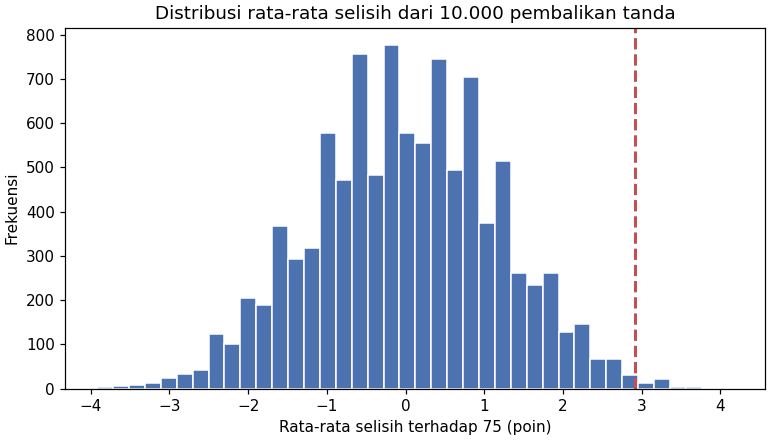
p-value permutasi 0.0112 berdekatan dengan p-value uji t 0.0104, dan keduanya menunjuk keputusan yang sama, yaitu menolak hipotesis nol. Kesepakatan ini wajar karena data contohnya relatif simetris. Keunggulan permutasi terletak pada kebebasannya dari rumus distribusi tertentu, sehingga prosedur yang sama dapat dipakai untuk statistik uji lain, misalnya median, tanpa mencari rumus baru.
Kesalahan umum#
Kesalahan pertama adalah menguji setiap pasangan kelompok dengan uji t secara berulang tanpa koreksi. Tiga kelompok sudah menuntut tiga uji, dan setiap uji membawa peluang 5 persen positif palsu, sehingga peluang minimal satu kekeliruan membengkak jauh melampaui 5 persen. Penanganannya dibahas pada topik Perbandingan Berganda melalui koreksi Bonferroni dan uji Tukey HSD.
Kesalahan kedua adalah membiarkan equal_var=True ketika variansi dan ukuran kelompok tidak seimbang, padahal contoh dua sampel di atas sudah memperlihatkan dua keputusan yang berlawanan akibat pilihan itu. Periksa variansi kedua kelompok terlebih dahulu atau jadikan koreksi Welch pilihan bawaannya. Kesalahan ketiga adalah membaca p-value kecil sebagai bukti perbedaan yang besar. p-value mengukur kecocokan data dengan hipotesis nol, bukan besarnya perbedaan, sehingga besaran efek (effect size) tetap perlu dilaporkan di sampingnya.
Ringkasan#
- Uji t satu sampel membandingkan rata-rata sampel dengan nilai acuan, sedangkan uji t dua sampel bebas membandingkan rata-rata dua kelompok yang saling bebas.
- Keluaran SciPy berupa objek
TtestResultdengan atributstatistic,pvalue, dandfyang terbaca langsung sebagai angka keputusan. - Asumsi utamanya adalah kebebasan observasi, normalitas yang toleran pada sampel cukup besar, dan variansi kelompok yang kira-kira sama.
- Pada variansi dan ukuran kelompok yang tidak seimbang,
equal_var=Falseberupa koreksi Welch mencegah p-value menyesatkan, dan uji permutasi memberi pembanding yang bebas rumus distribusi.
Referensi#
- scipy.stats.ttest_1samp — SciPy — Dokumentasi uji t satu sampel beserta objek hasil dan interval kepercayaannya.
- scipy.stats.ttest_ind — SciPy — Dokumentasi uji t dua sampel bebas dan makna argumen equal_var.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika dengan pembahasan uji t satu sampel dan dua sampel bebas.