Ketika jumlah kelompok bertambah, jumlah pasangan yang menggoda untuk diuji bertambah jauh lebih cepat. Topik ini membahas perbandingan berganda (multiple comparisons), yaitu situasi banyak pasangan kelompok diuji sekaligus, beserta laju error keluarga (family-wise error rate) yang mengukur bahayanya. Dua penanganan yang paling umum, yaitu koreksi Bonferroni dan uji Tukey HSD, dipraktikkan pada data hasil panen tiga perlakuan pupuk yang dibangkitkan dengan benih (seed) tetap.
Banyak pasangan dari sedikit kelompok#
Perbandingan seluruh pasangan dari kelompok menghasilkan uji. Tiga kelompok menuntut tiga uji, empat kelompok menuntut enam uji, dan enam kelompok sudah menuntut 15 uji. Pertumbuhan kuadratik ini membuat bahaya pengujian berulang semakin terasa pada rancangan dengan banyak perlakuan.
| Banyaknya kelompok () | Banyaknya pasangan () |
|---|---|
| 3 | 3 |
| 4 | 6 |
| 5 | 10 |
| 6 | 15 |
Setiap uji pada taraf signifikansi 0.05 membawa peluang 5 persen positif palsu apabila hipotesis nol (null hypothesis) benar. Peluang itu berlaku per uji, sedangkan kepentingan analisis adalah kejujuran keseluruhan, yaitu peluang minimal satu positif palsu pada seluruh keluarga uji. Ukuran inilah yang disebut laju error keluarga, dan nilainya mendekati 1 seiring bertambahnya banyaknya uji. Pertanyaan analisisnya pun bergeser dari apakah satu uji salah menjadi berapa besar peluang laporan memuat temuan yang tidak ada.
Simulasi laju error keluarga#
Laju error keluarga dapat diukur lewat simulasi tanpa rumus apa pun. Program berikut mengulang 10.000 kali skenario yang sama, yaitu 20 perbandingan tanpa efek sungguhan karena setiap pasangan sampelnya berasal dari populasi yang sama. Setiap perbandingan diuji dengan uji t dua sampel bebas pada taraf 0.05, lalu dihitung banyaknya pengulangan yang memuat minimal satu positif palsu.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Simulasi laju error keluarga pada perbandingan yang hipotesis nolnya benar
rng = np.random.default_rng(42)
jumlah_trial = 10_000
jumlah_uji = 20
n = 30

# Setiap uji membandingkan dua sampel dari populasi yang sama
data_1 = rng.normal(0.0, 1.0, size=(jumlah_trial, jumlah_uji, n))
data_2 = rng.normal(0.0, 1.0, size=(jumlah_trial, jumlah_uji, n))
t = (data_1.mean(axis=2) - data_2.mean(axis=2)) / np.sqrt(
    (data_1.var(axis=2, ddof=1) + data_2.var(axis=2, ddof=1)) / n
)
p_value = 2.0 * stats.t.sf(np.abs(t), df=2 * n - 2)

alpha = 0.05
banyak_uji = np.arange(1, jumlah_uji + 1)
laju_mentah = np.array([(p_value[:, :m] < alpha).any(axis=1).mean() for m in banyak_uji])
laju_bonferroni = np.array([(p_value[:, :m] < alpha / m).any(axis=1).mean() for m in banyak_uji])
teori = 1.0 - (1.0 - alpha) ** banyak_uji

print(f"Prediksi rumus 1-(1-0.05)^20 : {teori[-1]:.4f}")
print(f"Laju simulasi tanpa koreksi  : {laju_mentah[-1]:.4f}")
print(f"Laju simulasi dengan Bonferroni: {laju_bonferroni[-1]:.4f}")

fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.plot(banyak_uji, teori, color="#4c72b0", linewidth=2, label="Rumus 1-(1-0.05)^m")
ax.plot(banyak_uji, laju_mentah, "o", color="#4c72b0", markersize=4, label="Simulasi tanpa koreksi")
ax.plot(banyak_uji, laju_bonferroni, "s", color="#55a868", markersize=4, label="Simulasi dengan Bonferroni")
ax.axhline(alpha, color="#c44e52", linestyle="--", linewidth=1.5, label="Taraf signifikansi 0.05")
ax.set_xlabel("Banyaknya perbandingan (m)")
ax.set_ylabel("Peluang minimal satu positif palsu")
ax.set_title("Laju error keluarga menurut banyaknya perbandingan")
ax.legend(fontsize=9)
fig.savefig("perbandingan-berganda-laju.png", dpi=110)Prediksi rumus 1-(1-0.05)^20 : 0.6415
Laju simulasi tanpa koreksi : 0.6408
Laju simulasi dengan Bonferroni: 0.0451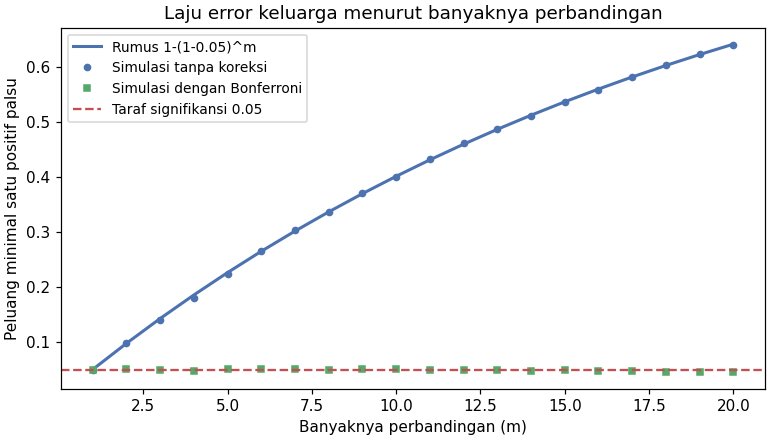
Pada 20 uji tanpa koreksi, 64.08 persen pengulangan memuat minimal satu positif palsu, hampir sama dengan prediksi rumus . Angka tersebut berarti lebih dari separuh laporan yang memuat 20 uji semacam itu menyebut minimal satu temuan yang sebenarnya tidak ada. Grafik juga menunjukkan sisi positifnya, yaitu koreksi Bonferroni menahan laju keluarga di sekitar 0.05 untuk semua jumlah uji.
Koreksi Bonferroni#
Koreksi Bonferroni adalah penanganan yang paling mudah diterapkan. Ambang per uji berupa hasil pembagian taraf signifikansi dengan banyaknya uji, sehingga untuk perbandingan ambangnya menjadi seperti berikut. Pada tiga perbandingan, 0.05 dibagi dengan 3 menghasilkan ambang 0.0167, dan setiap p-value harus turun di bawah angka itu agar dinyatakan signifikan. Sifat koreksi ini konservatif, artinya jarang keliru menolak hipotesis nol, tetapi kekuatannya menurun ketika banyaknya uji membesar.
Data contohnya berupa hasil panen tiga perlakuan pupuk dengan 12 petak per perlakuan. Program berikut menjalankan tiga uji t dua sampel bebas pada taraf 0.05 seolah-olah koreksi belum diterapkan, lalu menyesuaikan setiap p-value dengan ambang Bonferroni. Putusan yang dicetak didasarkan pada p-value yang telah dikoreksi, bukan p-value mentahnya.
import numpy as np
from scipy import stats

# Hasil panen (ton per hektare) tiga perlakuan pupuk, masing-masing 12 petak
rng_a = np.random.default_rng(42)
rng_b = np.random.default_rng(43)
rng_c = np.random.default_rng(44)
pupuk_a = np.round(rng_a.normal(5.20, 0.5, size=12), 2)
pupuk_b = np.round(rng_b.normal(5.60, 0.5, size=12), 2)
pupuk_c = np.round(rng_c.normal(6.35, 0.5, size=12), 2)

# Tiga uji t dua sampel bebas pada tingkat 0.05, lalu koreksi Bonferroni
def format_p(nilai):
    if nilai < 0.0001:
        return "<0.0001"
    return f"{nilai:.4f}"

pasangan = [("A", pupuk_a, "B", pupuk_b),
            ("A", pupuk_a, "C", pupuk_c),
            ("B", pupuk_b, "C", pupuk_c)]
for nama_1, x, nama_2, y in pasangan:
    hasil = stats.ttest_ind(x, y, equal_var=True)
    p_bonferroni = min(1.0, 3.0 * hasil.pvalue)
    putusan = "signifikan" if p_bonferroni < 0.05 else "tidak signifikan"
    print(f"{nama_1} vs {nama_2}: p-value mentah = {format_p(hasil.pvalue)}, "
f"p-value Bonferroni = {format_p(p_bonferroni)} ({putusan})")A vs B: p-value mentah = 0.0246, p-value Bonferroni = 0.0738 (tidak signifikan)
A vs C: p-value mentah = <0.0001, p-value Bonferroni = <0.0001 (signifikan)
B vs C: p-value mentah = <0.0001, p-value Bonferroni = <0.0001 (signifikan)Pasangan A berbanding B menghasilkan p-value mentah 0.0246 yang tampak signifikan pada taraf 0.05, tetapi p-value Bonferroninya 0.0738 sehingga dinyatakan tidak signifikan. Dua pasangan lainnya berbeda sangat jelas dan tetap signifikan setelah dikoreksi. Contoh ini memperlihatkan fungsi koreksi secara langsung, yaitu menahan temuan yang hanya menumpang pada keberuntungan pengambilan sampel.
Uji Tukey HSD#
Uji Tukey HSD (honestly significant difference) dirancang khusus untuk perbandingan seluruh pasangan dari sekumpulan rata-rata (mean) kelompok. Statistik ujinya bertumpu pada distribusi rentang terstudentkan (studentized range), yaitu distribusi rentang rata-rata kelompok yang dibagi estimasi sebarannya. Karena ambangnya dihitung untuk keluarga berisi seluruh pasangan sekaligus, uji ini umumnya lebih kuat daripada koreksi Bonferroni pada tugas yang sama. Fungsi tukey_hsd mengembalikan selisih rata-rata dan p-value setiap pasangan dalam bentuk matriks.
Program berikut menerapkan uji Tukey pada data pupuk yang sama dengan contoh sebelumnya. Argumennya berupa satu array per kelompok, dan urutan argumen menentukan baris serta kolom matriks hasilnya. Keluaran yang dicetak hanya memuat tiga pasangan unik di atas diagonal matriks.
import numpy as np
from scipy import stats

# Data tiga perlakuan pupuk yang sama dengan contoh sebelumnya
rng_a = np.random.default_rng(42)
rng_b = np.random.default_rng(43)
rng_c = np.random.default_rng(44)
pupuk_a = np.round(rng_a.normal(5.20, 0.5, size=12), 2)
pupuk_b = np.round(rng_b.normal(5.60, 0.5, size=12), 2)
pupuk_c = np.round(rng_c.normal(6.35, 0.5, size=12), 2)

# Uji Tukey HSD untuk seluruh pasangan sekaligus
hasil = stats.tukey_hsd(pupuk_a, pupuk_b, pupuk_c)
nama = ["A", "B", "C"]
for i in range(3):
    for j in range(i + 1, 3):
        if hasil.pvalue[i, j] < 0.0001:
            p_tukey = "<0.0001"
        else:
            p_tukey = f"{hasil.pvalue[i, j]:.4f}"
        putusan = "signifikan" if hasil.pvalue[i, j] < 0.05 else "tidak signifikan"
        print(f"Tukey {nama[i]} vs {nama[j]}: selisih rata-rata = {hasil.statistic[i, j]:.4f}, "
f"p-value = {p_tukey} ({putusan})")Tukey A vs B: selisih rata-rata = -0.4675, p-value = 0.0349 (signifikan)
Tukey A vs C: selisih rata-rata = -1.3842, p-value = <0.0001 (signifikan)
Tukey B vs C: selisih rata-rata = -0.9167, p-value = <0.0001 (signifikan)Keputusan pada pasangan yang penuh pertentangan berubah menurut koreksi yang dipilih. Pasangan A berbanding B dinyatakan signifikan oleh Tukey dengan p-value 0.0349, sedangkan koreksi Bonferroni menggugurkannya pada bagian sebelumnya. Dua pasangan lainnya tetap signifikan pada kedua koreksi, sehingga kesimpulan besarnya tidak goyah. Perbedaan pada satu pasangan tersebut mencerminkan desain masing-masing koreksi, yaitu Tukey menetapkan ambangnya khusus untuk keluarga berisi seluruh pasangan sehingga lebih tajam, sedangkan Bonferroni membagi taraf secara seragam untuk keluarga uji apa pun.
Kesalahan umum#
Kesalahan pertama adalah menerapkan koreksi Bonferroni pada keluarga yang besar, misalnya 15 pasangan, lalu menyimpulkan tidak ada efek sama sekali karena tidak ada yang signifikan. Kekuatan uji yang runtuh bukan bukti ketiadaan efek, sehingga interval kepercayaan tiap selisih perlu ikut dilaporkan. Kesalahan kedua adalah menjalankan uji Tukey padahal hanya ada beberapa perbandingan yang memang direncanakan sejak awal. Koreksi untuk seluruh pasangan menjadi berlebihan pada rencana yang sempit, dan pembagian taraf dengan banyaknya perbandingan yang dinyatakan sudah memadai.
Kesalahan ketiga adalah mencampur p-value mentah dan p-value hasil koreksi dalam satu laporan tanpa pembeda yang jelas. Pembaca akan menyangka semuanya diperlakukan sama, padahal keputusan mengikuti angka yang telah dikoreksi. Pilih satu konvensi pelaporan sejak awal dan sebutkan pilihannya pada bagian metode laporan.
Ringkasan#
- kelompok menghasilkan pasangan perbandingan, dan pengujian 20 uji yang hipotesis nolnya benar pada taraf 0.05 tanpa koreksi menghasilkan peluang minimal satu positif palsu sekitar 64 persen.
- Koreksi Bonferroni membagi taraf menjadi , mudah diterapkan, tetapi konservatif ketika banyaknya perbandingan membesar.
- Uji Tukey HSD memakai distribusi rentang terstudentkan untuk seluruh pasangan sekaligus dan umumnya lebih kuat daripada Bonferroni.
- Keluarga perbandingan ditetapkan sebelum data dianalisis, dan p-value yang dilaporkan adalah yang telah dikoreksi.
Referensi#
- scipy.stats.tukey_hsd — SciPy — Dokumentasi uji Tukey HSD beserta matriks selisih dan p-value hasilnya.
- scipy.stats.ttest_ind — SciPy — Dokumentasi uji t dua sampel bebas yang dipakai pada perbandingan tiap pasangan.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika dengan pembahasan perbandingan berganda dan koreksinya.
- NIST/SEMATECH e-Handbook of Statistical Methods — NIST — Panduan teknik statistika yang membahas metode perbandingan berganda.