Teorema limit pusat (central limit theorem, CLT) menjelaskan mengapa kurva normal muncul hampir di seluruh analisis data, bahkan ketika datanya sendiri tidak normal. Topik ini membuktikan teorema tersebut lewat simulasi pada populasi yang jelas tidak normal, yaitu waktu tunggu loket berdistribusi eksponensial, dengan ukuran sampel 2, 10, dan 50. Rata-rata dan lebar distribusi hasil simulasinya diverifikasi terhadap teori, beserta batas penafsiran yang sering keliru.
Populasi yang jauh dari normal#
Waktu tunggu di loket menjadi contoh populasi yang jauh dari normal. Model yang lazim untuk waktu tunggu adalah distribusi eksponensial (exponential distribution) dengan rata-rata 2 menit, yang kepadatannya menurun tajam sejak nol dan berekor panjang ke kanan. Sebaran seperti ini adalah kebalikan kurva lonceng yang simetris, sehingga tidak ada alasan menganggap rata-rata sampelnya normal sejak awal. Justru karena populasinya tidak normal, keberhasilan CLT pada populasi ini menjadi bukti yang meyakinkan.
Sifat eksponensial yang perlu dicatat ada dua. Kemencengan (skewness) populasinya bernilai tetap sebesar 2 pada ukuran apa pun, sedangkan rata-rata dan simpangan bakunya sama besar, yaitu 2 menit. Pada loket yang melayani secara acak, waktu tunggu pendek paling sering terjadi, sedangkan waktu tunggu panjang jarang namun tetap mungkin. Model sejenis tidak terbatas pada loket, karena data tunggu dan umur pakai di banyak bidang juga menurun tajam dan berekor panjang. Bentuk data seperti inilah yang membuat rata-rata dari sedikit pelanggan masih menceng ke kanan.
Simulasi tiga panel#
Skrip berikut menarik 10000 sampel untuk setiap ukuran dari populasi eksponensial tersebut, menghitung rata-rata tiap sampel secara vektor, lalu menggambar tiga histogram kepadatan. Setiap panel memakai jendela horizontal sekitar di sekitar 2 menit agar bentuk kurvanya terbaca. Kurva normal teoretis berparameter dan digambar berwarna merah sebagai pembanding pada ketiga panel.
"""Bukti simulasi teorema limit pusat pada populasi eksponensial."""
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

rng = np.random.default_rng(42)

MU = 2.0        # rata-rata waktu tunggu loket (menit)
N_ULANG = 10_000

fig, axes = plt.subplots(1, 3, figsize=(10, 3.5), constrained_layout=True)
for ax, n in zip(axes, (2, 10, 50)):
    sampel = rng.exponential(MU, size=(N_ULANG, n))
    rata = sampel.mean(axis=1)
    sigma_n = MU / np.sqrt(n)
    print(f"n = {n:>2}: rata-rata x-bar = {rata.mean():.4f} (teori {MU:.4f}), "
          f"std x-bar = {rata.std(ddof=1):.4f} (teori {sigma_n:.4f})")
    lo = max(0.0, MU - 4.5 * sigma_n)
    hi = MU + 4.5 * sigma_n
    ax.hist(rata, bins=40, range=(lo, hi), density=True,
            color="#a5b4fc", edgecolor="white")
    xs = np.linspace(lo, hi, 300)
    ax.plot(xs, stats.norm(MU, sigma_n).pdf(xs), "r-", linewidth=2,
            label="Normal teoretis")
    ax.set_title(f"n = {n}")
    ax.set_xlabel("Rata-rata sampel (menit)")
    ax.set_xlim(lo, hi)
axes[0].set_ylabel("Kepadatan")
axes[0].legend()
fig.savefig("bukti-clt-tiga-panel.png", dpi=110)n = 2: rata-rata x-bar = 1.9943 (teori 2.0000), std x-bar = 1.4211 (teori 1.4142)
n = 10: rata-rata x-bar = 2.0074 (teori 2.0000), std x-bar = 0.6363 (teori 0.6325)
n = 50: rata-rata x-bar = 1.9967 (teori 2.0000), std x-bar = 0.2813 (teori 0.2828)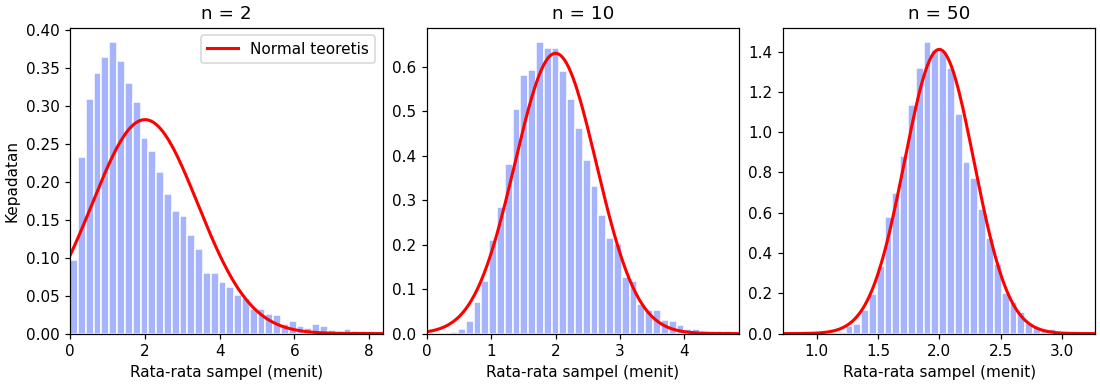
Panel masih menceng ke kanan sebagaimana populasi asalnya. Panel sudah kehilangan sebagian besar kemencangannya, sedangkan panel berbentuk lonceng yang menutupi kurva normal merahnya. Keluaran numerik menguatkan gambar tersebut, yaitu rata-rata berkumpul di sekitar 2.0000 pada ketiga ukuran, sedangkan simpangan bakunya mengikuti , dari 1.4211 pada menjadi 0.2813 pada .
Pola itulah isi teorema limit pusat. Untuk sampel acak berukuran yang anggotanya saling bebas dan berasal dari populasi dengan variansi hingga, distribusi rata-rata sampel mendekati normal dengan rata-rata dan standard error ketika membesar:
Kondisi teoremanya ringkas, yaitu observasi saling bebas, berasal dari populasi yang sama, dan populasinya memiliki variansi hingga. Sebaran waktu tunggu pada simulasi ini memenuhi ketiganya. Ekor panjang eksponensial tidak menghalangi, karena yang mendekati normal adalah rata-ratanya, bukan datanya.
Rata-rata yang normal, data yang tidak#
CLT berbicara tentang rata-rata sampel, bukan tentang data individual. Populasi eksponensial tetap menceng berapa pun banyak sampel yang diambil, karena membentuk rata-rata tidak mengubah populasi asalnya. Yang berubah hanyalah statistik yang dihitung dari setiap sampel. Perbedaan ini mudah terlewat ketika histogram rata-rata sudah berbentuk lonceng.
Skrip berikut mengukur kemencengan kedua objek tersebut pada keluaran yang sama, yaitu 10000 data individual dan 10000 rata-rata sampel berukuran 50. Sebagai acuan pembacaan, kemencengan bernilai 0 menandakan sebaran yang simetris, sedangkan nilai positif menandakan ekor kanan yang lebih panjang.
"""Kemencengan data individual dibandingkan dengan kemencengan rata-rata."""
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)

data = rng.exponential(2.0, size=10_000)
rata_50 = rng.exponential(2.0, size=(10_000, 50)).mean(axis=1)

print(f"Kemencengan data individual  : {stats.skew(data):.4f}")
print(f"Kemencengan rata-rata n = 50 : {stats.skew(rata_50):.4f}")
print(f"Perkiraan teori 2/akar(50) : {2 / np.sqrt(50):.4f}")Kemencengan data individual : 1.9891
Kemencengan rata-rata n = 50 : 0.2642
Perkiraan teori 2/akar(50) : 0.2828Kemencengan 10000 data individual tercetak 1.9891, berdekatan dengan nilai teoretis eksponensial yaitu 2. Kemencengan 10000 rata-rata berukuran 50 turun menjadi 0.2642, berdekatan dengan perkiraan . Dua angka itu berada pada keluaran yang sama tetapi menggambarkan dua objek berbeda, yaitu data dan rata-rata sampelnya. Pencampuran keduanya menjadi penyebab utama salah tafsir CLT.
Kesalahan umum#
- Menunggu data individual menjadi normal. CLT bekerja pada rata-rata sampel, sedangkan datanya tetap mengikuti populasinya. Perbaikannya, terapkan klaim normal hanya pada statistik seperti .
- Memakai CLT pada sampel yang sangat kecil. Panel pada simulasi masih jelas menceng, sehingga pendekatan normalnya kasar. Perbaikannya, perlakukan CLT sebagai pendekatan yang membaik seiring dan periksa ukuran sampelnya lebih dahulu.
- Mencampur ukuran sampel dengan jumlah pengulangan. Angka 10000 pada simulasi adalah banyaknya rata-rata yang dikumpulkan, sedangkan adalah isi setiap rata-rata. Yang mengendalikan bentuk lonceng adalah , bukan 10000.
- Mengira CLT berlaku pada semua populasi tanpa kecuali. Distribusi dengan variansi tak hingga, misalnya Cauchy, tidak menghasilkan rata-rata yang menemukan bentuk lonceng. Perbaikannya, pastikan variansi populasinya hingga sebelum mengandalkan CLT.
Ringkasan#
- Populasi eksponensial dengan rata-rata 2 menit menceng tajam, sehingga menjadi ujian yang tepat bagi CLT.
- Histogram rata-rata sampel bergeser dari menceng pada menjadi lonceng pada , dan menutupi kurva normal teoretisnya.
- Rata-rata berkumpul di sekitar , sedangkan simpangan bakunya mengikuti pada ketiga ukuran sampel.
- CLT berbicara tentang rata-rata sampel, sedangkan data individual tetap menceng sebagaimana populasinya.
Referensi#
- NumPy Generator — NumPy — Referensi resmi pembangkit acak yang menyediakan pengambilan sampel eksponensial pada simulasi.
- scipy.stats.skew — SciPy — Dokumentasi resmi pengukur kemencengan yang dipakai pada verifikasi kedua objek.
- Normal Distribution — NIST/SEMATECH e-Handbook of Statistical Methods — Referensi sifat kurva normal yang dipakai sebagai pembanding histogram.