Satu sampel hanya memberi satu angka, sedangkan distribusi pensampelan menjawab apa yang terjadi pada angka itu apabila pengambilan sampel diulang berkali-kali. Topik ini membangun distribusi pensampelan rata-rata lewat simulasi 10000 sampel, membandingkan sebaran data individual dengan sebaran rata-ratanya, lalu memverifikasi hubungan standard error dengan rumus . Hasilnya menjadi dasar untuk melaporkan rata-rata sampel beserta ketidakpastiannya.
Distribusi pensampelan sebagai konsep#
Distribusi pensampelan (sampling distribution) adalah sebaran nilai sebuah statistik apabila pengambilan sampel diulang berkali-kali dengan ukuran yang sama. Objek yang sebarannya diamati bukan datanya, melainkan statistik yang dihitung dari setiap sampel, misalnya . Sebaran ini berbeda dari sebaran data karena data individual berayun penuh, sedangkan rata-rata saling meratakan. Satu histogram berasal dari nilai ujian per siswa, sedangkan histogram yang lain berasal dari rata-rata 50 siswa sekaligus.
Distribusi pensampelan tidak dapat diperoleh dari satu sampel secara langsung, karena satu sampel hanya menyimpan satu nilai . Simulasi menggantikan pengulangan nyata yang mustahil dilakukan, yaitu menarik ribuan sampel dari populasi yang sama lalu mengumpulkan statistiknya. Pada praktiknya, bentuk dan lebar distribusi ini diramalkan dengan teori, sedangkan simulasi berperan membuktikan ramalan tersebut.
Konsep ini berlaku untuk statistik apa pun, baik rata-rata, proporsi, maupun median, tetapi rata-rata sampel menjadi pilihan paling berguna karena rumus sebarannya sederhana. Pada konteks ujian, distribusi pensampelan menjawab pertanyaan yang muncul setiap semester, yaitu seberapa jauh rata-rata 50 siswa boleh meleset dari rata-rata populasi. Pertanyaan semacam itu tidak dapat dijawab oleh histogram data, karena histogram data tidak menyimpan informasi tentang pengulangan pengambilan sampel.
Membangun distribusi lewat simulasi#
Populasi yang dipakai adalah nilai ujian statistika dari 10000 siswa dengan model normal rata-rata 75 dan simpangan baku 10. Skrip berikut menarik 10000 sampel berukuran dengan pengembalian, menghitung setiap sampel secara vektor, lalu menggambar kedua histogram berdampingan. Kedua panel sengaja memakai sumbu horizontal yang sama agar perbandingan lebarnya adil.
Pengambilan dengan pengembalian dipilih agar sampel-sampelnya saling bebas penuh, sehingga hasilnya setara dengan menarik langsung dari distribusi populasi. Perhitungan dijalankan dalam satu panggilan rng.integers yang membentuk matriks indeks berukuran 10000 baris dan 50 kolom, kemudian rata-rata dihitung per baris dalam satu operasi. Cara ini jauh lebih cepat daripada perulangan 10000 kali, sekaligus memastikan setiap baris merupakan sampel tersendiri.
"""Histogram data individual dibandingkan dengan histogram rata-rata sampel."""
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)

# Populasi simulasi: nilai ujian statistika 10000 siswa
populasi = rng.normal(75.0, 10.0, size=10_000)
mu = np.mean(populasi)
sigma = np.std(populasi, ddof=0)

# 10000 sampel berukuran n = 50, diambil dengan pengembalian
indeks = rng.integers(0, populasi.size, size=(10_000, 50))
rata = populasi[indeks].mean(axis=1)

print(f"Parameter populasi            : mu = {mu:.4f}, sigma = {sigma:.4f}")
print(f"Rata-rata 10000 x-bar         : {rata.mean():.4f}")
print(f"SE teori sigma/akar(n)        : {sigma / np.sqrt(50):.4f}")
print(f"SE simulasi (std 10000 x-bar) : {rata.std(ddof=1):.4f}")
print(f"Simpangan baku data individu  : {populasi.std(ddof=1):.4f}")

fig, axes = plt.subplots(1, 2, figsize=(9, 4), constrained_layout=True)
axes[0].hist(populasi, bins=40, color="#93c5fd", edgecolor="white")
axes[0].set_title("Data individual (N = 10000)")
axes[0].set_xlabel("Nilai ujian")
axes[0].set_ylabel("Frekuensi")
axes[1].hist(rata, bins=40, color="#fcd34d", edgecolor="white")
axes[1].set_title("Rata-rata sampel (10000 sampel, n = 50)")
axes[1].set_xlabel("Rata-rata sampel")
axes[1].set_ylabel("Frekuensi")
for ax in axes:
    ax.set_xlim(40, 110)
fig.savefig("distribusi-pensampelan.png", dpi=110)Parameter populasi : mu = 74.8975, sigma = 10.0629
Rata-rata 10000 x-bar : 74.8930
SE teori sigma/akar(n) : 1.4231
SE simulasi (std 10000 x-bar) : 1.4150
Simpangan baku data individu : 10.0634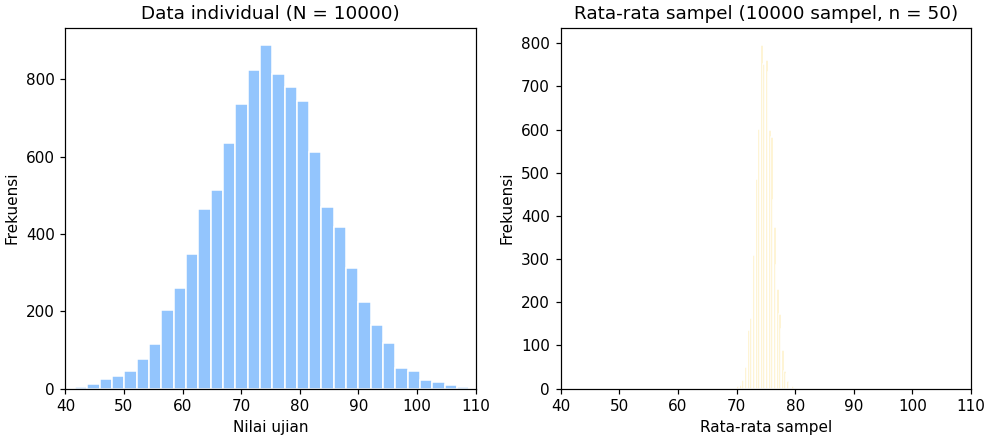
Rata-rata dari 10000 nilai tercetak 74.8930 dan berhimpitan dengan , sehingga rata-rata sampel tidak condong meleset ke satu arah. Simpangan baku data individual sebesar 10.0634, sedangkan simpangan baku 10000 rata-rata sampel hanya 1.4150, kurang lebih tujuh kali lebih kecil. Angka 1.4150 berdekatan dengan yang tercetak pada baris standard error. Gambar memperlihatkan akibatnya secara langsung, yaitu histogram rata-rata sampel berbentuk jarum sempit di sekitar 75, sedangkan histogram data membentang dari sekitar 40 sampai 110.
Standard error dan rumusnya#
Lebar distribusi pensampelan diberi nama standard error, yaitu simpangan baku sebuah statistik di banyak pengambilan ulang. Semakin kecil standard error, semakin rapat rata-rata sampel berkumpul di parameternya. Untuk rata-rata sampel yang anggotanya saling bebas, standard error dirumuskan
Rumus itu menyimpan dua pesan. Faktor pada penyebut menyebabkan pengecilan yang makin lambat, karena membagi dua standard error membutuhkan sampel empat kali lebih besar, bukan dua kali. Faktor pada pembilang menyebabkan populasi yang lebar menghasilkan rata-rata yang lebih tidak stabil. Kedua pesan itu diverifikasi pada skrip berikut untuk beberapa ukuran sampel sekaligus.
"""Standard error simulasi dibandingkan dengan rumus sigma/akar(n)."""
import numpy as np

rng = np.random.default_rng(42)
populasi = rng.normal(75.0, 10.0, size=10_000)
sigma = np.std(populasi, ddof=0)

# Sampel terpanjang dibentuk sekali, kolom awalnya dipakai untuk n lebih kecil
indeks = rng.integers(0, populasi.size, size=(10_000, 500))
sampel = populasi[indeks]

print(f"sigma populasi = {sigma:.4f}")
print(f"{'n':>4} | {'SE simulasi':>11} | {'SE teori':>8}")
for n in (10, 50, 100, 500):
    se_sim = sampel[:, :n].mean(axis=1).std(ddof=1)
    se_teo = sigma / np.sqrt(n)
print(f"{n:>4} | {se_sim:>11.4f} | {se_teo:>8.4f}")sigma populasi = 10.0629
n | SE simulasi | SE teori
10 | 3.1540 | 3.1822
50 | 1.4137 | 1.4231
100 | 1.0124 | 1.0063
500 | 0.4427 | 0.4500Kolom simulasi dan kolom teori sejajar di seluruh baris, dengan selisih kecil yang wajar untuk simulasi berukuran 10000 pengulangan. Kesesuaian itu menegaskan bahwa standard error dapat diramalkan dari dan tanpa mengulang pengambilan sampel secara nyata. Baris terakhir memperlihatkan pengecilan yang melambat, yaitu memperbesar sampel dari 100 menjadi 500 hanya menurunkan standard error dari sekitar 1.01 menjadi 0.44. Mencapai penurunan yang sama pada awal skala justru lebih murah, misalnya dari 10 menjadi 50.
Pemakaian praktisnya langsung terlihat pada pelaporan. Standard error memberi satuan jarak yang wajar bagi rata-rata sampel, karena rata-rata 50 siswa dari populasi ini diharapkan meleset sekitar 1.42 poin dari parameternya, sedangkan meleset lebih dari 2.85 poin sudah tergolong jarang. Angka sejenis inilah yang nantinya membangun interval kepercayaan dan pengujian hipotesis.
Kesalahan umum#
- Mengira simpangan baku data adalah standard error. Keduanya berbeda faktor , yaitu sekitar 7.07 pada . Perbaikannya, tetapkan lebih dahulu apakah yang dihitung sebaran datanya atau sebaran rata-ratanya.
- Membayangkan distribusi pensampelan sebagai sesuatu yang dihitung dari satu sampel. Yang dapat dihitung dari satu sampel hanyalah satu nilai statistik. Perbaikannya, ramalkan lebarnya dengan rumus dan gunakan simulasi sebagai pembuktiannya.
- Memperbanyak pengulangan simulasi untuk memperkecil standard error. Jumlah pengulangan hanya menghaluskan peta distribusinya, sedangkan lebarnya ditentukan oleh . Perbaikannya, perbesar ukuran sampel bila standard error yang lebih kecil diinginkan.
Ringkasan#
- Distribusi pensampelan adalah sebaran nilai statistik di banyak pengambilan ulang, bukan sebaran data satu sampel.
- Simulasi 10000 sampel berukuran 50 menghasilkan rata-rata sebesar 74.8930 yang berhimpitan dengan , dengan simpangan baku antarrata-rata 1.4150.
- Nilai 1.4150 sejajar dengan rumus , dan kesesuaiannya berulang pada .
- Standard error mengecil sebanding , sehingga perbaikannya makin lambat seiring membesarnya sampel.
Referensi#
- NumPy Generator — NumPy — Referensi resmi pembangkit acak yang dipakai menarik 10000 sampel secara vektor.
- OpenIntro Statistics — OpenIntro — Buku terbuka yang membahas distribusi sampel, standard error, dan perannya dalam inferensi.