Angka yang paling sering salah dibaca pada laporan statistik adalah p-value. Topik ini membangun maknanya dari bawah, yaitu menghitung statistik uji (test statistic) dari data, membangun distribusi nol (null distribution) lewat simulasi, lalu menetapkan p-value sebagai posisi data teramati pada distribusi itu. Benang data metode belajar A dan metode B dipakai kembali, kini untuk menilai apakah selisih rata-rata 1.88 poin masih wajar terjadi bila hipotesis nol benar. Pada akhir topik, p-value dapat dibaca sesuai definisinya dan sejumlah tafsir keliru yang menyebar dapat dikenali.
Statistik uji sebagai jarak dari hipotesis nol#
Statistik uji adalah bilangan tunggal yang dihitung dari data sampel untuk mengukur seberapa jauh data menyimpang dari apa yang dinyatakan oleh hipotesis nol. Untuk perbandingan dua rata-rata, statistik uji paling sederhana adalah selisih rata-rata kedua kelompok sebagai berikut.
Data contoh memberikan . Nilai 1.88 sendirian belum bermakna karena tidak ada patokan, sebagaimana angka curah hujan 30 milimeter tidak bermakna tanpa mengetahui curah hujan yang biasa terjadi di daerah itu. Patokan yang diperlukan adalah sebaran nilai yang wajar terjadi ketika benar, dan sebaran itulah yang dinamakan distribusi nol. Uji t formal nantinya menstandarkan selisih ini dengan simpangan baku, tetapi idenya tetap sama, yaitu membandingkan data teramati dengan sebaran yang diharapkan di bawah .
Membangun distribusi nol lewat simulasi#
Distribusi nol adalah sebaran statistik uji yang muncul ketika benar, yaitu ketika kedua kelompok benar-benar berasal dari populasi yang sama. Cara paling langsung untuk melihatnya adalah mensimulasikan banyak eksperimen dalam dunia yang -nya benar, menghitung selisih rata-rata pada setiap eksperimen, lalu mengumpulkan semua selisih itu. Populasi simulasi memakai rata-rata yang sama untuk kedua kelompok, sedangkan sebarannya diestimasi dari simpangan baku gabungan kedua kelompok sampel karena populasi sesungguhnya tidak diketahui. Program berikut menjalankan 10.000 eksperimen semacam itu dan menghitung p-value dari posisi data teramati.
import numpy as np
import matplotlib.pyplot as plt

# Data teramati: nilai ujian metode belajar A dan B (25 peserta per kelompok)
rng = np.random.default_rng(42)
nilai_a = np.round(rng.normal(72, 8, size=25))
nilai_b = np.round(rng.normal(72, 8, size=25))
d_obs = nilai_b.mean() - nilai_a.mean()

# Sebaran populasi tidak diketahui, sehingga diestimasi dari kedua kelompok
sd_gabungan = np.sqrt((nilai_a.var(ddof=1) + nilai_b.var(ddof=1)) / 2)

# 10.000 eksperimen ketika H0 benar: kedua kelompok dari populasi yang sama
rng_nol = np.random.default_rng(43)
eksperimen = rng_nol.normal(72, sd_gabungan, size=(10000, 50))
d_nol = eksperimen[:, :25].mean(axis=1) - eksperimen[:, 25:].mean(axis=1)

p_simulasi = np.mean(np.abs(d_nol) >= abs(d_obs))
print(f"Selisih teramati              : {d_obs:.4f}")
print(f"Simpangan baku gabungan       : {sd_gabungan:.4f}")
print(f"Distribusi nol (10.000 ulang) : rata-rata = {d_nol.mean():.4f}, simpangan baku = {d_nol.std(ddof=1):.4f}")
print(f"p-value                       : {p_simulasi:.4f}")

fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.hist(d_nol, bins=40, color="#4c72b0", edgecolor="white", label="Distribusi nol")
ax.axvspan(d_obs, d_nol.max(), color="#c44e52", alpha=0.3)
ax.axvspan(d_nol.min(), -d_obs, color="#c44e52", alpha=0.3)
ax.axvline(d_obs, color="#c44e52", linestyle="--", label=f"Selisih teramati = {d_obs:.2f}")
ax.axvline(-d_obs, color="#c44e52", linestyle="--")
ax.set_title("Distribusi nol selisih rata-rata")
ax.set_xlabel("Selisih rata-rata (poin)")
ax.set_ylabel("Frekuensi")
ax.legend()
fig.savefig("histogram-distribusi-nol.png", dpi=110)Selisih teramati : 1.8800
Simpangan baku gabungan : 6.1432
Distribusi nol (10.000 ulang) : rata-rata = -0.0034, simpangan baku = 1.7231
p-value : 0.2779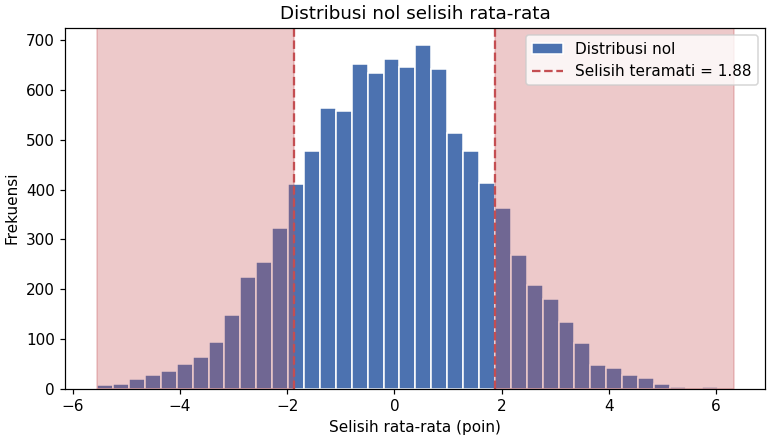
Keluaran memperlihatkan distribusi nol dengan rata-rata dekat 0 dan simpangan baku 1.7231. Histogram pada gambar menempatkan selisih teramati 1.88 di wilayah batang yang masih tinggi, sehingga selisih sebesar itu sering terjadi di dunia . Wilayah merah pada gambar menandai eksperimen simulasi yang selisihnya seekstrem data teramati, dan proporsinya dilaporkan sebagai p-value.
Definisi p-value#
Dengan distribusi nol di tangan, p-value dapat dinyatakan secara formal. Misalkan adalah selisih rata-rata pada dunia ketika benar dan adalah selisih yang teramati dari data.
Definisi ini membaca p-value sebagai peluang bersyarat, yaitu peluang melihat statistik uji sekurang-kurangnya seekstrem data yang ada dengan syarat benar. Pada simulasi sebelumnya, peluang itu diestimasi dengan proporsi sederhana, yaitu 2.779 dari 10.000 eksperimen, sehingga . Angka ini besar karena 27.79 persen eksperimen yang -nya benar menghasilkan selisih sekurang-kurangnya 1.88 poin. p-value kecil berarti data teramati terletak di wilayah yang jarang terjadi di dunia , dan kalimat itu tetap tidak menyentuh kebenaran itu sendiri.
Apa yang bukan p-value#
Tafsir keliru yang paling menyebar adalah membaca p-value sebagai peluang benar. Definisi pada bagian sebelumnya menunjukkan sebabnya, yaitu p-value dihitung dengan mengandaikan benar, sehingga angkanya berbicara tentang data, bukan tentang kebenaran . Perbedaan arahnya halus tetapi menentukan, karena peluang data di dunia tidak sama dengan peluang dunia dilihat dari data. Daftar berikut memisahkan makna asli p-value dari tafsir yang salah.
- p-value bukan peluang benar, dan juga bukan peluang salah.
- p-value bukan ukuran besar efek, karena efek kecil dapat memberikan p-value kecil apabila sampelnya besar.
- p-value bukan ukuran kepentingan praktis, karena penilaian kepentingan memerlukan besaran efek dan konteks bidangnya.
- p-value bukan peluang hasil yang sama muncul apabila eksperimen diulang.
Daftar di atas juga menjelaskan mengapa dua studi dengan p-value sama dapat berbicara tentang efek yang sangat berbeda. p-value hanya menyatakan satu hal, yaitu seberapa tidak lazim data teramati di dunia . Hal lain yang ingin disimpulkan memerlukan ukuran lain di luar p-value.
Kesalahan umum#
Kesalahan pertama adalah membandingkan p-value dari dua analisis yang ukuran sampelnya berbeda tanpa menyebut besaran efeknya, karena p-value kecil dapat muncul dari sampel yang besar meskipun efeknya tipis. Kesalahan kedua adalah memperlakukan p = 0.049 dan p = 0.051 sebagai hasil yang berbeda kualitasnya, padahal keduanya menyampaikan bukti yang nyaris sama dan garis ambangnya semata kebijakan. Kesalahan ketiga adalah menambah sampel sedikit demi sedikit sampai p-value menembus ambang tanpa melaporkan proses itu, karena penghentian pengumpulan data di tengah jalan menggelembungkan peluang hasil palsu. Kebiasaan pendamping yang sehat adalah mencatat jumlah pengujian yang dilakukan, karena banyak pengujian pada data yang sama menaikkan peluang sekurang-kurangnya satu hasil signifikan karena kebetulan. Perbaikan umumnya sama, yaitu menetapkan desain dan ambang sejak awal, melaporkan p-value persis sebagaimana terhitung, dan mendampinginya dengan besaran efek.
Ringkasan#
- Statistik uji meringkas data menjadi satu bilangan yang mengukur jarak dari , dan selisih rata-rata adalah bentuknya yang paling sederhana.
- Distribusi nol berisi nilai statistik uji yang wajar ketika benar dan dapat dibangun lewat simulasi 10.000 eksperimen.
- p-value adalah peluang melihat statistik uji sekurang-kurangnya seekstrem data teramati dengan syarat benar, dan contoh ini menghasilkan p = 0.2779.
- p-value bukan peluang benar, bukan ukuran besar efek, dan bukan ukuran kepentingan praktis.
Referensi#
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika yang membahas p-value beserta salah tafsirnya.
- numpy.random.Generator — NumPy — Dokumentasi generator angka acak NumPy yang dipakai untuk mensimulasikan distribusi nol.
- NIST/SEMATECH e-Handbook of Statistical Methods — NIST — Panduan resmi NIST yang membahas makna p-value pada pengujian hipotesis.