Rencana penelitian yang baik menghitung peluang berhasil mendeteksi efek sebelum data dikumpulkan, bukan setelah pengujian selesai. Topik ini membahas kekuatan statistik (statistical power) sebagai peluang menolak hipotesis nol ketika hipotesis nol memang salah, beserta simulasi yang menghitungnya untuk berbagai kombinasi ukuran sampel dan besar efek. Kurva hasilnya menjadi dasar perencanaan ukuran sampel, termasuk alasan efek yang kecil menuntut sampel yang besar.
Kekuatan sebagai peluang deteksi#
Kekuatan statistik adalah peluang pengujian menolak pada kondisi salah, dan hubungannya dengan error tipe II dituliskan sebagai berikut.
Error tipe II adalah gagal menolak yang salah dengan peluang , sehingga kekuatan adalah sisa peluangnya, yaitu keberhasilan mendeteksi efek yang sungguh ada. Nilai 0.8 menjadi konvensi yang umum, bermakna delapan dari sepuluh pengujian pada desain yang sama berhasil mendeteksi efek yang benar-benar ada. Kekuatan bergantung pada tiga besaran, yaitu besar efek, ukuran sampel, dan , dan dua di antaranya sepenuhnya berada di tangan perancang desain, sedangkan besar efeknya diperkirakan dari literatur. Gambar berikut memperlihatkan ketiga wilayah keputusan pada sumbu statistik uji, yaitu ekor kanan distribusi nol sebagai wilayah , bagian distribusi alternatif yang berada di kiri ambang sebagai wilayah , dan sisanya sebagai wilayah kekuatan.
Kurva biru adalah distribusi nol yang puncaknya berada di nol, sedangkan kurva hijau adalah distribusi statistik uji ketika efek sungguhan ada sehingga puncaknya tergeser ke kanan. Menyempitkan menggeser ambang ke kanan, menjauhi puncak distribusi nol, dan memperlebar wilayah , persis kompromi antara kedua jenis error. Cara untuk memperkecil kedua wilayah sekaligus hanyalah memisahkan kedua kurva atau menajamkan bentuknya, dan keduanya diperoleh dari efek yang lebih besar atau sampel yang lebih banyak.
Simulasi kekuatan#
Kekuatan tidak perlu dihitung dari rumus distribusi t, karena simulasi langsung memberikan angkanya. Program berikut mengulang 5.000 eksperimen untuk setiap kombinasi besar efek dan ukuran sampel . Setiap eksperimen dianalisis dengan uji t pada , lalu proporsi p-value di bawah 0.05 dilaporkan sebagai estimasi kekuatan. Satu generator acak dengan benih tetap dipakai untuk seluruh kombinasi agar hasilnya dapat direproduksi.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Simulasi kekuatan: banyaknya eksperimen ketika H0 salah untuk tiap (d, n)
rng = np.random.default_rng(42)
N_SIM = 5000
DAFTAR_N = [20, 50, 100, 200, 400, 800]
DAFTAR_D = [0.2, 0.5, 0.8]

hasil = {}
for d in DAFTAR_D:
    for n in DAFTAR_N:
        sampel = rng.normal(0, 1, size=(N_SIM, 2 * n))
        sampel[:, n:] += d
        p = stats.ttest_ind(sampel[:, :n], sampel[:, n:], axis=1).pvalue
        kekuatan = np.mean(p < 0.05)
        hasil[(d, n)] = kekuatan
        print(f"d = {d:.1f}, n = {n:3d} : kekuatan = {kekuatan:.4f}")

fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
for d, warna in zip(DAFTAR_D, ("#4c72b0", "#55a868", "#c44e52")):
    kekuatan = [hasil[(d, n)] for n in DAFTAR_N]
    ax.plot(DAFTAR_N, kekuatan, marker="o", color=warna, label=f"d = {d}")
ax.axhline(0.8, color="gray", linestyle="--", linewidth=1, label="Ambang 0.8")
ax.set_title("Kekuatan statistik menurut ukuran sampel")
ax.set_xlabel("Banyaknya peserta per kelompok (n)")
ax.set_ylabel("Kekuatan statistik")
ax.set_ylim(0, 1.02)
ax.legend()
fig.savefig("kurva-kekuatan.png", dpi=110)d = 0.2, n = 20 : kekuatan = 0.0924
d = 0.2, n = 50 : kekuatan = 0.1682
d = 0.2, n = 100 : kekuatan = 0.2994
d = 0.2, n = 200 : kekuatan = 0.5218
d = 0.2, n = 400 : kekuatan = 0.8040
d = 0.2, n = 800 : kekuatan = 0.9810
d = 0.5, n = 20 : kekuatan = 0.3364
d = 0.5, n = 50 : kekuatan = 0.7050
d = 0.5, n = 100 : kekuatan = 0.9432
d = 0.5, n = 200 : kekuatan = 0.9986
d = 0.5, n = 400 : kekuatan = 1.0000
d = 0.5, n = 800 : kekuatan = 1.0000
d = 0.8, n = 20 : kekuatan = 0.6874
d = 0.8, n = 50 : kekuatan = 0.9756
d = 0.8, n = 100 : kekuatan = 0.9992
d = 0.8, n = 200 : kekuatan = 1.0000
d = 0.8, n = 400 : kekuatan = 1.0000
d = 0.8, n = 800 : kekuatan = 1.0000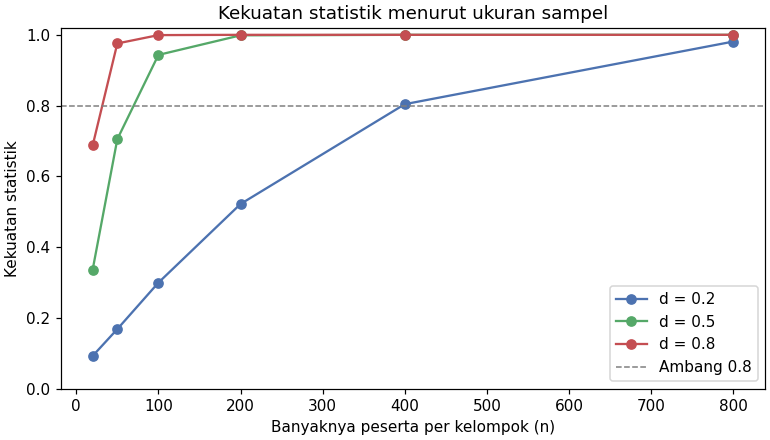
Hasilnya menegaskan tiga pola, yaitu kekuatan naik ketika sampel bertambah, kekuatan naik ketika efek membesar, dan tidak semua kombinasi mencapai ambang 0.8. Efek besar sudah mencapai kekuatan 0.6874 pada 20 peserta per kelompok, sedangkan efek kecil baru mencapai 0.8040 pada 400 peserta per kelompok.
Perencanaan ukuran sampel#
Kurva pada gambar dibaca mundur untuk perencanaan, yaitu menetapkan kekuatan minimal lalu mencari ukuran sampel yang mencapainya. Untuk ambang kekuatan 0.8, efek sedang mencapainya di antara 50 dan 100 peserta per kelompok, sedangkan efek kecil memerlukan sekitar 400 peserta per kelompok. Efek kecil menuntut sampel besar karena selisih rata-ratanya kecil dibandingkan sebaran acaknya, sehingga dibutuhkan banyak pengamatan sebelum pola itu menonjol dari derau. Perhitungan ini dilakukan sebelum pengumpulan data, karena setelah pengujian selesai dan gagal mendeteksi, desainnya sudah tidak dapat diselamatkan.
Pada praktiknya, analisis kekuatan menjadi bagian dari proposal penelitian, yaitu mengestimasi dari literatur atau penelitian pendahuluan, menetapkan dan kekuatan minimal, lalu membaca ukuran sampel yang diperlukan. Estimasi yang terlalu optimis adalah jebakan yang paling sering terjadi, karena efek kecil yang diabaikan membuat sampel yang direncanakan jauh dari cukup.
Kesalahan umum#
Kesalahan pertama adalah menjalankan pengujian dengan sampel yang kekuatannya rendah lalu menyimpulkan tidak ada efek ketika tidak tertolak, padahal desain itu memang hampir tidak mampu mendeteksi apa pun. Kesalahan kedua adalah mengambil estimasi besar efek dari studi yang paling berhasil dilaporkan di literatur, karena nilai tersebut cenderung membesar dan membuat ukuran sampel yang dihitung terlalu kecil. Kesalahan ketiga adalah memperbanyak pengujian untuk mengobati kekuatan yang rendah, misalnya menguji banyak variabel sekaligus, karena kebiasaan itu menggelembungkan peluang hasil palsu. Rencana yang jujur menyebut satu efek utama, satu , dan satu ukuran sampel yang dihitung dari ketiganya.
Ringkasan#
- Kekuatan statistik adalah peluang menolak ketika salah, yaitu , dan konvensinya menargetkan 0.8.
- Kekuatan naik dengan ukuran sampel, besar efek, dan yang lebih longgar, dan simulasi 5.000 eksperimen per kombinasi menghasilkan kurvanya.
- Untuk kekuatan 0.8, contoh ini memerlukan sekitar 400 peserta per kelompok pada dan di antara 50 hingga 100 peserta pada .
- Analisis kekuatan adalah alat perencanaan sebelum data dikumpulkan, terutama untuk mencegah kesimpulan tidak ada efek pada desain yang lemah.
Referensi#
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika dengan pembahasan kekuatan uji dan perencanaan ukuran sampel.
- NIST/SEMATECH e-Handbook of Statistical Methods — NIST — Panduan resmi NIST yang membahas hubungan ukuran sampel dengan kekuatan uji.
- scipy.stats.ttest_ind — SciPy — Dokumentasi uji t dua sampel yang dipakai pada setiap eksperimen simulasi.