p-value yang kecil menjawab pertanyaan tentang kebetulan, tetapi tidak menjawab pertanyaan tentang besarnya perbedaan. Topik ini membahas besaran efek (effect size) sebagai ukuran standar atas besar efek, memperkenalkan Cohen’s d sebagai contoh yang paling umum, dan menunjukkan dengan simulasi mengapa hasil yang signifikan belum tentu penting. Contoh metode belajar dipakai kembali dalam dua ukuran sampel yang berbeda jauh, yaitu 25 dan 400 peserta per kelompok, sehingga peran ukuran sampel terhadap p-value terlihat langsung.
Definisi Cohen’s d#
Cohen’s d menyatakan selisih dua rata-rata dalam satuan simpangan baku gabungan, sehingga besar efek tidak lagi terikat pada satuan pengukuran maupun ukuran sampel. Rumusnya sebagai berikut, dengan sebagai simpangan baku gabungan (pooled standard deviation) kedua kelompok.
Pada data metode belajar dengan 25 peserta per kelompok, selisih rata-rata 1.88 poin dibagi simpangan baku gabungan 6.1432 menghasilkan . Nilai itu terbaca sebagai efek setinggi 0.31 simpangan baku, dan pembacaannya tetap sama apakah datanya poin nilai ujian, menit, atau kilogram. Pembagian dengan inilah yang membedakan besaran efek dari statistik uji mentah. Karena penyebutnya adalah simpangan baku, angka dari dua studi yang berbeda satuan dapat diletakkan berdampingan.
Pedoman interpretasi#
Jacob Cohen mengusulkan pedoman interpretasi yang dipakai luas sebagai titik awal pembicaraan, dan tabel berikut merangkumnya.
| Nilai d | Sebutan | Gambaran |
|---|---|---|
| 0.2 | kecil | kedua distribusi masih tumpang tindih lebar |
| 0.5 | sedang | beda terlihat jelas tetapi kedua kelompok masih bersinggungan |
| 0.8 | besar | kedua distribusi cukup terpisah |
Pedoman ini bersifat kasar dan menuntut kualifikasi konteks. Ambang 0.2, 0.5, dan 0.8 berasal dari tradisi psikologi, sedangkan bidang lain menetapkan ambangnya sendiri menurut konsekuensi praktisnya. Kenaikan hasil panen antara dua perlakuan pupuk sebesar 0.2 simpangan baku, misalnya, dapat berarti sangat banyak secara ekonomi. Pedoman tersebut juga mengandaikan sebaran kedua kelompok serupa, sehingga satu simpangan baku gabungan mewakili keduanya secara adil. Semakin kecil , semakin lebar kawasan tumpang tindih kedua distribusi, dan wujudnya diperlihatkan oleh gambar pada bagian berikutnya.
Signifikan tetapi kecil#
Program berikut membandingkan dua pengujian yang selisih rata-ratanya nyaris sama besar. Pengujian pertama menggunakan data metode belajar dengan 25 peserta per kelompok. Pengujian kedua menggunakan simulasi dua kelompok besar dengan 400 peserta per kelompok dan selisih populasi 2 poin. Cohen’s d dihitung dengan fungsi terpisah agar rumusnya terlihat jelas, sedangkan p-value dihitung dengan uji t dua sampel bebas.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats


def cohens_d(x, y):
    """Cohen's d dengan simpangan baku gabungan (pooled) dua kelompok."""
    nx, ny = len(x), len(y)
    s = np.sqrt(((nx - 1) * x.var(ddof=1) + (ny - 1) * y.var(ddof=1)) / (nx + ny - 2))
    return (y.mean() - x.mean()) / s


# Kasus 1: dua kelompok kecil (n = 25 per kelompok), selisih rata-rata sekitar 2 poin
rng = np.random.default_rng(42)
nilai_a = np.round(rng.normal(72, 8, size=25))
nilai_b = np.round(rng.normal(72, 8, size=25))
t1, p1 = stats.ttest_ind(nilai_b, nilai_a)

# Kasus 2: dua kelompok besar (n = 400 per kelompok), selisih populasi 2 poin
rng_besar = np.random.default_rng(43)
besar_a = rng_besar.normal(75, 10, size=400)
besar_b = rng_besar.normal(77, 10, size=400)
t2, p2 = stats.ttest_ind(besar_b, besar_a)

print(f"Kasus 1 (n = 25) : selisih = {nilai_b.mean() - nilai_a.mean():.4f}, p-value = {p1:.4f}, d = {cohens_d(nilai_a, nilai_b):.4f}")
print(f"Kasus 2 (n = 400): selisih = {besar_b.mean() - besar_a.mean():.4f}, p-value = {p2:.4f}, d = {cohens_d(besar_a, besar_b):.4f}")

# Ilustrasi tumpang tindih dua distribusi pada d = 0.2 dan d = 0.8
x = np.linspace(-4, 5, 400)


def pdf(m, s):
    return np.exp(-((x - m) ** 2) / (2 * s ** 2)) / (s * np.sqrt(2 * np.pi))


fig, axes = plt.subplots(1, 2, figsize=(7, 3.2), constrained_layout=True, sharey=True)
for ax, d, nama in zip(axes, (0.2, 0.8), ("kecil", "besar")):
    ax.plot(x, pdf(0, 1), color="#4c72b0", label="Kelompok A")
    ax.plot(x, pdf(d, 1), color="#dd8452", label="Kelompok B")
    ax.fill_between(x, pdf(0, 1), color="#4c72b0", alpha=0.2)
    ax.fill_between(x, pdf(d, 1), color="#dd8452", alpha=0.2)
    ax.set_title(f"d = {d} (efek {nama})")
    ax.set_xlabel("Nilai")
axes[0].set_ylabel("Kepadatan")
axes[1].legend(loc="upper right")
fig.savefig("dua-besaran-efek.png", dpi=110)Kasus 1 (n = 25) : selisih = 1.8800, p-value = 0.2847, d = 0.3060
Kasus 2 (n = 400): selisih = 1.8751, p-value = 0.0093, d = 0.1845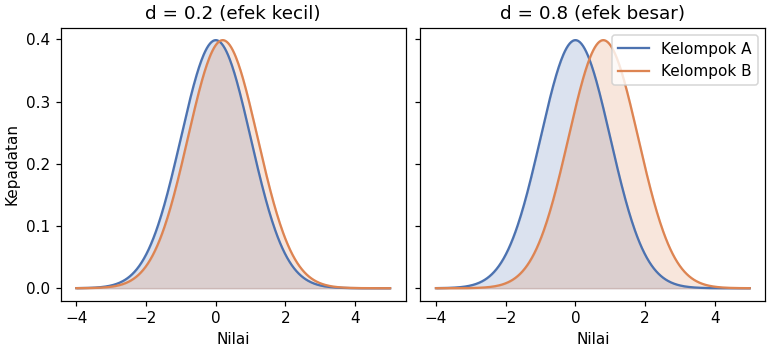
Kedua kasus memuat selisih rata-rata yang hampir identik, yaitu 1.8800 dan 1.8751 poin, tetapi keputusannya berhadapan. Kasus pertama tidak signifikan karena pada sampel kecil, sedangkan kasus kedua signifikan karena pada sampel besar. Besaran efeknya justru berlawanan arah dengan keputusannya, yaitu 0.3060 pada kasus yang tidak signifikan dan 0.1845 pada kasus yang signifikan. Gambar dua panel memperlihatkan sebabnya, yaitu distribusi pada masih tumpang tindih lebar, sehingga efeknya sungguh ada tetapi kecil.
Signifikan bukan penting#
p-value menggabungkan dua informasi sekaligus, yaitu besar efek dan presisi estimasi yang bergantung pada ukuran sampel, sehingga p-value kecil dapat lahir dari efek kecil pada sampel yang sangat besar. Besaran efek memisahkan kedua informasi itu dengan membagi selisihnya oleh sebaran, sehingga angka dapat dibandingkan antarstudi dan antarbidang. Kasus kedua pada bagian sebelumnya adalah contoh lengkapnya, yaitu yang signifikan sambil membawa yang kecil, dan kepentingan keunggulan sekitar 2 poin itu tidak diputuskan oleh p-value. Penilaian kepentingan praktis menuntut konteks, misalnya biaya penerapan metode baru dibandingkan keuntungan dua poin nilai ujian.
Laporan yang utuh menyebut keduanya, yaitu p-value untuk keputusan tentang kebetulan dan besaran efek untuk keputusan tentang besar.
Kesalahan umum#
Kesalahan pertama adalah memperlakukan 0.2, 0.5, dan 0.8 sebagai batas mutlak yang memutus kepentingan, padahal ketiganya pedoman kasar yang harus digeser menurut konsekuensi praktis bidangnya. Kesalahan kedua adalah membandingkan antarstudi yang satuan atau populasinya berbeda tanpa memeriksa simpangan bakunya, karena pembagi yang berbeda membuat angka tidak lagi sebanding. Kesalahan ketiga adalah melaporkan p-value tanpa besaran efek, sehingga pembaca laporan tidak dapat menilai besar kecilnya keunggulan yang ditemukan. Kebiasaan pelaporan yang baik menutup ketiganya, yaitu menyebut selisih mentah, besaran efek, dan ukuran sampel dalam satu baris yang sama.
Ringkasan#
- Besaran efek menyatakan besar efek dalam satuan sebaran, dan Cohen’s d adalah selisih rata-rata dibagi simpangan baku gabungan.
- Pedoman interpretasi lazim menempatkan 0.2 kecil, 0.5 sedang, dan 0.8 besar, dengan kualifikasi konteks bidang.
- Dua kasus dengan selisih nyaris sama memberikan p = 0.2847 pada n = 25 dan p = 0.0093 pada n = 400, sedangkan d-nya 0.3060 dan 0.1845.
- p-value yang signifikan tidak menjamin efeknya penting, sehingga laporan menyertakan besaran efek bersama p-value.
Referensi#
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika yang membahas besaran efek dan hubungannya dengan kekuatan uji.
- scipy.stats.ttest_ind — SciPy — Dokumentasi uji t dua sampel yang dipakai untuk menghitung p-value pada contoh.
- numpy.random.Generator — NumPy — Dokumentasi generator acak NumPy untuk simulasi kelompok besar.