Istilah frequentist dan Bayesian menandai dua kerangka inferensi (inference) yang memandang peluang dan parameter secara berbeda. Topik ini membandingkan keduanya secara jujur, yaitu menunjukkan pertanyaan yang dijawab masing-masing, keluaran yang dihasilkan, dan biaya komputasinya. Satu data uji mutu kemudian dianalisis dengan dua cara sekaligus, sehingga persamaan dan perbedaan keduanya terlihat pada angka yang nyata dan bukan pada klaim.
Dua pertanyaan yang berbeda#
Kerangka frequentist memperlakukan parameter sebagai konstanta tetap yang nilainya tidak diketahui, sedangkan peluangnya didefinisikan sebagai frekuensi jangka panjang atas pengulangan prosedur. Inferensinya menyatakan seberapa wajar data teramati apabila hipotesis nol benar, dan keluarannya berupa p-value serta interval kepercayaan. Kerangka Bayesian memperlakukan parameter sebagai besaran tidak pasti yang distribusinya diperbarui, dimulai dari prior sebagai keyakinan awal dan diakhiri posterior beserta ringkasannya.
Tabel berikut merangkum perbedaan yang paling menentukan pilihan kerangka.
| Aspek | Frequentist | Bayesian |
|---|---|---|
| Pertanyaan yang dijawab | Seberapa wajar data apabila hipotesis nol benar | Bagaimana distribusi parameter setelah data teramati |
| Makna peluang | Frekuensi jangka panjang atas pengulangan | Derajat keyakinan yang dapat melekat pada parameter |
| Peran prior | Tidak dipakai, informasi seluruhnya dari data sampel | Dipakai eksplisit dan berpengaruh pada sampel kecil |
| Keluaran utama | Estimasi titik, interval kepercayaan, p-value | Distribusi posterior, interval kredibel |
| Biaya komputasi | Umumnya ringan karena memakai rumus distribusi baku | Lebih berat karena menuntut integrasi numerik atau kisi |
Perbedaan yang paling kasat terletak pada makna peluang dan peran prior, karena dua perbedaan itulah yang menggerakkan sisa barisnya. Biaya komputasi yang lebih berat pada sisi Bayesian juga perlu dibaca secara proporsional, sebab untuk satu parameter seperti proporsi, kisi seribu titik yang dipakai sepanjang modul ini berjalan dalam hitungan detik. Komputasi yang menuntut adalah kasus parameter banyak, ketika kisi tidak lagi mungkin dan metode penitihan (sampling) berantai seperti MCMC diperlukan.
Satu data, dua analisis#
Data uji mutu mesin pengepak di gudang kampus dipakai untuk kedua kerangka. Pemeriksaan perdana hanya menguji 10 komponen dan 6 di antaranya lulus, sedangkan rekap bulanan mengumpulkan 1000 komponen dengan 600 lulus. Program berikut menganalisis kedua skenario secara paralel, yaitu interval kepercayaan Wald untuk sisi frequentist dan posterior kisi dengan dua pilihan prior untuk sisi Bayesian.
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

# Uji mutu mesin pengepak: setiap komponen dinyatakan lulus atau tidak lulus
theta = np.linspace(0.0, 1.0, 1000)

def posterior_kisi(y, n, prior):
    """Posterior grid dari likelihood Binomial dan prior yang diberikan."""
    p = prior * stats.binom.pmf(y, n, theta)
    return p / np.trapezoid(p, theta)

def interval_kisi(densitas):
    """Kuantil 2.5% dan 97.5% dari kurva pada kisi lewat interpolasi CDF."""
    cdf = np.concatenate(([0.0], np.cumsum((densitas[1:] + densitas[:-1]) / 2 * np.diff(theta))))
    return np.interp(0.025, cdf, theta), np.interp(0.975, cdf, theta)

# Prior uniform menolak mengistimewakan nilai apa pun, sedangkan Beta(2,2)
# berkonsentrasi di sekitar 0.5 dengan kekuatan setara sekitar empat pengamatan
prior_uniform = np.ones_like(theta)
prior_informatif = stats.beta.pdf(theta, 2, 2)

# Skenario kecil dari pemeriksaan perdana, skenario besar dari rekap bulanan
skenario = [(6, 10), (600, 1000)]
for y, n in skenario:
    phat = y / n
    se = np.sqrt(phat * (1 - phat) / n)
    print(f"Skenario n = {n}, y = {y}")
    print(f"  Frequentist Wald  : estimasi {phat:.4f}, interval 95% = [{phat - 1.96 * se:.4f}, {phat + 1.96 * se:.4f}]")
    for nama, prior in [("uniform", prior_uniform), ("Beta(2,2)", prior_informatif)]:
        post = posterior_kisi(y, n, prior)
        bawah, atas = interval_kisi(post)
        rerata = np.trapezoid(theta * post, theta)
        print(f"  Bayesian {nama:9s}: rerata {rerata:.4f}, kredibel 95% = [{bawah:.4f}, {atas:.4f}]")

# Gambar dua panel: pengaruh prior pada sampel kecil dan sampel besar
fig, axes = plt.subplots(1, 2, figsize=(7, 3.6), constrained_layout=True)
for ax, (y, n) in zip(axes, skenario):
    post_u = posterior_kisi(y, n, prior_uniform)
    post_i = posterior_kisi(y, n, prior_informatif)
    ax.plot(theta, post_u, color="#4c72b0", linewidth=2, label="Prior uniform")
    ax.plot(theta, post_i, color="#dd8452", linewidth=2, linestyle="--", label="Prior Beta(2,2)")
    ax.set_title(f"n = {n}, y = {y}")
    ax.set_xlabel("Nilai theta (proporsi lulus)")
    ax.set_ylabel("Densitas")
axes[0].legend()
fig.suptitle("Pengaruh prior menyusut seiring bertambahnya data")
fig.savefig("dua-prior.png", dpi=110)Skenario n = 10, y = 6
Frequentist Wald : estimasi 0.6000, interval 95% = [0.2964, 0.9036]
Bayesian uniform : rerata 0.5833, kredibel 95% = [0.3079, 0.8325]
Bayesian Beta(2,2): rerata 0.5714, kredibel 95% = [0.3158, 0.8078]
Skenario n = 1000, y = 600
Frequentist Wald : estimasi 0.6000, interval 95% = [0.5696, 0.6304]
Bayesian uniform : rerata 0.5998, kredibel 95% = [0.5693, 0.6300]
Bayesian Beta(2,2): rerata 0.5996, kredibel 95% = [0.5691, 0.6297]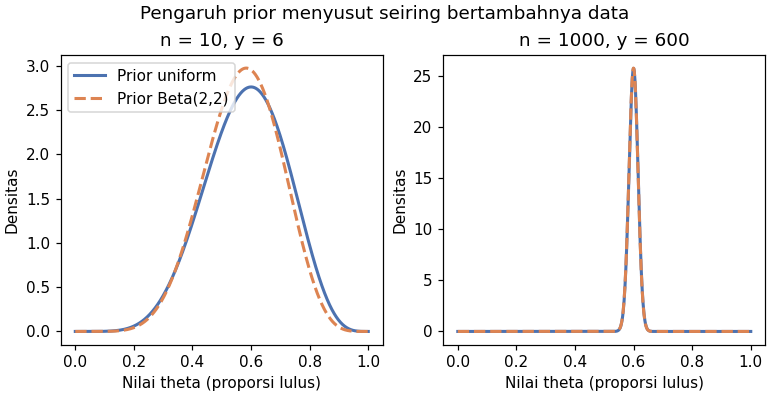
Pada skenario n = 10, ketiga baris memberi jawaban yang berbeda-beda. Rerata posterior dengan prior uniform tercatat 0.5833, sedangkan prior Beta(2,2) yang menarik keyakinan ke arah 0.5 menghasilkan rerata 0.5714 dan interval kredibel yang lebih sempit. Ketiga interval sama-sama memuat nilai di sekitar 0.6, tetapi lebar dan letaknya menunjukkan bahwa pilihan prior sungguh memengaruhi hasil pada sampel kecil.
Pada skenario n = 1000, perbedaan itu nyaris tidak terlihat. Rerata posterior hanya bergeser 0.0002 di antara kedua prior, dan interval kredibelnya berimpit dengan interval Wald pada lebar sekitar 0.06. Gambar dua panel memperlihatkan mekanismenya, yaitu kurva biru dan kurva oranye yang terpisah jelas pada panel kiri kemudian menumpuk persis pada panel kanan. Data dalam jumlah besar menggeser pengaruh prior hingga nyaris tidak terasa, sehingga kesimpulan kedua kerangka saling menegaskan justru pada sampel besar.
Kapan prior berpengaruh kuat#
Pengaruh prior bertambah kuat pada dua kondisi yang saling menguatkan, yaitu ukuran sampel yang kecil dan prior yang tajam. Prior Beta(2,2) setara dengan informasi sekitar empat pengamatan yang menunjuk ke 0.5, sehingga pada n = 10 ia menyumbang hampir sepertiga total bobot keyakinan. Pada n = 1000, bobot empat pengamatan itu menjadi kecil dibandingkan seribu pengamatan data, dan hasilnya terbaca pada selisih rerata yang tinggal 0.0002.
Konsekuensi praktisnya ada pada kejujuran pelaporan. Pilihan prior perlu dinyatakan beserta alasannya, dan bila prior tajam dipakai pada sampel kecil, analisis kepekaan dengan membandingkan beberapa prior menjadi bagian dari laporan. Prior yang dapat dipertanggungjawabkan merupakan kekuatan kerangka Bayesian, sedangkan prior yang disembunyikan merupakan sumber bias yang sulit dideteksi.
Dua kerangka yang sama-sama sah#
Perbandingan pada topik ini tidak menghasilkan pemenang, karena keduanya menjawab pertanyaan yang memang berbeda. Kerangka frequentist menjanjikan prosedur yang andal dalam jangka panjang tanpa perlu menyatakan prior, sedangkan kerangka Bayesian memberi distribusi lengkap atas parameter dan menerima prior sebagai harga masuknya pengetahuan awal. Pilihan yang tepat mengikuti pertanyaan analisis, kebiasaan bidangnya, dan data yang tersedia.
Ringkasan#
- Kerangka frequentist membaca peluang sebagai frekuensi jangka panjang dan melaporkan estimasi titik, interval kepercayaan, serta p-value tanpa prior.
- Kerangka Bayesian membaca peluang sebagai derajat keyakinan, memutakhirkan prior menjadi posterior, dan melaporkan interval kredibel.
- Pada data 6 dari 10 lulus, dua prior berbeda memberi rerata posterior 0.5833 dan 0.5714, sedangkan pada data 600 dari 1000 selisihnya tinggal 0.0002 dan keduanya berimpit dengan interval Wald.
- Prior berpengaruh kuat pada sampel kecil dan prior tajam, sehingga pilihannya wajib dinyatakan dan diuji kepekaannya, sedangkan data dalam jumlah besar membuat pengaruhnya menyusut.
Referensi#
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika yang membahas kerangka inferensi frequentist beserta interval kepercayaan dan p-value.
- scipy.stats.beta — SciPy — Dokumentasi distribusi Beta yang dipakai untuk menyusun prior informatif pada perbandingan ini.