Statistika Bayesian memperlakukan parameter sebagai besaran yang tidak pasti, lalu memperbarui keyakinan atas nilainya setiap kali data baru dibaca. Topik ini memperkenalkan tiga komponen siklus tersebut, yaitu prior, likelihood, dan posterior, dengan parameter berupa proporsi jawaban benar seorang siswa pada soal latihan. Seluruh perhitungan dilakukan secara numerik pada kisi seribu nilai parameter , dan hasilnya diverifikasi dengan posterior analitik dari distribusi Beta.
Tiga komponen pembaruan keyakinan#
Prior adalah distribusi peluang atas parameter sebelum data diperhatikan, sedangkan likelihood adalah peluang data yang teramati apabila parameter bernilai tertentu. Hasil penggabungan keduanya disebut posterior, yaitu distribusi parameter setelah data diperhitungkan. Pada contoh berjalan, parameter adalah proporsi soal yang benar-benar dikuasai siswa, dan data berupa jawaban benar dari soal.
Ketiga komponen itu terhubung oleh Teorema Bayes, yaitu rumus yang mengubah peluang data apabila parameter diketahui menjadi distribusi parameter apabila data teramati.
Pembilang memuat sebagai prior dan sebagai likelihood, sedangkan berperan sebagai konstanta pengnormal, yaitu faktor yang membuat total luas posterior tepat 1. Karena penyebut tidak bergantung pada , posterior selalu berupa likelihood yang dilipatgandakan prior lalu dinormalisasi. Bentuk inilah yang diterjemahkan menjadi baris program pada bagian berikutnya, yaitu perkalian dua kurva diikuti pembagian dengan luasnya.
Data 17 benar dari 20 soal dimodelkan dengan distribusi Binomial, sehingga likelihood untuk satu nilai berbunyi
Prior yang dipilih adalah prior uniform, yaitu kurva konstan bernilai 1 di seluruh rentang sehingga tidak ada nilai yang diistimewakan sebelum data dibaca. Pilihan ini merupakan prior paling sederhana untuk pengenalan karena tidak membawa asumsi apa pun di luar data. Prior yang lebih informatif berbentuk distribusi Beta dipakai sebagai pembanding pada verifikasi di bagian akhir topik.
Menghitung posterior dengan kisi seribu titik#
Kisi (grid) adalah sekumpulan nilai parameter yang tersusun rapat dan merata, kemudian prior dan likelihood dihitung pada setiap nilainya. Metode ini menghindari rumus analitik sama sekali, sebab semua operasi berupa perkalian dan normalisasi pada array NumPy. Langkahnya berbunyi sebagai berikut.
- Susun kisi seribu nilai dari 0 sampai 1 dengan
np.linspace. - Hitung nilai prior dan likelihood Binomial pada setiap titik kisi.
- Kalikan keduanya, lalu bagi dengan luas hasil kalinya yang dihitung
np.trapezoid, sehingga luas posterior tepat 1. - Baca ringkasan seperti rerata, modus, dan peluang ekor langsung dari kurva posterior yang telah dinormalisasi.
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

# Data: 17 jawaban benar dari 20 soal latihan yang dikerjakan seorang siswa
y, n = 17, 20

# Grid theta: kisi seribu nilai proporsi yang tersusun rata dari 0 sampai 1
theta = np.linspace(0.0, 1.0, 1000)

# Prior uniform: setiap nilai theta dianggap sama mungkin sebelum data dibaca
prior = np.ones_like(theta)

# Likelihood Binomial: peluang memperoleh 17 benar dari 20 pada tiap theta
likelihood = stats.binom.pmf(y, n, theta)

# Posterior: hasil kali prior dan likelihood, lalu dinormalisasi agar luasnya 1
belum_normal = prior * likelihood
posterior = belum_normal / np.trapezoid(belum_normal, theta)

# Ringkasan posterior yang dibaca langsung dari grid
rerata = np.trapezoid(theta * posterior, theta)
modus = theta[np.argmax(posterior)]
ekor = np.trapezoid(posterior[theta > 0.75], theta[theta > 0.75])
print(f"Rerata posterior (grid) = {rerata:.4f}")
print(f"Modus posterior (grid)  = {modus:.4f}")
print(f"P(theta > 0.75 | data)  = {ekor:.4f}")

# Gambar tiga kurva, likelihood dibuat putus-putus karena berimpit dengan posterior
# pada prior uniform, yaitu saat perkalian prior tidak mengubah bentuk kurva
fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.plot(theta, prior, color="#999999", linewidth=2, label="Prior uniform")
ax.plot(theta, posterior, color="#4c72b0", linewidth=3, label="Posterior")
ax.plot(
    theta, likelihood / np.trapezoid(likelihood, theta),
    color="#dd8452", linewidth=2, linestyle="--", label="Likelihood (luas 1)",
)
ax.set_xlabel("Nilai theta (proporsi benar)")
ax.set_ylabel("Densitas")
ax.set_title("Prior, likelihood, dan posterior untuk 17 benar dari 20")
ax.legend()
fig.savefig("kurva-posterior.png", dpi=110)Rerata posterior (grid) = 0.8182
Modus posterior (grid) = 0.8498
P(theta > 0.75 | data) = 0.8062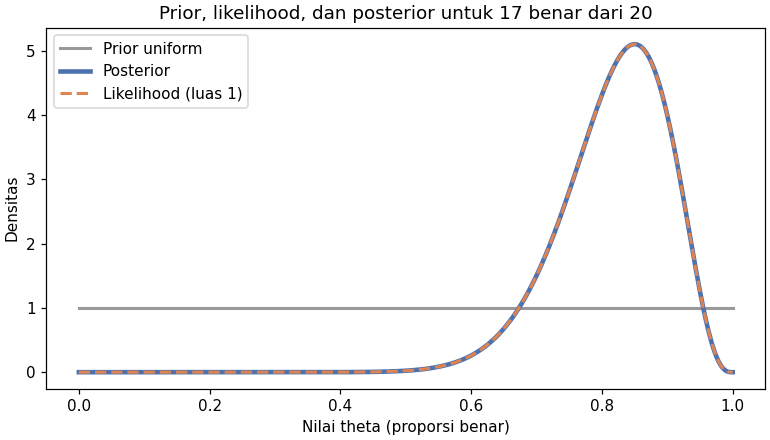
Keluaran memperlihatkan rerata posterior 0.8182, modus 0.8498, dan peluang posterior sebesar 0.8062. Pernyataan terakhir itulah jenis kalimat yang hanya mungkin pada kerangka Bayesian, yaitu peluang langsung tentang parameter setelah data diperhitungkan. Angka 0.8062 dibaca sebagai keyakinan sebesar 80.62 persen bahwa proporsi soal yang dikuasai siswa berada di atas 0.75.
Gambar memuat pelajaran tambahan tentang peran prior. Kurva posterior biru berimpit persis dengan likelihood oranye putus-putus, karena prior uniform bernilai konstan sehingga perkaliannya tidak mengubah bentuk likelihood sama sekali. Pada prior uniform, seluruh bentuk posterior berasal dari data, dan keadaan ini berubah begitu prior yang tidak datar dipakai.
Verifikasi dengan distribusi Beta#
Metode kisi memerlukan pemeriksaan silang, dan keluarga konjugat Beta-Binomial menyediakannya. Disebut konjugat karena prior dan posteriornya sama-sama berbentuk distribusi Beta. Prior uniform identik dengan distribusi Beta berparameter 1 dan 1, sehingga posterior analitiknya adalah distribusi Beta berparameter dan , yaitu Beta(18, 4) untuk data 17 benar dari 20. Skrip berikut membandingkan posterior grid dengan densitas Beta analitik pada kisi yang sama.
import numpy as np
from scipy import stats

# Data dan grid yang sama dengan posterior-grid.py
y, n = 17, 20
theta = np.linspace(0.0, 1.0, 1000)

# Posterior grid, prior uniform tidak ditulis eksplisit karena bernilai 1 di mana pun
posterior = stats.binom.pmf(y, n, theta)
posterior /= np.trapezoid(posterior, theta)

# Posterior analitik dari keluarga konjugat Beta-Binomial
a, b = 1 + y, 1 + n - y
analitik = stats.beta.pdf(theta, a, b)
ekor_grid = np.trapezoid(posterior[theta > 0.75], theta[theta > 0.75])

print(f"Posterior analitik               = Beta({a}, {b})")
print(f"Rerata analitik                  = {stats.beta.mean(a, b):.4f}")
print(f"P(theta > 0.75) grid vs analitik = {ekor_grid:.4f} vs {stats.beta.sf(0.75, a, b):.4f}")
print(f"Selisih maksimum densitas = {np.abs(posterior - analitik).max():.2e}")Posterior analitik = Beta(18, 4)
Rerata analitik = 0.8182
P(theta > 0.75) grid vs analitik = 0.8062 vs 0.8083
Selisih maksimum densitas = 1.02e-09Selisih maksimum antara densitas grid dan densitas analitik hanya , sehingga metode kisi terbukti mereproduksi posterior Beta(18, 4) dengan sangat baik. Rerata analitik 0.8182 juga sama dengan rerata grid pada bagian sebelumnya. Satu-satunya perbedaan terletak pada peluang ekor, yaitu 0.8062 dari grid dibandingkan 0.8083 dari fungsi eksak, karena penjumlahan kisi hanya memotong pada titik-titiknya dan melewatkan sebagian kecil luas di sekitar batas 0.75. Selisih seperseribu seperti ini wajar untuk kisi seribu titik dan tidak mengubah kesimpulan apa pun. Kebiasaan memverifikasi kisi dengan bentuk eksaknya juga patut dipertahankan, karena kisi dan rumus analitik hanyalah dua jalan menuju distribusi yang sama.
Kesalahan umum#
Kesalahan pertama adalah membaca likelihood sebagai distribusi atas . Nilai stats.binom.pmf(y, n, theta) pada tiap titik adalah peluang data, bukan densitas parameter, sehingga luasnya tidak berjumlah 1 dan tidak boleh diringkas seperti distribusi. Likelihood baru menjadi kurva yang sebanding dengan prior dan posterior setelah diskalakan, sebagaimana dilakukan pada gambar.
Kesalahan kedua adalah memakai hasil kali prior dan likelihood tanpa normalisasi. Kurva yang belum dibagi dengan luasnya bukan posterior, sehingga rerata, modus, dan peluang ekor yang dibaca darinya salah dalam skala yang tidak diketahui. Normalisasi pada langkah ketiga algoritma kisi tidak boleh dilewati.
Kesalahan ketiga adalah menetapkan jumlah titik kisi tanpa memeriksa dampaknya. Pada data 17 dari 20 soal, kisi sepuluh titik meletakkan modus pada 0.8889, meleset sekitar 0.04 dari nilai eksak 0.85, sedangkan kisi seribu titik memberi selisih densitas pada orde . Perkiraan cepatnya, jumlah titik diperbanyak hingga perubahan ringkasan posterior tidak terlihat lagi pada empat angka desimal.
Ringkasan#
- Pembaruan Bayesian menggabungkan prior dan likelihood menjadi posterior melalui Teorema Bayes, lalu posterior berperan sebagai keyakinan baru tentang parameter.
- Pada kisi seribu titik, posterior diperoleh dengan mengalikan prior uniform dan likelihood Binomial, kemudian menormalisasi luasnya menjadi 1.
- Data 17 benar dari 20 soal menghasilkan rerata posterior 0.8182, modus 0.8498, dan peluang sebesar 0.8062.
- Dengan prior uniform, kurva posterior berimpit dengan likelihood, dan hasil grid diverifikasi oleh posterior analitik Beta(18, 4) dengan selisih densitas .
Referensi#
- scipy.stats.binom — SciPy — Dokumentasi distribusi Binomial yang dipakai untuk menghitung likelihood pada setiap titik kisi.
- scipy.stats.beta — SciPy — Dokumentasi distribusi Beta yang menjadi posterior analitik pada keluarga konjugat Beta-Binomial.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika yang membahas estimasi proporsi beserta ketidakpastiannya.