Dua himpunan data dapat memiliki rata-rata yang sama persis sambil menunjukkan perilaku yang sangat berbeda, sehingga ringkasan numerik yang jujur memerlukan ukuran di luar pemusatan. Topik ini membahas ukuran sebaran (measures of spread), yaitu rentang (range), jarak antarkuartil (interquartile range), variansi (variance), dan simpangan baku (standard deviation). Pembahasan dimulai dari perbandingan dua kelas dengan rata-rata identik, kemudian bergerak ke rumus setelah intuisinya terbangun. Perhitungan menggunakan NumPy, lengkap dengan penjelasan pilihan ddof yang membedakan data sampel dari data populasi.
Rata-rata yang sama, sebaran yang berbeda#
Kelas A dan Kelas B pada contoh berikut sengaja dibuat memiliki rata-rata nilai ujian yang sama persis. Nilai Kelas A berkumpul rapat di sekitar rata-ratanya, sedangkan nilai Kelas B tersebar luas dari wilayah rendah hingga tinggi. Rata-rata saja menyembunyikan perbedaan kondisi belajar ini, sehingga ukuran sebaran menjadi pelengkap yang wajib. Program berikut membuat kedua kelas melalui simulasi, lalu menghitung simpangan bakunya dan menggambarkan histogramnya.
import numpy as np
import matplotlib.pyplot as plt

rng_a = np.random.default_rng(42)
rng_b = np.random.default_rng(43)

# Kelas A: nilai berkumpul rapat di sekitar 75
nilai_a = np.round(rng_a.normal(75, 3, size=40))
# Kelas B: bentuk sebaran lebar, lalu digeser agar rata-ratanya sama persis
nilai_b = rng_b.normal(75, 11, size=40)
nilai_b = nilai_b - nilai_b.mean() + nilai_a.mean()

print(f"Kelas A: rata-rata = {nilai_a.mean():.4f}, simpangan baku = {nilai_a.std(ddof=1):.4f}")
print(f"Kelas B: rata-rata = {nilai_b.mean():.4f}, simpangan baku = {nilai_b.std(ddof=1):.4f}")

fig, axes = plt.subplots(1, 2, figsize=(7, 4), constrained_layout=True, sharex=True, sharey=True)
axes[0].hist(nilai_a, bins=np.arange(35, 101, 5), color="#4c72b0", edgecolor="white")
axes[0].set_title("Kelas A")
axes[1].hist(nilai_b, bins=np.arange(35, 101, 5), color="#dd8452", edgecolor="white")
axes[1].set_title("Kelas B")
for ax in axes:
    ax.set_xlabel("Nilai ujian")
    ax.set_ylabel("Frekuensi")
fig.savefig("sebaran-dua-kelas.png", dpi=110)Kelas A: rata-rata = 75.0750, simpangan baku = 2.4847
Kelas B: rata-rata = 75.0750, simpangan baku = 10.9419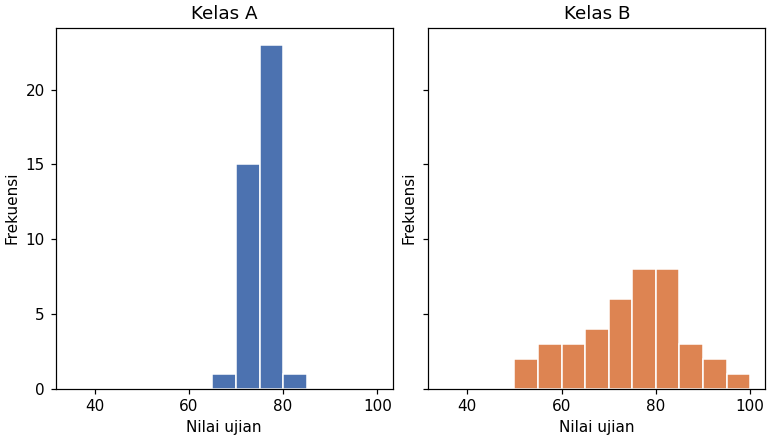
Rata-rata kedua kelas tercetak identik, tetapi simpangan baku Kelas B lebih dari empat kali milik Kelas A. Gambar histogram memperlihatkan sebabnya, yaitu batang Kelas A menumpuk di sekitar 75, sedangkan batang Kelas B melebar dari sekitar 55 hingga mendekati 100. Simpangan baku menerjemahkan perbedaan gambar itu menjadi satu bilangan yang mudah dibandingkan antarkelas.
Rentang dan jarak antarkuartil#
Rentang adalah selisih antara nilai terbesar dan nilai terkecil, yaitu ukuran sebaran yang paling sederhana. Kelemahannya muncul karena rentang bergantung pada dua pengamatan ujung saja, sehingga satu nilai ekstrem segera menentukan nilainya. Jarak antarkuartil atau IQR menutup kelemahan itu dengan mengukur lebar 50 persen data di tengah. IQR didefinisikan sebagai selisih kuartil atas dan kuartil bawah .
Kuartil adalah nilai batas yang membagi data terurut menjadi empat bagian yang sama besar, sehingga menandai batas 25 persen terbawah dan menandai batas 75 persen. Karena pengamatan ujungnya dikesampingkan, IQR tidak terpengaruh oleh pencilan. Program berikut menghitung rentang beserta kuartil dan IQR untuk kedua kelas pada bagian sebelumnya.
import numpy as np

# Dua kelas dengan rata-rata yang sama persis
rng_a = np.random.default_rng(42)
rng_b = np.random.default_rng(43)
nilai_a = np.round(rng_a.normal(75, 3, size=40))
nilai_b = rng_b.normal(75, 11, size=40)
nilai_b = nilai_b - nilai_b.mean() + nilai_a.mean()

for nama, nilai in (("Kelas A", nilai_a), ("Kelas B", nilai_b)):
    q1 = np.percentile(nilai, 25)
    q3 = np.percentile(nilai, 75)
print(f"{nama}: rentang = {np.ptp(nilai):.4f}, Q1 = {q1:.4f}, Q3 = {q3:.4f}, IQR = {q3 - q1:.4f}")Kelas A: rentang = 12.0000, Q1 = 73.0000, Q3 = 77.0000, IQR = 4.0000
Kelas B: rentang = 43.9014, Q1 = 68.5987, Q3 = 81.7417, IQR = 13.1430Rentang kedua kelas sama-sama besar karena masing-masing dihitung dari pengamatan ujungnya, sedangkan IQR Kelas B lebih dari tiga kali IQR Kelas A. Apabila satu nilai terjauh pada Kelas B dihapus, rentangnya menyusut tajam, sedangkan IQR hampir tidak bergerak. Ketahanan inilah yang kelak menjadi dasar aturan deteksi pencilan dengan IQR.
Variansi dan simpangan baku#
Simpangan baku mengukur seberapa jauh pengamatan biasanya menyimpang dari rata-ratanya. Cara berpikirnya adalah mengambil selisih setiap pengamatan terhadap rata-rata, menguadratkannya agar selisih positif dan negatif tidak saling meniadakan, lalu merata-ratakan kuadrat itu. Hasil perata-rataannya dinamai variansi, sedangkan akar kuadrat variansi mengembalikan ukuran ke satuan asli data dan dinamai simpangan baku. Satuan variansi berupa satuan kuadrat, misalnya menit kuadrat, sehingga variansi jarang dilaporkan langsung dalam laporan.
Cara berpikir tersebut untuk data sampel dituliskan sebagai berikut. Huruf menandai besaran yang dihitung dari sampel, berbeda dengan lambang populasi yang menyusul.
Apabila seluruh populasi tersedia, pembaginya menjadi banyaknya populasi dan rata-ratanya dilambangkan . Rumus variansi populasi menjadi seperti berikut.
NumPy menetapkan pembagi melalui argumen ddof, yaitu banyaknya derajat kebebasan (degrees of freedom) yang dikurangkan dari jumlah data. Nilai bawaannya adalah ddof=0 sehingga pembaginya , sedangkan variansi sampel memerlukan ddof=1. Program berikut membandingkan keduanya pada 15 nilai ujian statistika.
import numpy as np

# Nilai ujian statistika dari 15 siswa
nilai = np.array([65, 70, 70, 72, 75, 75, 75, 78, 80, 80, 82, 85, 88, 90, 95])

print(f"Variansi dengan ddof=0 : {np.var(nilai, ddof=0):.4f}")
print(f"Variansi dengan ddof=1 : {np.var(nilai, ddof=1):.4f}")
print(f"Simpangan baku ddof=0  : {np.std(nilai, ddof=0):.4f}")
print(f"Simpangan baku ddof=1 : {np.std(nilai, ddof=1):.4f}")Variansi dengan ddof=0 : 63.9556
Variansi dengan ddof=1 : 68.5238
Simpangan baku ddof=0 : 7.9972
Simpangan baku ddof=1 : 8.2779Nilai dengan ddof=1 selalu sedikit lebih besar karena pembaginya lebih kecil. Selisihnya menyusut ketika data bertambah banyak, tetapi tetap terasa pada sampel kecil seperti contoh ini. Laporan karenanya perlu menyebutkan konvensi yang dipakai secara konsisten agar angka sebaran antarlaporan dapat dibandingkan.
Kesalahan umum#
Kesalahan pertama yang sering terjadi adalah membiarkan ddof=0 pada data sampel, sehingga variansi dan simpangan baku yang dilaporkan terlalu kecil. Perbaikannya adalah menetapkan ddof=1 serta menyebutkan pilihan itu pada laporan. Kesalahan kedua adalah membandingkan simpangan baku dari data yang bersatuan berbeda, misalnya menit dengan jam, sehingga perbandingannya tidak berarti. Ubah satuan data menjadi sama terlebih dahulu sebelum membandingkan sebarannya. Kesalahan ketiga adalah menjadikan rentang satu-satunya ukuran sebaran, karena satu pencilan saja mampu menyeret rentang jauh melebihi lebar data yang sebenarnya. Kombinasi IQR dan simpangan baku memberikan gambaran sebaran yang lebih seimbang.
Ringkasan#
- Rata-rata yang sama tidak menjamin sebaran yang sama, sehingga ringkasan numerik selalu menyertakan ukuran sebaran.
- Rentang bergantung pada dua pengamatan ujung, sedangkan IQR mengukur lebar 50 persen data tengah dan tahan terhadap pencilan.
- Variansi adalah rata-rata kuadrat selisih terhadap rata-rata, sedangkan simpangan baku adalah akar variansi yang kembali ke satuan asli data.
- Data sampel memerlukan
ddof=1padanp.vardannp.stdagar pembaginya menjadi .
Referensi#
- numpy.std — NumPy — Dokumentasi fungsi simpangan baku NumPy beserta makna argumen ddof.
- numpy.var — NumPy — Dokumentasi fungsi variansi NumPy.
- numpy.percentile — NumPy — Dokumentasi fungsi persentil NumPy yang dipakai untuk menghitung kuartil dan IQR.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika dengan pembahasan ukuran sebaran dan kuartil.