Korelasi menyatakan seberapa rapat dua variabel bergerak bersama, sedangkan regresi linear sederhana (simple linear regression) melangkah lebih jauh dengan memasang garis yang mewakili hubungan itu, lengkap dengan persamaannya. Topik ini membahas model garis lurus, metode kuadrat terkecil (least squares) yang memilih garis terbaik, perhitungannya dengan NumPy pada data jam belajar dan nilai ujian, serta cara membaca kemiringan (slope), intersep (intercept), dan residual. Setelah topik ini, persamaan garis dari data dapat disusun, dibaca, dan dipakai untuk prediksi dengan batas yang jelas.
Model garis lurus#
Model regresi linear sederhana menyatakan nilai y sebagai garis lurus terhadap x ditambah simpangan acak. Penulisannya memakai satu persamaan dengan dua koefisien yang diestimasi dari data. Persamaannya berbunyi sebagai berikut.
Konstanta adalah intersep, yaitu nilai y yang diprediksi ketika . Konstanta adalah kemiringan, yaitu perubahan rata-rata y untuk setiap kenaikan x sebesar satu satuan. Suku menampung pengaruh segala hal di luar x yang membuat titik nyata tidak tepat berada di atas garis. Tujuan analisisnya ada dua, yaitu merangkum arah dan besar hubungan dalam satu persamaan serta memprediksi y untuk nilai x yang belum diamati.
Kata sederhana menunjuk pada jumlah variabel bebasnya, yaitu satu. Dengan satu variabel bebas, seluruh mekanisme pemasangan garis dapat dilihat secara utuh pada bidang datar dua dimensi, sehingga konsep yang sama nantinya dapat diperluas ke banyak variabel tanpa kehilangan intinya. Konsep kovariansi dan korelasi pada modul ini menjadi bekal langsung, karena pembilang rumus kemiringan nanti memakai blok perhitungan yang sama.
Metode kuadrat terkecil#
Banyak garis dapat dipasang pada satu kumpulan titik, sehingga kriteria pemilihannya harus dinyatakan tegas. Untuk setiap garis kandidat, residual didefinisikan sebagai selisih nilai teramati dengan nilai prediksi garisnya, yaitu . Metode kuadrat terkecil memilih garis yang meminimalkan jumlah kuadrat residual tersebut, dan penyelesaiannya memiliki rumus tertutup berikut.
Pembilang pada rumus adalah blok yang sama dengan kovariansi kedua variabel, sehingga hubungannya dengan korelasi tampak langsung pada bentuk alternatif . Bentuk tersebut menegaskan bahwa kemiringan mewarisi tanda korelasi dan besarnya bergantung pada rasio sebaran kedua variabel. Penyebutnya mengukur seberapa lebar x tersebar, sehingga data dengan rentang x yang lebar memberi informasi lebih banyak tentang kemiringan daripada data yang x-nya berkerumun sempit. Kuadrat pada kriteria dipilih karena membuat solusinya unik, mudah dihitung, dan menghukum simpangan yang jauh dengan lebih berat.
Penyesuaian garis dengan NumPy#
NumPy tidak menyediakan fungsi khusus regresi, tetapi fungsi np.polyfit dengan derajat 1 menghitung persis garis kuadrat terkecil. Program berikut menghitung dan secara manual dari rumus di atas, membandingkannya dengan np.polyfit, lalu menggambar data, garis hasil penyesuaian, dan garis residual setiap titiknya. Data pesertanya persis sama dengan contoh korelasi, sehingga angka r 0.9820 yang telah dihitung dapat dicocokkan dengan koefisien garisnya.
import numpy as np
import matplotlib.pyplot as plt

# Data yang sama: jam belajar dan nilai ujian dua belas peserta
jam_belajar = np.array([1.0, 2.0, 2.5, 3.0, 3.5, 4.0, 5.0, 5.5, 6.0, 6.5, 7.0, 8.0])
nilai = np.array([38.0, 47.0, 45.0, 55.0, 52.0, 63.0, 64.0, 71.0, 69.0, 79.0, 77.0, 86.0])

# Metode kuadrat terkecil dihitung manual
x_bar = jam_belajar.mean()
y_bar = nilai.mean()
b1 = np.sum((jam_belajar - x_bar) * (nilai - y_bar)) / np.sum((jam_belajar - x_bar) ** 2)
b0 = y_bar - b1 * x_bar

# Pembanding: fungsi kuadrat terkecil bawaan NumPy
koef = np.polyfit(jam_belajar, nilai, 1)

print(f"Kemiringan b1 manual  : {b1:.4f}")
print(f"Intersep b0 manual    : {b0:.4f}")
print(f"np.polyfit b1, b0     : {koef[0]:.4f}, {koef[1]:.4f}")

# Residual dan prediksi
prediksi = b0 + b1 * jam_belajar
residual = nilai - prediksi
i_terbesar = int(np.argmax(np.abs(residual)))
print(f"Residual absolut terbesar : {np.abs(residual[i_terbesar]):.4f} pada peserta ke-{i_terbesar + 1}")
print(f"Prediksi nilai 6 jam belajar  : {b0 + b1 * 6:.4f}")
print(f"Prediksi nilai 20 jam belajar : {b0 + b1 * 20:.4f}")

# Grafik: data, garis kuadrat terkecil, dan garis residual
fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.scatter(jam_belajar, nilai, s=35, color="#4c72b0", label="Data peserta")
x_garis = np.linspace(1, 8, 100)
ax.plot(x_garis, b0 + b1 * x_garis, color="#dd8452", label="Garis kuadrat terkecil")
for xi, yi, pi in zip(jam_belajar, nilai, prediksi):
    ax.plot([xi, xi], [yi, pi], color="#999999", linewidth=1)
ax.set_xlabel("Jam belajar")
ax.set_ylabel("Nilai ujian")
ax.set_title("Garis kuadrat terkecil dan residualnya")
ax.legend()
fig.savefig("regresi-garis-residual.png", dpi=110)Kemiringan b1 manual : 6.7596
Intersep b0 manual : 31.7484
np.polyfit b1, b0 : 6.7596, 31.7484
Residual absolut terbesar : 4.2131 pada peserta ke-6
Prediksi nilai 6 jam belajar : 72.3061
Prediksi nilai 20 jam belajar : 166.9407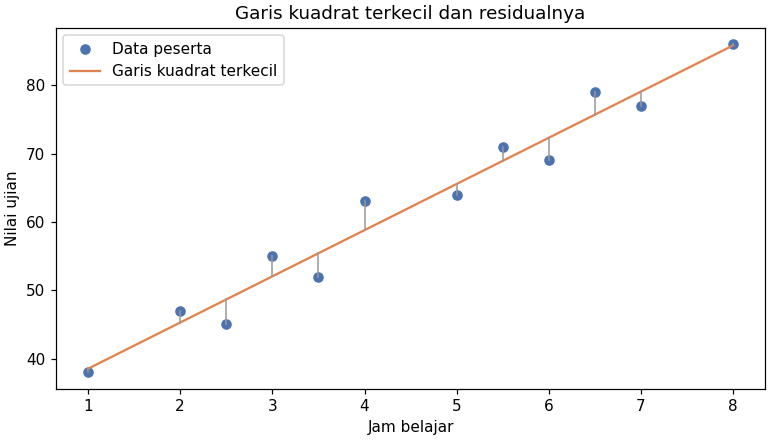
Perhitungan manual dan np.polyfit menghasilkan angka yang persis sama, yaitu kemiringan 6.7596 dan intersep 31.7484. Kemiringan itu dibaca sebagai berikut, yaitu setiap tambahan satu jam belajar diiringi kenaikan nilai ujian rata-rata sebesar 6.76 poin. Intersep 31.75 adalah prediksi nilai untuk peserta yang tidak belajar sama sekali, dan nilai tersebut masih berada dekat dengan rentang data karena pengamatan terkecilnya satu jam. Prediksi untuk enam jam belajar menghasilkan 72.31 poin, angka yang wajar karena enam jam berada di tengah rentang data.
Prediksi untuk dua puluh jam belajar menghasilkan 166.94 poin, nilai yang tidak mungkin pada skala 0 sampai 100. Garis hanya teruji pada rentang x yang diamati, yaitu satu sampai delapan jam, dan di luar rentang itu tidak ada data yang menjamin polanya berlanjut. Rentang data dengan demikian menjadi bagian dari pelaporan prediksi, bukan sekadar catatan kaki.
Membaca residual pada grafik#
Segmen abu-abu tegak pada grafik adalah residual setiap peserta, yaitu jarak vertikal dari titik data ke garis. Residual positif berarti nilai nyata di atas prediksi garis, sedangkan residual negatif berarti sebaliknya. Selisih itu dapat dibaca langsung dari grafik tanpa perhitungan tambahan, karena garis oranye sudah memberikan prediksinya. Pada data ini residual terbesar hanya 4.21 poin pada peserta keenam, yang kelihatan sebagai titik paling menjulur di bawah garis, dan selebihnya berkerumun rapat di kedua sisi garis.
Pola residual menyimpan informasi yang tidak tampak pada persamaannya. Residual yang tersebar acak di sekitar nol menandakan garis sudah menangkap bentuk hubungannya, sedangkan residual yang membentuk lengkung menandakan hubungan yang sebenarnya tidak linear. Pemeriksaan pola inilah yang menjadi bahan utama ketika regresi dipakai untuk inferensi, karena standard error dan p-value seluruhnya bertumpu pada asumsi tentang residual. Pemeriksaan sederhana tersebut dengan demikian memberi keterangan yang tidak diberikan oleh persamaan garisnya.
Kesalahan umum#
Kesalahan pertama adalah menafsirkan kemiringan sebagai sebab. Nilai b1 6.76 poin per jam menyatakan perbedaan rata-rata yang menyertai perbedaan jam belajar pada data observasional, bukan efek yang dijamin murni berasal dari jam belajar. Perbaikannya adalah membaca kemiringan sebagai hubungan bersyarat pada data ini, dan klaim kausal hanya dinyatakan apabila datanya berasal dari eksperimen yang diacak.
Kesalahan kedua adalah menafsirkan intersep di luar konteksnya. Intersep adalah prediksi pada , dan pembacaan itu hanya bermakna apabila nol berada dalam rentang yang masuk akal untuk variabelnya. Apabila x tidak mungkin bernilai nol, intersep tetap diperlukan untuk posisi garis, tetapi tidak dibaca sebagai prediksi yang bermakna. Perbaikannya adalah memeriksa rentang data terlebih dahulu sebelum menyebut makna intersepnya.
Kesalahan ketiga adalah memaksakan garis pada data yang melengkung. Kuadrat terkecil selalu menghasilkan satu garis, bahkan untuk data berbentuk U, tetapi garis itu tidak menggambarkan hubungannya. Perbaikannya adalah memeriksa plot data beserta residualnya, lalu mempertimbangkan transformasi variabel atau model yang bentuknya sesuai apabila pola lengkungan terlihat.
Ringkasan#
- Regresi linear sederhana memodelkan y sebagai ditambah simpangan acak, dengan sebagai intersep dan sebagai kemiringan.
- Metode kuadrat terkecil memilih garis dengan jumlah kuadrat residual terkecil, dan hasilnya identik dengan
np.polyfit(x, y, 1). - Kemiringan b1 6.7596 berarti nilai ujian rata-rata naik 6.76 poin per tambahan satu jam belajar pada data ini.
- Prediksi hanya sah di dalam rentang data, karena ekstrapolasi ke 20 jam belajar menghasilkan nilai yang tidak mungkin.
Referensi#
- numpy.polyfit — NumPy — Dokumentasi fungsi penyesuaian polinomial kuadrat terkecil yang dipakai pada contoh.
- OpenIntro Statistics — OpenIntro — Bab regresi linear pada buku ini membahas kuadrat terkecil dan interpretasi koefisiennya.
- NIST/SEMATECH e-Handbook of Statistical Methods — NIST — Pegangan teknik statistika terapan yang mencakup penyesuaian garis dan diagnosisnya.