Garis kuadrat terkecil menghasilkan satu pasang angka dari satu kumpulan data, sedangkan inferensi regresi menjawab pertanyaan seberapa jauh angka itu dapat dipercaya sebagai kesimpulan yang lebih umum. Topik ini membahas standard error koefisien kemiringan, uji t terhadap hipotesis nol (null hypothesis) bahwa kemiringan nol, makna R-squared sebagai proporsi variansi yang dijelaskan, serta pemeriksaan residual yang menjadi fondasi seluruh keluaran tersebut. Setelah topik ini, keluaran fungsi regresi dapat dilaporkan lengkap dengan ukuran ketidakpastiannya dan diagnosis yang menopangnya.
Standard error koefisien kemiringan#
Garis yang terpasang pada satu sampel adalah satu penaksiran, dan sampel lain dari populasi yang sama akan menghasilkan garis yang sedikit berbeda. Standard error menerjemahkan sebaran garis-garis hipotetis itu menjadi satu bilangan untuk setiap koefisien. Perhitungannya berangkat dari standard error residual , yaitu jarak khas titik data dari garis.
Pembagi dipakai karena dua koefisien garis sudah diestimasi dari data yang sama, sehingga derajat kebebasan residualnya tinggal . Tanpa penyesuaian derajat kebebasan itu, rata-rata kuadrat residualnya cenderung terlalu kecil. Standard error kemiringan kemudian diturunkan dari dan sebaran x.
Rumus tersebut dapat dibaca lewat dua pengaruhnya. Semakin besar , semakin berantakan titik di sekitar garis, sehingga kemiringan makin sulit ditentukan dan SE-nya membesar. Semakin lebar x tersebar di sekitar rata-ratanya, semakin banyak informasi tentang arah hubungan, sehingga SE-nya mengecil. Kedua pengaruh itu menjelaskan mengapa data yang ramai tetapi x-nya sempit sering menghasilkan kemiringan yang tidak pasti.
Uji t untuk kemiringan#
Pertanyaan inferensi yang paling sering diajukan kepada kemiringan adalah apakah nilainya dapat dibedakan dari nol. Hipotesis nol menyatakan , yaitu tidak ada hubungan linear antara x dan y pada populasi. Statistik ujinya adalah rasio kemiringan terhadap standard errornya.
Program berikut mengulangi penyesuaian garis pada data jam belajar dan nilai ujian, menghitung dan SE secara manual, lalu membandingkannya dengan keluaran fungsi scipy.stats.linregress yang mengembalikan slope, intercept, rvalue, pvalue, dan stderr sekaligus. Angka-angka yang sama menjadi bahan pembacaan setelah programnya. Perbandingan jalur manual dan jalur bawaan berfungsi sebagai uji silang bahwa rumus di atas dipahami dengan benar.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Data yang sama: jam belajar dan nilai ujian dua belas peserta
jam_belajar = np.array([1.0, 2.0, 2.5, 3.0, 3.5, 4.0, 5.0, 5.5, 6.0, 6.5, 7.0, 8.0])
nilai = np.array([38.0, 47.0, 45.0, 55.0, 52.0, 63.0, 64.0, 71.0, 69.0, 79.0, 77.0, 86.0])

# Regresi linear dengan scipy.stats.linregress
hasil = stats.linregress(jam_belajar, nilai)
n = len(jam_belajar)

# Standard error residual dan standard error b1 dihitung manual
prediksi = hasil.intercept + hasil.slope * jam_belajar
residual = nilai - prediksi
sse = np.sum(residual ** 2)
se_res = np.sqrt(sse / (n - 2))
se_b1_manual = se_res / np.sqrt(np.sum((jam_belajar - jam_belajar.mean()) ** 2))

# Dekomposisi variansi untuk R-squared
sst = np.sum((nilai - nilai.mean()) ** 2)
r2 = 1 - sse / sst

print(f"Kemiringan b1           : {hasil.slope:.4f}")
print(f"Intersep b0             : {hasil.intercept:.4f}")
print(f"r                       : {hasil.rvalue:.4f}")
print(f"R-squared               : {r2:.4f}")
print(f"Standard error residual : {se_res:.4f}")
print(f"SE b1 manual            : {se_b1_manual:.4f}")
print(f"SE b1 linregress        : {hasil.stderr:.4f}")
print(f"Statistik uji t         : {hasil.slope / hasil.stderr:.4f}")
print(f"p-value (H0: b1 = 0)    : {hasil.pvalue:.2e}")

# Pemeriksaan residual: residual terhadap nilai prediksi
fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.scatter(prediksi, residual, s=35, color="#4c72b0")
ax.axhline(0, color="#dd8452", linewidth=1.5)
ax.set_xlabel("Nilai prediksi")
ax.set_ylabel("Residual")
ax.set_title("Residual terhadap nilai prediksi")
fig.savefig("residual-fitted.png", dpi=110)Kemiringan b1 : 6.7596
Intersep b0 : 31.7484
r : 0.9820
R-squared : 0.9644
Standard error residual : 2.9608
SE b1 manual : 0.4106
SE b1 linregress : 0.4106
Statistik uji t : 16.4634
p-value (H0: b1 = 0) : 1.42e-08Perhitungan manual dan linregress menghasilkan SE yang sama, yaitu 0.4106. Dengan kemiringan 6.7596, statistik t-nya mencapai 16.4634, dan p-value yang menyertainya sebesar , jauh di bawah taraf signifikansi 0.05 yang lazim dipakai. Hipotesis nol bahwa kemiringan nol dengan demikian ditolak, sehingga data memberi bukti kuat adanya hubungan linear positif. Angka SE juga langsung memberi rentang yang wajar untuk kemiringan, yaitu sekitar ditambah kurang dua kali SE-nya atau 6.76 ± 0.82. Standard error residual 2.9608 menyatakan jarak khas satu peserta dari garis, yakni sekitar tiga poin.
R-squared dan proporsi variansi yang dijelaskan#
R-squared, selanjutnya ditulis R², mengukur seberapa besar variansi y yang terjelaskan oleh garis. Ukuran ini diturunkan dari dua jumlah kuadrat, yaitu SSE sebagai jumlah kuadrat residual yang tidak terjelaskan dan SST sebagai jumlah kuadrat total y terhadap rata-ratanya. Karena keduanya dihitung dari data yang sama, R² selalu berada antara 0 dan 1.
Pada data ini R² sebesar 0.9644, yang terbaca sebagai berikut, yaitu sekitar 96.44 persen variansi nilai ujian pada sampel ini terjelaskan oleh jam belajar melalui garis, dan sisanya berasal dari pengaruh lain. Kesetaraan terverifikasi pada angka yang sama, karena 0.9820 kuadrat menghasilkan 0.9644. Proporsi tersebut menjawab pertanyaan yang berbeda dari p-value, karena R² menyatakan besar manfaat garisnya, sedangkan p-value menyatakan kekuatan bukti terhadap kemiringan nol.
Dua kualifikasi perlu menyertai pembacaan R². Angka 96.44 persen berlaku untuk sampel ini dan tidak menyatakan sebab-akibat, sebab regresi pada data observasional tidak mengendalikan perancunya. R² yang tinggi juga tidak membuktikan bentuk model sudah tepat, karena garis yang dipaksakan pada data melengkung pun dapat memperoleh R² besar, dan deteksinya memang tugas pemeriksaan residual.
Pemeriksaan residual#
Asumsi yang menopang standard error, uji t, dan p-value semuanya berbicara tentang perilaku residual, sehingga residual wajib dilihat sebelum inferensi dilaporkan. Pemeriksaan yang paling dasar adalah plot residual terhadap nilai prediksi, yang dihasilkan baris terakhir program di atas. Sebagian besar masalah yang lazim, mulai dari bentuk hubungan hingga pencilan, tampak pada satu plot itu.
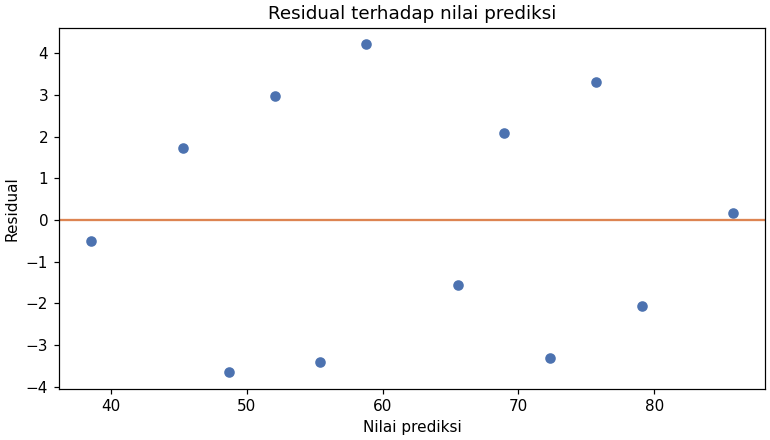
Plot yang sehat menampilkan titik-titik yang tersebar acak di sekitar garis nol tanpa bentuk apa pun, dan data jam belajar pada grafik ini memenuhi gambaran itu. Tiga pola buruk yang paling sering muncul adalah lengkung yang menandakan hubungan tidak linear, corong yang melebar menandakan variansi residual tidak konstan, serta pencilan yang jauh dari kelompoknya dan dapat menggeser garis secara berlebihan. Setiap pola semacam itu menuntut tindakan, misalnya transformasi variabel atau model dengan bentuk yang sesuai, sebelum standard error dan p-value dipercaya.
Kesalahan umum#
Kesalahan pertama adalah menganggap R² yang tinggi sebagai tanda model yang benar. Garis kuadrat terkecil pada data yang sebenarnya melengkung tetap dapat memperoleh R² besar, sementara pola lengkungnya justru tersembunyi di residual. Perbaikannya adalah menjadikan plot residual terhadap prediksi sebagai pelaporan wajib yang menyertai setiap R².
Kesalahan kedua adalah membaca p-value yang kecil sebagai efek yang besar. p-value menyatakan kekuatan bukti terhadap hipotesis nol, sedangkan besar efeknya diukur oleh kemiringan dan R², dan sampel yang besar dapat membuat efek kecil menjadi signifikan. Perbaikannya adalah melaporkan kemiringan beserta SE-nya bersama p-value, sebagaimana 6.76 poin per jam dengan SE 0.41 pada data ini.
Kesalahan ketiga adalah menghitung dengan pembagi n alih-alih . Pembagi yang keliru itu membuat standard error residual dan seluruh inferensi turunannya terlalu kecil, karena derajat kebebasan yang dipakai dua koefisien garis tidak diperhitungkan. Perbaikannya adalah memakai untuk regresi linear sederhana dan menyesuaikannya dengan banyaknya koefisien pada model yang lebih besar.
Ringkasan#
- Standard error residual mengukur jarak khas titik dari garis, dan SE menerjemahkannya menjadi ketidakpastian kemiringan.
- Uji t membandingkan kemiringan dengan nol melalui , dan p-value 1.42e-08 pada data ini menolak hipotesis nol.
- R² sebesar 0.9644 menyatakan 96.44 persen variansi nilai ujian pada sampel ini yang terjelaskan oleh garis, dan nilainya sama dengan r kuadrat.
- Plot residual terhadap prediksi wajib diperiksa, karena pola lengkung, corong, atau pencilan tidak tampak pada angka inferensi mana pun.
Referensi#
- scipy.stats.linregress — SciPy — Dokumentasi fungsi regresi linear yang mengembalikan slope, intercept, rvalue, pvalue, dan stderr.
- OpenIntro Statistics — OpenIntro — Bab inferensi regresi pada buku ini membahas standard error koefisien dan diagnosis residual.
- NIST/SEMATECH e-Handbook of Statistical Methods — NIST — Pegangan teknik statistika terapan yang mencakup uji kemiringan dan analisis residual.