Uji parametrik seperti uji t memberi hasil yang tepat selama asumsinya terpenuhi, dan asumsi itu tidak otomatis terpenuhi pada data nyata. Topik ini membahas cara mendiagnosis pelanggaran asumsi pada titik-titik yang paling menentukan, alat pemeriksanya di SciPy, dan pemilihan uji pengganti yang jujur ketika diagnosis menunjukkan masalah. Pembahasan diawali daftar asumsi beserta cara memeriksanya, dilanjutkan pohon keputusan pemilihan uji, lalu ditutup simulasi lengkap dari data eksponensial hingga keputusan akhirnya. Seluruh angka pada contoh dibangkitkan dengan benih generator yang tetap sehingga dapat direproduksi.
Empat asumsi yang perlu diperiksa#
Empat asumsi menentukan apakah hasil uji parametrik layak dipercaya. Kebebasan observasi berarti satu pengamatan tidak memengaruhi pengamatan lain, dan asumsi ini dijamin oleh desain pengambilan sampel, bukan oleh uji statistik. Normalitas (normality) menuntut sebaran nilai pada setiap kelompok kira-kira berbentuk lonceng. Homogenitas variansi (homogeneity of variance) menuntut sebaran kelompok-kelompok yang dibandingkan sama lebarnya, dan pelanggarannya paling berbahaya ketika ukuran kelompok tidak seimbang. Skala pengukuran menuntut data numerik yang jarak antarnilainya bermakna, sehingga data ordinal tidak boleh dirata-ratakan.
| Asumsi | Alat pemeriksaan |
|---|---|
| Kebebasan observasi | Desain pensampelan dan cara pengumpulan data |
| Normalitas | Histogram, QQ plot, uji Shapiro-Wilk |
| Homogenitas variansi | Perbandingan simpangan baku dan boxplot antarkelompok |
| Skala pengukuran | Penelusuran asal-usul data sebelum analisis |
Diagnosis dilakukan sebelum pengujian utama, bukan sesudah hasilnya tidak sesuai harapan. Urutan ini penting karena pilihan uji yang diambil setelah melihat p-value cenderung terarah pada hasil yang diinginkan, dan kebiasaan itu merusak makna taraf signifikansi. Setiap keputusan yang diambil karena asumsi gugur perlu dilaporkan beserta alasannya.
Memeriksa normalitas dengan histogram dan QQ plot#
Dua gambar biasanya cukup untuk menilai bentuk sebaran, yaitu histogram dan plot kuantil-kuantil (quantile-quantile plot, QQ plot). QQ plot menggambar kuantil data terurut terhadap kuantil distribusi normal pada skala yang sama, dan data yang normal membentuk garis lurus. Lengkungan sistematis menunjukkan pencengengan, sedangkan titik yang menyimpang jauh di ujung menunjukkan ekor berat atau pencilan. Program berikut mendiagnosis 60 amatan waktu pengerjaan soal yang sebarannya eksponensial, lengkap dengan uji Shapiro-Wilk dan skewtest.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Waktu pengerjaan satu rangkaian soal (menit) dari 60 siswa
rng = np.random.default_rng(42)
waktu = np.round(rng.exponential(scale=12.0, size=60) + 3.0, 2)
print(f"Median amatan : {np.median(waktu):.4f} menit")
print(f"Rata-rata     : {waktu.mean():.4f} menit")

# Uji Shapiro-Wilk dan skewtest untuk diagnosis bentuk sebaran
sh = stats.shapiro(waktu)
sk = stats.skewtest(waktu)
print(f"Shapiro-Wilk  : W = {sh.statistic:.4f}, p-value = {sh.pvalue:.4e}")
print(f"Skewtest      : statistik = {sk.statistic:.4f}, p-value = {sk.pvalue:.4e}")

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(9, 4), constrained_layout=True)
ax1.hist(waktu, bins=15, color="#4c72b0", edgecolor="white")
ax1.set_title("Histogram waktu pengerjaan")
ax1.set_xlabel("Waktu (menit)")
ax1.set_ylabel("Frekuensi")
stats.probplot(waktu, dist="norm", plot=ax2)
ax2.set_title("QQ plot terhadap distribusi normal")
ax2.set_xlabel("Kuantil teoretis")
ax2.set_ylabel("Waktu amatan (menit)")
fig.savefig("diagnosis-normalitas.png", dpi=110)Median amatan : 8.4850 menit
Rata-rata : 12.8772 menit
Shapiro-Wilk : W = 0.8195, p-value = 4.2913e-07
Skewtest : statistik = 4.4791, p-value = 7.4963e-06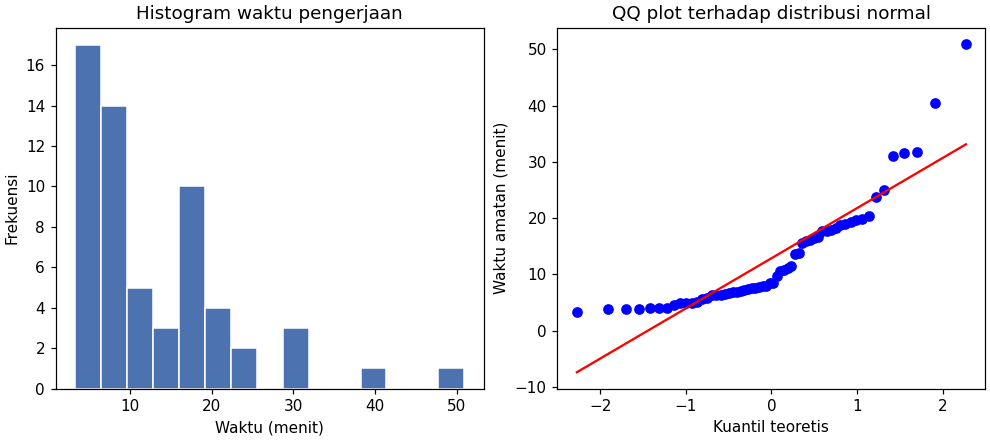
Keempat alat memberi kesimpulan yang sama. Histogram menunjukkan tumpukan nilai kecil dengan ekor kanan yang panjang, titik-titik QQ plot melengkung menjauhi garis, uji Shapiro-Wilk menolak normalitas dengan p-value 4.2913e-07, dan skewtest menegaskan kemencengan positifnya. Diagnosisnya jelas, yaitu sebaran eksponensial, sehingga uji t pada skala aslinya perlu dipertimbangkan ulang.
Pohon keputusan pemilihan uji#
Hasil diagnosis menentukan cabang yang diambil, dan diagram berikut meringkas aturan pemilihannya mulai dari jenis data.
Data kategorikal menuju uji chi-square karena pertanyaannya menyangkut frekuensi, bukan rata-rata. Data numerik yang lulus diagnosis normalitas dengan variansi serupa menuju uji t, dan koreksi Welch melalui equal_var=False diambil apabila variansi atau ukuran kelompoknya tidak seimbang. Data numerik yang menceng atau berskala ordinal menuju uji berbasis peringkat, yaitu Mann-Whitney U untuk kelompok bebas dan Wilcoxon signed-rank untuk data berpasangan. Rute ini bersifat teknis, sehingga dua analis pada data yang sama dengan diagnosis yang sama seharusnya tiba pada uji yang sama.
Seluruh proses ini menuntut kejujuran pelaporan. Laporan menyebut asumsi yang diperiksa, alat pemeriksaannya, dan keputusan akhirnya, sehingga pembaca dapat menilai apakah pilihan uji diambil sebelum atau sesudah melihat hasilnya. Bagian berikut menerapkan pohon tersebut sampai tuntas pada satu data.
Simulasi dari eksponensial ke uji peringkat#
Program berikut merangkum alur diagnosis sampai keputusannya. Dua kelompok waktu pengerjaan soal dibangkitkan dari sebaran eksponensial dengan skala berbeda, kemudian normalitasnya didiagnosis dengan uji Shapiro-Wilk. Setelah itu tiga jalur pengujian dijalankan pada data yang sama, yaitu uji t langsung, uji Mann-Whitney U, dan uji t pada skala logaritma.
import numpy as np
from scipy import stats

# Waktu pengerjaan soal (menit) dua kelompok metode, sebarannya eksponensial
rng = np.random.default_rng(42)
metode_a = np.round(rng.exponential(scale=20.0, size=25) + 5.0, 2)
metode_b = np.round(rng.exponential(scale=12.0, size=25) + 5.0, 2)

# Diagnosis normalitas pada setiap kelompok
sh_a = stats.shapiro(metode_a)
sh_b = stats.shapiro(metode_b)
print(f"Shapiro-Wilk metode A : W = {sh_a.statistic:.4f}, p-value = {sh_a.pvalue:.4f}")
print(f"Shapiro-Wilk metode B : W = {sh_b.statistic:.4f}, p-value = {sh_b.pvalue:.4f}")

# Tiga jalur pengujian pada data yang sama
t = stats.ttest_ind(metode_a, metode_b)
u = stats.mannwhitneyu(metode_a, metode_b, alternative="two-sided")
t_log = stats.ttest_ind(np.log(metode_a), np.log(metode_b))
print(f"Uji t langsung        : t = {t.statistic:.4f}, p-value = {t.pvalue:.4f}")
print(f"Mann-Whitney U        : U = {u.statistic:.1f}, p-value = {u.pvalue:.4f}")
print(f"Uji t pada skala log : t = {t_log.statistic:.4f}, p-value = {t_log.pvalue:.4f}")Shapiro-Wilk metode A : W = 0.9081, p-value = 0.0277
Shapiro-Wilk metode B : W = 0.8869, p-value = 0.0096
Uji t langsung : t = 3.6731, p-value = 0.0006
Mann-Whitney U : U = 451.0, p-value = 0.0074
Uji t pada skala log : t = 3.2502, p-value = 0.0021Shapiro-Wilk menolak normalitas pada kedua kelompok dengan p-value 0.0277 dan 0.0096, sehingga cabang normal pada pohon keputusan tidak tercapai. Uji t langsung melaporkan p-value 0.0006 dan Mann-Whitney U melaporkan 0.0074, keduanya menolak hipotesis nol pada taraf 0.05. Ketiga jalur sepakat pada data ini, tetapi uji utama yang sah untuk dilaporkan adalah Mann-Whitney U, karena diagnosis normalitas sudah gugur dan keputusan metode harus diambil sebelum p-value dilihat. Uji t pada skala logaritma berperan sebagai pemeriksa silang, bukan sebagai pengganti yang dicari setelah hasil pertama kurang memuaskan.
Kesalahan umum#
Kesalahan pertama adalah mencoba banyak uji pada data yang sama sampai salah satunya signifikan, karena peluang positif palsu membengkak setiap kali uji ditambahkan dan keputusannya tidak lagi bermakna. Diagnosis beserta pilihan ujinya ditetapkan sebelum p-value dilihat. Kesalahan kedua adalah memperlakukan Shapiro-Wilk sebagai keputusan mutlak, padahal keputusannya perlu menimbang ukuran sampel dan alat visual seperti dijelaskan pada bagian sebelumnya. Kesalahan ketiga adalah menyembunyikan riwayat analisis, misalnya melaporkan hanya uji yang menolak tanpa menyebut diagnosisnya, sehingga pembaca tidak dapat menilai jalurnya.
Laporan yang baik menyertakan asumsi yang diperiksa, hasil pemeriksaannya, dan uji yang dipilih beserta alasannya. Kebiasaan ini terasa berat pada analisis tunggal, tetapi menjadi nilai yang membedakan laporan yang dapat dipercaya dari laporan yang sekadar menghasilkan angka. Seluruh contoh pada topik ini dapat dijadikan templat alurnya, mulai dari diagnosis, pohon keputusan, hingga pelaporan keputusan akhirnya.
Ringkasan#
- Empat asumsi yang diperiksa sebelum uji parametrik adalah kebebasan observasi, normalitas, homogenitas variansi, dan skala pengukuran.
- Histogram, QQ plot, uji Shapiro-Wilk, dan skewtest bekerja bersama untuk mendiagnosis bentuk sebaran, dan contoh eksponensial ditolak Shapiro-Wilk dengan p-value 4.2913e-07.
- Pohon keputusan mengarahkan data kategorikal ke uji chi-square, data numerik normal ke uji t, dan data numerik menceng atau ordinal ke uji peringkat.
- Pemilihan uji karena asumsi gugur dilaporkan beserta alasannya, dan transformasi log menjadi pilihan tengah sebelum beralih ke uji peringkat.
Referensi#
- scipy.stats.shapiro — SciPy — Dokumentasi uji Shapiro-Wilk beserta catatan validitasnya pada ukuran sampel tertentu.
- scipy.stats.probplot — SciPy — Dokumentasi plot kuantil-kuantil yang digunakan untuk diagnosis visual.
- NIST/SEMATECH e-Handbook of Statistical Methods — NIST — Buku pegangan resmi NIST dengan bagian pemeriksaan asumsi dan uji nonparametrik.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika yang membahas syarat uji t dan alternatif nonparametrik.