Estimasi titik melaporkan satu bilangan tanpa menyatakan seberapa jauh bilangan itu biasanya menyimpang dari parameter, sehingga ketidakpastiannya perlu diukur tersendiri. Topik ini membahas standard error yang selanjutnya disingkat SE, yaitu simpangan baku dari sebaran estimator. Pembahasan dimulai dari pembedaan SE dengan simpangan baku data, dilanjutkan dengan simulasi penurunan SE ketika ukuran sampel membesar, dan ditutup dengan hukum akar kuadrat yang mengatur laju penurunannya. Setelah topik ini, hubungan antara ukuran sampel dan ketidakpastian estimasi dapat dibaca langsung dari satu grafik.
Simpangan baku data dan standard error#
Standard error adalah simpangan baku dari distribusi pensampelan sebuah estimator, bukan simpangan baku dari data mentah. Keduanya berupa ukuran sebaran dengan satuan yang sama, tetapi objek yang diukurnya berbeda. Simpangan baku menyatakan jarak khas satu pengamatan terhadap rata-ratanya, sedangkan standard error menyatakan jarak khas estimasi dari satu sampel terhadap . Laporan yang menyandingkan keduanya tanpa label yang jelas mudah dibaca keliru. Untuk estimator berupa rata-rata sampel, standard error dihitung dari simpangan baku sampel dan ukuran sampelnya.
Penyebutnya menggunakan karena populasi tidak diketahui, sehingga berperan sebagai penggantinya. Sebagai contoh, empat puluh waktu tunggu loket dengan menit menghasilkan SE sebesar menit. Simpangan baku data tetap tiga menit, sedangkan ketidakpastian rata-ratanya hanya sekitar 0.47 menit. Dua angka itu menjawab pertanyaan yang berbeda dan keduanya penting.
Sebuah estimasi tanpa standard error sulit dibandingkan antarpenelitian. Dua studi yang sama-sama melaporkan rata-rata durasi tidur tujuh jam dapat memiliki kualitas yang berbeda, karena yang satu mengumpulkan sepuluh pengamatan sedangkan yang lain mengumpulkan dua ratus. Standard error menerjemahkan perbedaan ukuran sampel itu menjadi satu bilangan yang sebanding, sehingga estimasi yang lebih presisi terlihat langsung dari laporannya.
Simulasi: standard error mengecil saat sampel membesar#
Hubungan SE dengan dapat diverifikasi melalui simulasi pada satu populasi yang diketahui, misalnya durasi tidur dengan jam dan jam. Sepuluh ribu sampel ditarik untuk setiap pada 10, 50, dan 200. Simpangan baku dari sepuluh ribu rata-rata sampel dihitung sebagai SE empiris, kemudian dibandingkan dengan nilai rumus serta rata-rata yang menggunakan data sampel semata.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)

# Populasi: durasi tidur (jam) dimodelkan normal dengan mu = 7 dan sigma = 1.5
mu, sigma = 7.0, 1.5
daftar_n = [10, 50, 200]
banyak_sampel = 10000

print("Setiap baris dihitung dari 10000 sampel per ukuran n")
se_empiris_semua = {}
for n in daftar_n:
    sampel = rng.normal(mu, sigma, size=(banyak_sampel, n))
    rata_sampel = sampel.mean(axis=1)
    se_empiris = rata_sampel.std(ddof=1)
    se_empiris_semua[n] = se_empiris
    se_rumus = sigma / np.sqrt(n)
    se_taksiran = (sampel.std(axis=1, ddof=1) / np.sqrt(n)).mean()
    print(
        f"n = {n:>3} : SE empiris = {se_empiris:.4f}, "
        f"rumus sigma/akar n = {se_rumus:.4f}, "
        f"rata-rata s/akar n = {se_taksiran:.4f}"
    )

# Hukum akar kuadrat: n dikalikan 4, SE menjadi setengahnya
rasio = se_empiris_semua[50] / se_empiris_semua[200]
print(f"Rasio SE empiris n=50 terhadap n=200 : {rasio:.4f}")

# Grafik hubungan n dan SE: kurva rumus ditambah titik hasil simulasi
n_grafik = np.arange(10, 201)
fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.plot(n_grafik, sigma / np.sqrt(n_grafik), color="#4c72b0", label=r"Rumus $\sigma/\sqrt{n}$")
ax.scatter(daftar_n, [se_empiris_semua[n] for n in daftar_n], color="#dd8452", zorder=3, label="SE empiris dari simulasi")
ax.set_xlabel("Ukuran sampel n")
ax.set_ylabel("Standard error rata-rata sampel")
ax.set_title("Standard error mengecil mengikuti akar kuadrat n")
ax.legend()
fig.savefig("se-vs-n.png", dpi=110)Setiap baris dihitung dari 10000 sampel per ukuran n
n = 10 : SE empiris = 0.4767, rumus sigma/akar n = 0.4743, rata-rata s/akar n = 0.4628
n = 50 : SE empiris = 0.2093, rumus sigma/akar n = 0.2121, rata-rata s/akar n = 0.2111
n = 200 : SE empiris = 0.1052, rumus sigma/akar n = 0.1061, rata-rata s/akar n = 0.1059
Rasio SE empiris n=50 terhadap n=200 : 1.9891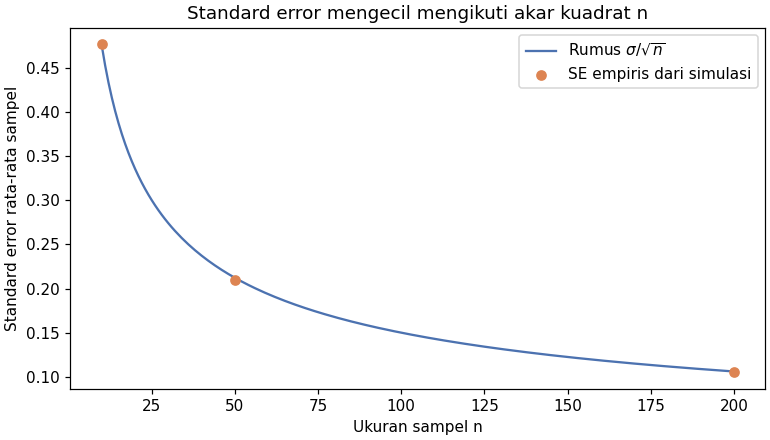
Nilai rumus dan SE empiris saling menempel pada ketiga ukuran sampel, sehingga rumus terbukti menggambarkan sebaran estimator dengan baik. Rata-rata sedikit berada di bawah rumus pada karena cenderung terlalu kecil pada sampel pendek, dan selisih itu menyusut ketika membesar. Perbedaan kecil antara kolom rumus dan kolom empiris wajar terjadi karena simulasi hanya menarik sepuluh ribu sampel, bukan seluruh sampel yang mungkin. Kurva pada grafik menurun tajam di awal kemudian melandai, sehingga tambahan sampel paling berharga ketika sampel masih kecil.
Hukum akar kuadrat#
Standard error berbanding terbalik dengan akar kuadrat dari , sehingga penurunannya tidak linier. Mengalikan ukuran sampel kali hanya memperkecil SE sebesar faktor , sebagaimana dinyatakan perbandingan berikut. Hukum ini sekaligus menjelaskan mengapa kurva pada grafik sebelumnya melandai di bagian kanannya.
Apabila sampel dikalikan 4, SE menjadi setengahnya, dan keluaran simulasi menunjukkan rasio 1.9891 antara dan , sangat dekat dengan nilai teoretis 2. Pola yang sama tampak pada pasangan lain, yaitu SE empiris turun dari 0.4767 pada menjadi 0.2093 pada , atau penurunan sekitar 56% setelah sampel dikalikan 5. Konsekuensinya, sekadar menggandakan sampel memberi efek yang terbatas. Menaikkan dari 200 menjadi 400 hanya menurunkan SE sekitar 29%, sedangkan kenaikan dari 10 menjadi 50 menurunkannya sekitar 55%. Rencana pengumpulan data yang realistis memperhitungkan imbal hasil yang makin mengecil ini.
Kesalahan umum#
Kesalahan pertama adalah melaporkan simpangan baku data sebagai standard error tanpa menyebut objek yang diukur. Pembaca laporan akan menaksir ketidakpastian rata-rata jauh lebih besar dari kenyataannya apabila jam dibaca seolah-olah SE. Kesalahan kedua adalah mengira simpangan baku ikut mengecil ketika sampel diperbesar. Nilai tetap berputar di sekitar pada setiap ukuran sampel, sedangkan yang menurun mengikuti adalah SE-nya.
Kesalahan ketiga adalah membaca SE sebagai jarak khas pengamatan individu. Nilai SE 0.47 jam tidak berarti sebagian besar durasi tidur berkerumun di sekitar rata-rata, karena jarak khas pengamatan tetap diatur oleh yang besarnya sekitar 1.5 jam. Kesalahan keempat adalah membandingkan dua estimasi hanya dari selisih nilainya tanpa memperhitungkan standard errornya. Dua rata-rata yang selisihnya tipis dapat saling tumpang tindih begitu ketidakpastiannya diikutsertakan, sedangkan selisih yang sama pada sampel yang jauh lebih besar dapat menjadi bukti yang berarti.
Ringkasan#
- Simpangan baku mengukur sebaran data dalam satu sampel, sedangkan standard error mengukur sebaran estimator antarsampel.
- Standard error rata-rata sampel dihitung dengan dan mengecil mengikuti hukum akar kuadrat.
- Mengalikan ukuran sampel 4 kali hanya memperkecil SE setengahnya, sehingga tambahan sampel memberi perbaikan yang makin kecil.
- Nilai tidak mengecil ketika membesar, yang mengecil adalah SE-nya.
Referensi#
- numpy.std — NumPy — Dokumentasi simpangan baku NumPy yang menjadi dasar perhitungan SE empiris.
- numpy.random.Generator.normal — NumPy — Dokumentasi pembangkit sampel normal yang digunakan pada simulasi.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika dengan pembahasan variasi pensampelan dan standard error.
- NIST/SEMATECH e-Handbook of Statistical Methods — NIST — Pegangan teknik statistika terapan dari lembaga metrologi Amerika Serikat.