Estimasi titik menyembunyikan ketidakpastiannya di dalam satu bilangan, sehingga laporan yang andal perlu menyertakan rentang kemungkinan. Topik ini membahas interval kepercayaan (confidence interval) untuk rata-rata populasi, yaitu rentang yang dibangun dari estimasi titik dan standard error pada taraf kepercayaan (confidence level) tertentu. Konstruksinya diperlihatkan lebih dahulu, kemudian makna angka 95% diuji melalui simulasi cakupan, dan pembahasan ditutup dengan salah tafsir yang paling sering muncul.
Konstruksi interval dari estimasi titik#
Interval kepercayaan untuk rata-rata populasi melebarkan estimasi titik ke dua arah sebesar kali standard error. Nilai ditentukan oleh taraf kepercayaan yang dipilih, dan taraf 95% menempatkan sisa 5% secara sama besar di kedua ekor kurva normal. Karena itu dibaca dari kuantil 0.975, sebagaimana dihitung program berikut untuk satu sampel waktu tunggu loket.
Kuantil 0.975 dipilih karena sisa 5% dibagi dua ekor, yaitu 2.5% pada setiap sisi kurva. Nilai 1.96 yang muncul dari perhitungan itu kemudian menjadi salah satu bilangan yang paling sering ditemui dalam laporan statistika terapan. Lebar intervalnya dipengaruhi tiga faktor sekaligus, yaitu sebaran data yang memperlebarnya, ukuran sampel yang menyempitkannya melalui standard error, dan taraf kepercayaan yang menambah nilai . Ketiganya bekerja dalam satu rumus, sehingga perubahan pada satu faktor langsung terbaca pada lebar interval yang dihasilkan. Menaikkan taraf ke 99% menggeser menjadi sekitar 2.58 dan melebarkan interval yang sama, sedangkan menurunkannya ke 90% menyempitkannya dengan sekitar 1.64.
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)

# Populasi: waktu tunggu loket (menit) dimodelkan normal dengan mu = 12, sigma = 3
mu, sigma = 12.0, 3.0
n = 40
z_bintang = stats.norm.ppf(0.975)
print(f"z* untuk taraf kepercayaan 95% = {z_bintang:.4f}")

sampel = rng.normal(mu, sigma, size=n)
xbar = sampel.mean()
s = sampel.std(ddof=1)
bawah = xbar - z_bintang * s / np.sqrt(n)
atas = xbar + z_bintang * s / np.sqrt(n)
print(f"xbar = {xbar:.4f}, s = {s:.4f}")
print(f"Interval kepercayaan 95% = [{bawah:.4f}, {atas:.4f}]")z* untuk taraf kepercayaan 95% = 1.9600
xbar = 12.1148, s = 2.4775
Interval kepercayaan 95% = [11.3470, 12.8826]Keluaran menunjukkan untuk taraf 95%, dan sampel waktu tunggu menghasilkan interval dari 11.3470 hingga 12.8826 menit. Batasnya simetris terhadap , sedangkan lebarnya tumbuh ketika sebaran data membesar atau mengecil. Apabila sampel kedua ditarik, intervalnya hampir pasti berbeda karena dan yang menyusunnya ikut berubah. Interval ini hanyalah satu kandidat jawaban, dan keandalannya baru terasa ketika prosedurnya diulang pada banyak sampel.
Makna taraf kepercayaan lewat simulasi cakupan#
Angka 95% pada nama intervalnya bukan peluang tentang satu interval, melainkan keandalan prosedurnya dalam jangka panjang. Cara mengujinya adalah mengulang penarikan sampel berkali-kali, membangun satu interval dari setiap sampel, lalu menghitung persentase interval yang memuat . Persentase itu dinamakan cakupan (coverage), dan prosedur yang baik menghasilkan cakupan yang mendekati taraf kepercayaannya. Cakupan hanya dapat diperiksa pada banyak interval sekaligus, karena satu interval tidak memberi tahu apakah dirinya termasuk yang berhasil atau yang meleset.
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D

rng = np.random.default_rng(42)

# Populasi: waktu tunggu loket (menit) dimodelkan normal dengan mu = 12, sigma = 3
mu, sigma = 12.0, 3.0
n = 40
banyak_sampel = 1000
z_bintang = stats.norm.ppf(0.975)

# Satu interval kepercayaan per sampel, diulang untuk seribu sampel
sampel = rng.normal(mu, sigma, size=(banyak_sampel, n))
xbar = sampel.mean(axis=1)
se = sampel.std(axis=1, ddof=1) / np.sqrt(n)
bawah = xbar - z_bintang * se
atas = xbar + z_bintang * se
memuat = (bawah <= mu) & (mu <= atas)
print(f"Cakupan: {memuat.mean() * 100:.1f}% dari {banyak_sampel} interval memuat mu sejati")

# Gambar 50 interval pertama, biru memuat mu dan oranye tidak memuat mu
fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
for i in range(50):
    warna = "#4c72b0" if memuat[i] else "#dd8452"
    ax.plot([bawah[i], atas[i]], [i + 1, i + 1], color=warna, linewidth=2)
ax.axvline(mu, color="#333333", linestyle="--", linewidth=1.5)
ax.set_xlabel("Batas interval kepercayaan (menit)")
ax.set_ylabel("Nomor sampel")
ax.set_title("Interval kepercayaan 95% dari 50 sampel")
legenda = [
    Line2D([0], [0], color="#4c72b0", linewidth=2, label="Memuat μ"),
    Line2D([0], [0], color="#dd8452", linewidth=2, label="Tidak memuat μ"),
    Line2D([0], [0], color="#333333", linewidth=1.5, linestyle="--", label="μ sejati"),
]
ax.legend(handles=legenda)
fig.savefig("interval-sampel.png", dpi=110)Cakupan: 94.3% dari 1000 interval memuat mu sejati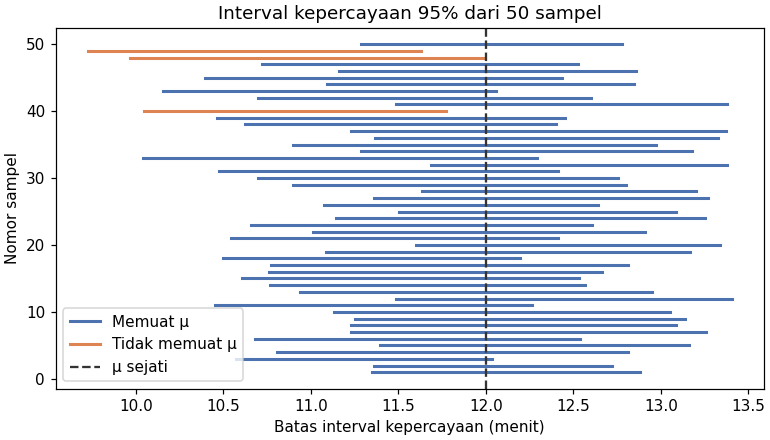
Dari seribu interval, 94.3% memuat , sangat dekat dengan janji taraf kepercayaan 95%. Gambar memperlihatkan lima puluh interval pertama sebagai garis horizontal, dengan 47 interval biru yang memuat garis dan tiga interval oranye yang meleset. Sampel yang tidak sengaja menarik pengamatan terlalu besar atau terlalu kecil menghasilkan interval yang bergeser, dan beberapa di antaranya kehilangan . Melesetnya sebagian kecil interval memang dirancang, bukan cacat, karena interval yang selalu memuat tidak memberi informasi apa pun tentang letaknya.
Taraf 95% menjadi pilihan yang lazim karena kebiasaan, bukan karena batas matematis. Taraf 90% menghasilkan interval yang lebih sempit dengan keandalan yang lebih rendah, sedangkan taraf 99% melakukan sebaliknya. Pilihan akhirnya menimbang lebar interval yang masih berguna melawan risiko meleset yang masih dapat diterima pada konteks laporannya. Apa pun tarifanya, simulasi cakupan seperti di atas tetap menjadi cara paling langsung untuk memeriksa janji prosedurnya.
Kesalahan umum#
Kesalahan pertama adalah membaca 95% sebagai persentase data yang tercakup interval. Batas 11.3470 dan 12.8826 pada contoh di atas tidak mengurung 95% waktu tunggu, karena rentang yang mengurungi sebaran data dihitung dengan aturan lain, yaitu aturan 68-95-99.7 pada distribusi normal. Yang dipatok 95% adalah prosedurnya, bukan isi datanya.
Kesalahan kedua adalah tetap menggunakan pada sampel kecil dengan tidak diketahui. Rumus di atas mengandalkan kurva normal, sedangkan sampel kecil menuntut distribusi dengan derajat kebebasan , misalnya melalui stats.t.ppf(0.975, df=n-1). Nilai derajat kebebasan yang salah menghasilkan batas yang kurang pas, sehingga argumennya wajib diperiksa sebelum keluaran dipakai. Kesalahan ketiga adalah menaikkan taraf kepercayaan tanpa menyadari konsekuensinya. Taraf 99% memerlukan sehingga intervalnya melebar, dan hilangnya presisi itulah harga yang dibayar untuk keyakinan yang lebih besar. Apabila interval terasa terlalu lebar, perbaikan yang jujur adalah menambah data, bukan menurunkan taraf kepercayaan tanpa memberitahukannya.
Ringkasan#
- Interval kepercayaan melebarkan estimasi titik ke dua arah sebesar kali standard error.
- Nilai untuk taraf 95% diperoleh dari kuantil 0.975 kurva normal.
- Simulasi seribu sampel menghasilkan cakupan 94.3%, sesuai janji prosedur pada taraf 95%.
- Taraf kepercayaan menyatakan keandalan prosedur jangka panjang, bukan peluang posisi dan bukan persentase data.
Referensi#
- scipy.stats.norm — SciPy — Dokumentasi distribusi normal SciPy beserta fungsi ppf untuk menghitung kuantil.
- scipy.stats.t — SciPy — Dokumentasi distribusi t untuk interval kepercayaan pada sampel kecil.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika dengan pembahasan interval kepercayaan dan cakupannya.