Rumus interval kepercayaan bertumpu pada kurva normal, padahal data nyata sering miring sehingga landasan itu goyah. Topik ini membahas bootstrap, yaitu metode pensampelan ulang (resampling) yang membangun interval kepercayaan langsung dari sampel itu sendiri tanpa rumus distribusi. Mekanisme resample dengan pengembalian dibahas lebih dahulu, kemudian intervalnya dibangun pada data waktu tunggu yang miring, dan perbandingan cakupannya dengan rumus normal ditutup dengan pembacaan yang jujur atas hasilnya.
Ide sampel sebagai populasi pengganti#
Bootstrap memperlakukan sampel sebagai populasi pengganti, lalu meniru proses pensampelan dari kumpulan nilai itu ribuan kali. Satu resample berisi nilai yang ditarik dengan pengembalian (with replacement) dari sampel asli, sehingga beberapa nilai muncul lebih dari sekali dan beberapa tidak muncul sama sekali. Statistik yang ditaksir dihitung pada setiap resample, dan ribuan statistik itu membentuk gambaran sebarannya. Batas interval kepercayaan 95% diambil dari persentil (percentile) ke-2.5 dan ke-97.5 sebaran tersebut, yaitu dan .
Prosedur lengkapnya berjalan dalam empat langkah berikut.
- Tarik satu resample berisi nilai dari sampel dengan pengembalian.
- Hitung statistik yang ditaksir, misalnya rata-rata, pada resample itu.
- Ulangi dua langkah sebelumnya hingga ribuan resample terkumpul.
- Ambil persentil 2.5 dan 97.5 dari seluruh statistik resample sebagai batas interval.
Pengembalian adalah syarat yang membuat variasi antarresample muncul. Tanpa pengembalian, setiap resample hanya menyusun ulang nilai yang sama persis sehingga statistiknya tidak pernah berubah dan intervalnya kehilangan lebar. Keandalan batas persentil juga bergantung pada banyaknya resample, sehingga jumlah ribuan menjadi pilihan bawaan yang wajar. Biayanya rendah karena seluruh proses hanya berisi pengambilan nilai dan perhitungan ulang statistik. Sebaran yang dihasilkan juga otomatis mencerminkan keterbatasan sampel, karena sampel yang kecil menghasilkan sebaran yang lebar dan gambaran yang kasar.
Bootstrap pada data miring#
Waktu tunggu loket lazimnya miring ke kanan, yaitu sebagian kecil pengguna menunggu jauh lebih lama daripada yang lain. Program berikut menarik satu sampel berisi dua puluh pengamatan dari populasi eksponensial dengan rata-rata 5 menit, membangun interval rumus normal dan interval bootstrap dari data yang sama, lalu menggambarkan histogram sebaran statistik bootstrap. Histogram itulah yang dipakai membaca bentuk sebaran statistik, bukan bentuk data mentahnya.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)

# Satu sampel kecil dari populasi miring: waktu tunggu loket (menit)
# Populasi eksponensial dengan rata-rata 5 menit, sampel berisi 20 pengamatan
data = rng.exponential(scale=5.0, size=20)
n = data.size
banyak_resample = 10000

# Interval rumus normal: xbar +- 1.96 * s/akar n
xbar = data.mean()
se = data.std(ddof=1) / np.sqrt(n)
bawah_rumus = xbar - 1.96 * se
atas_rumus = xbar + 1.96 * se

# Bootstrap: 10000 resample dengan pengembalian, lalu persentil 2.5 dan 97.5
indeks = rng.choice(n, size=(banyak_resample, n), replace=True)
rata_resample = data[indeks].mean(axis=1)
bawah_boot, atas_boot = np.percentile(rata_resample, [2.5, 97.5])

print(f"Estimasi titik xbar       = {xbar:.4f}")
print(f"Interval rumus normal 95% = [{bawah_rumus:.4f}, {atas_rumus:.4f}]")
print(f"Interval bootstrap 95%    = [{bawah_boot:.4f}, {atas_boot:.4f}]")

fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.hist(rata_resample, bins=40, color="#4c72b0", edgecolor="white")
ax.axvline(bawah_boot, color="#dd8452", linestyle="--", linewidth=1.5, label="Persentil 2.5")
ax.axvline(atas_boot, color="#dd8452", linestyle="--", linewidth=1.5, label="Persentil 97.5")
ax.axvline(xbar, color="#55a868", linewidth=2, label="Rata-rata sampel")
ax.set_xlabel("Rata-rata resample bootstrap (menit)")
ax.set_ylabel("Frekuensi")
ax.set_title("Sebaran 10000 rata-rata resample bootstrap")
ax.legend()
fig.savefig("bootstrap-histogram.png", dpi=110)Estimasi titik xbar = 5.2470
Interval rumus normal 95% = [3.1794, 7.3147]
Interval bootstrap 95% = [3.3128, 7.3215]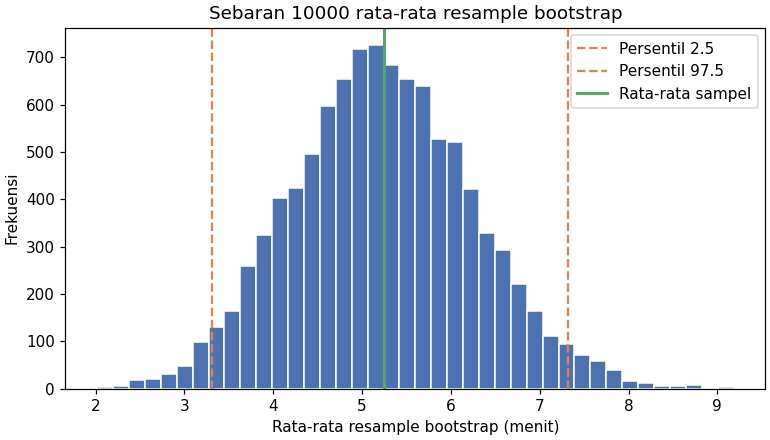
Dua interval pada keluaran tidak sama. Interval rumus selalu simetris di sekitar , sedangkan interval bootstrap bergeser, yaitu jarak batas bawahnya ke estimasi titik lebih pendek daripada jarak batas atasnya. Pola itu mengikuti histogram, yang memperlihatkan sebaran rata-rata resample condong ke kanan dengan ekor panjang. Kedekatan batas atas kedua interval adalah kebetulan, sedangkan pergeseran batas bawahlah yang menjadi petunjuk kemiringan. Asimetri semacam inilah alasan rumus normal diragukan pada data miring, karena rumus itu memaksakan simetri yang tidak dimiliki sebaran sebenarnya.
Perbandingan cakupan pada banyak sampel#
Satu perbandingan pada satu sampel belum menunjukkan mana yang lebih andal, sehingga kedua metode diuji pada dua ribu sampel miring lain dengan ukuran yang sama. Setiap sampel menghasilkan dua interval, satu dari rumus normal dan satu dari bootstrap persentil, kemudian dihitung persentase interval yang memuat . Kedua metode sama-sama mengaku memberi taraf 95%, sehingga cakupan yang jauh dari angka itu menandakan janji yang tidak ditunaikan.
import numpy as np

rng = np.random.default_rng(43)

# Cakupan dua metode interval pada populasi miring: eksponensial dengan mu = 5
mu = 5.0
n = 20
banyak_sampel = 2000
banyak_resample = 1000

tercakup_rumus = 0
tercakup_boot = 0
for _ in range(banyak_sampel):
    data = rng.exponential(scale=mu, size=n)
    xbar = data.mean()
    se = data.std(ddof=1) / np.sqrt(n)
    if xbar - 1.96 * se <= mu <= xbar + 1.96 * se:
        tercakup_rumus += 1
    rata_resample = rng.choice(data, size=(banyak_resample, n), replace=True).mean(axis=1)
    bawah, atas = np.percentile(rata_resample, [2.5, 97.5])
    if bawah <= mu <= atas:
        tercakup_boot += 1

print(f"Cakupan rumus normal : {tercakup_rumus / banyak_sampel * 100:.1f}%")
print(f"Cakupan bootstrap : {tercakup_boot / banyak_sampel * 100:.1f}%")Cakupan rumus normal : 91.0%
Cakupan bootstrap : 90.6%Kedua interval sama-sama berlabel 95%, tetapi keduanya berhenti di sekitar 91% pada sampel sekecil ini. Rumus normal menjangkau 91.0%, sedangkan bootstrap persentil berada di 90.6%, sehingga bootstrap tidak otomatis menaikkan cakupan hingga target pada . Kesenjangannya menurun ketika membesar karena teorema limit pusat membuat sebaran rata-rata sampel makin mendekati normal, pada populasi miring sekalipun. Nilai utama bootstrap terletak di tempat lain, yaitu kebebasannya dari rumus serta kesesuaian bentuk intervalnya dengan sebaran statistik yang sebenarnya, sebagaimana terlihat pada histogram sebelumnya. Apabila cakupan yang lebih dekat ke target benar-benar dipersyaratkan pada data miring, varian yang lebih maju dan terkoreksi bias, misalnya BCa, tersedia melalui argumen method pada scipy.stats.bootstrap.
Kesalahan umum#
Kesalahan pertama adalah menarik resample tanpa pengembalian. Setiap resample kemudian hanya menyusun ulang nilai yang sama, statistiknya tidak pernah berubah, dan interval yang terbentuk menyusut menjadi satu titik di sekitar estimasi. Kesalahan kedua adalah menggunakan terlalu sedikit resample, misalnya seratus, sehingga batas persentilnya bergantung pada kebetulan dan berubah-ubah antareksekusi. Menambah resample tidak mengubah data, tetapi membuat batas persentilnya stabil sehingga eksekusi ulang kode menghasilkan angka yang sama.
Kesalahan ketiga adalah menganggap bootstrap memperbaiki sampel yang buruk. Sampel yang bias sejak penarikannya tetap menghasilkan estimasi yang bias, karena bootstrap hanya mengukur sebaran statistik dari data yang ada, bukan menambah informasi baru. Kesalahan keempat adalah membaca interval bootstrap yang sempit sebagai bukti data yang banyak. Lebar intervalnya tetap dibatasi oleh dua puluh pengamatan yang tersedia, sehingga laporan tetap perlu menyebut ukuran sampel di samping intervalnya.
Ringkasan#
- Bootstrap menarik resample dengan pengembalian dari sampel itu sendiri, lalu mengambil persentil 2.5 dan 97.5 dari sebaran statistiknya sebagai batas interval.
- Metode ini tidak memerlukan rumus distribusi dan mengikuti bentuk sebaran statistik yang sebenarnya.
- Pada data eksponensial dengan , cakupan rumus normal 91.0% dan bootstrap 90.6%, sehingga kedua metode sama-sama meleset dari target 95% pada sampel kecil.
- Pengembalian pada setiap resample dan jumlah resample yang ribuan adalah syarat hasil yang bermakna.
Referensi#
- numpy.random.Generator.choice — NumPy — Dokumentasi pengambilan sampel acak dengan argumen replace untuk resample bootstrap.
- numpy.percentile — NumPy — Dokumentasi fungsi persentil yang menetapkan batas interval bootstrap.
- scipy.stats.bootstrap — SciPy — Implementasi bootstrap siap pakai dari SciPy beserta pilihan interval persentilnya.
- OpenIntro Statistics — OpenIntro — Buku pengantar statistika dengan pembahasan inferensia berbasis simulasi.