Topik ini membahas dua distribusi kontinu yang paling sering digunakan, yaitu uniform sebagai model peluang yang merata dan normal sebagai model kurva lonceng. Pembahasan mencakup cara menghasilkan keduanya di NumPy, parameter yang membentuk kurva normal, verifikasi aturan 68-95-99,7 lewat CDF, dan standardisasi menjadi skor z. Seluruh klaim teoretis diverifikasi dengan simulasi agar angkanya terukur.
Distribusi uniform: peluang yang merata#
Distribusi uniform kontinu memberikan kepadatan yang sama tingginya pada seluruh selang , sehingga peluang hanya bergantung pada panjang intervalnya. Contoh netralnya adalah pemilihan waktu inspeksi acak di loket kampus, yaitu satu titik waktu yang dipilih sama mungkin pada rentang satu jam. Peluang inspeksi jatuh pada lima belas menit pertama sama besarnya dengan lima belas menit ketiga karena panjang intervalnya sama. Rata-ratanya berada tepat di tengah selang, yaitu 30 menit.
Skrip berikut menghasilkan waktu inspeksi untuk seratus ribu pemilihan fiktif, lalu menghitung peluang pada empat subinterval yang panjangnya sama, yaitu 15 menit per interval. Bila model uniform benar, keempat peluang itu harus sama besar. Rata-rata simulasinya juga dibandingkan dengan nilai tengah selang.
"""Ciri distribusi uniform: peluang sebanding dengan panjang interval."""
import numpy as np

rng = np.random.default_rng(42)
waktu = rng.uniform(0.0, 60.0, size=100_000)

print(f"Rata-rata simulasi            : {np.mean(waktu):.4f}")
print(f"Rata-rata teoretis            : {30.0:.4f}")
print(f"P(0 <= X < 15)      simulasi  : {np.mean((waktu >= 0.0) & (waktu < 15.0)):.4f}")
print(f"P(15 <= X < 30)     simulasi  : {np.mean((waktu >= 15.0) & (waktu < 30.0)):.4f}")
print(f"P(30 <= X < 45)     simulasi  : {np.mean((waktu >= 30.0) & (waktu < 45.0)):.4f}")
print(f"P(45 <= X <= 60) simulasi : {np.mean((waktu >= 45.0) & (waktu <= 60.0)):.4f}")Rata-rata simulasi : 30.0375
Rata-rata teoretis : 30.0000
P(0 <= X < 15) simulasi : 0.2495
P(15 <= X < 30) simulasi : 0.2480
P(30 <= X < 45) simulasi : 0.2529
P(45 <= X <= 60) simulasi : 0.2497Keempat peluang hasil simulasi berkumpul di sekitar 0.25, dan rata-rata waktu simulasinya berhimpitan dengan nilai tengah 30.0. Kesamaan itu persis ciri uniform, yaitu peluang sebanding dengan panjang interval sehingga kepadatannya konstan. Karena total luas harus 1 pada selang yang panjangnya 60 menit, tinggi kepadatannya adalah
Dengan kepadatan itu, peluang inspeksi jatuh pada lima belas menit mana pun dihitung sebagai luas persegi panjang lebar 15 dan tinggi , yaitu 0.25. Dua interval yang panjangnya sama pun selalu berpeluang sama besar. Sifat sederhana ini menjadikan uniform titik tolak yang cocok untuk memahami PDF sebelum bergerak ke kurva yang lebih berbentuk.
Distribusi normal: kurva lonceng dengan dua parameter#
Distribusi normal adalah model kurva lonceng yang simetris terhadap rata-ratanya, digunakan luas untuk data pengukuran seperti tinggi badan atau hasil pembacaan sensor. Dua parameternya menentukan seluruh bentuk kurva, yaitu sebagai posisi puncak sekaligus rata-rata dan sebagai lebar sekaligus simpangan baku (standard deviation). Semakin besar , semakin lebar dan rendah loncengnya. Karena simetris, separuh luas berada di kiri dan separuhnya di kanan.
Skrip berikut menghasilkan tinggi badan seratus ribu orang dewasa fiktif dari model normal dengan cm dan cm. Histogram kepadatannya digambar berdampingan dengan kurva normal teoretis dari scipy.stats.norm. Lonceng hasil simulasi diharapkan menutupi kurva teoretisnya.
"""Histogram tinggi badan sampel dibandingkan dengan kurva normal teoretis."""
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

rng = np.random.default_rng(42)
tinggi = rng.normal(170.0, 8.0, size=100_000)

xs = np.linspace(140.0, 200.0, 400)
fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.hist(tinggi, bins=60, density=True, alpha=0.6, label="Histogram simulasi")
ax.plot(xs, stats.norm.pdf(xs, 170.0, 8.0), "r-", linewidth=2,
        label="PDF normal teoretis")
ax.set_xlabel("Tinggi badan (cm)")
ax.set_ylabel("Kepadatan")
ax.set_title("Normal mu=170, sigma=8: simulasi vs teori")
ax.legend()
fig.savefig("histogram-pdf-normal.png", dpi=110)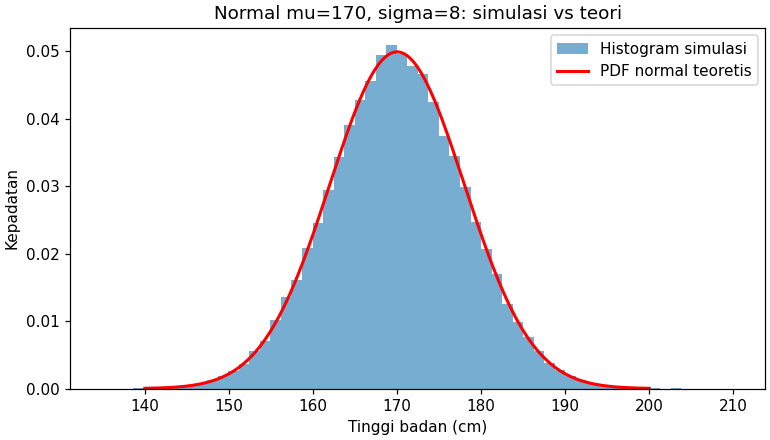
Lonceng hasil simulasi menutupi kurva teoretis, dengan puncak di 170 dan sebaran yang lebar kira-kira 8 cm ke tiap sisi. Sebagian besar data terlihat berkumpul antara 150 dan 190, yaitu sekitar dua sampai tiga simpangan baku dari pusatnya. Kurva teoretis itu adalah PDF normal, yang dituliskan dengan rumus
Rumus di atas menjelaskan sifat-sifat yang tampak pada gambar. Nilai maksimum saat , lalu mengecil secara simetris seiring menjauhnya dari . Nilai bukan peluang, melainkan kepadatan, sehingga peluang tetap dibaca sebagai luas di bawah kurva.
Aturan 68-95-99,7#
Aturan 68-95-99,7 menyatakan bahwa sekitar 68% data normal berada antara dan simpangan baku dari rata-rata, sekitar 95% antara dan , dan sekitar 99.7% antara dan . Aturan ini sering dikutip tanpa bukti, padahal dapat diverifikasi langsung dengan CDF. Skrip berikut menghitung luas ketiga selang itu pada normal standar, lalu menggambarkan dua selang pertamanya.
"""Verifikasi aturan 68-95-99,7 dengan CDF normal dan gambarnya."""
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

mu, sigma = 0.0, 1.0
standar = stats.norm(mu, sigma)
for z in (1, 2, 3):
    luas = standar.cdf(z) - standar.cdf(-z)
    print(f"P(-{z} <= Z <= {z}) = {luas:.4f}")

xs = np.linspace(-4.0, 4.0, 400)
ys = standar.pdf(xs)
fig, ax = plt.subplots(figsize=(7, 4), constrained_layout=True)
ax.plot(xs, ys, "k-", linewidth=2)
ax.fill_between(xs, ys, where=(xs >= -1) & (xs <= 1), alpha=0.5,
                label="68% (antara -1 dan 1)")
ax.fill_between(xs, ys, where=(xs >= -2) & (xs <= 2), alpha=0.25,
                label="95% (antara -2 dan 2)")
ax.set_xlabel("Skor z")
ax.set_ylabel("Kepadatan")
ax.set_title("Kurva normal standar dengan area 68% dan 95%")
ax.legend()
fig.savefig("kurva-normal-68-95.png", dpi=110)P(-1 <= Z <= 1) = 0.6827
P(-2 <= Z <= 2) = 0.9545
P(-3 <= Z <= 3) = 0.9973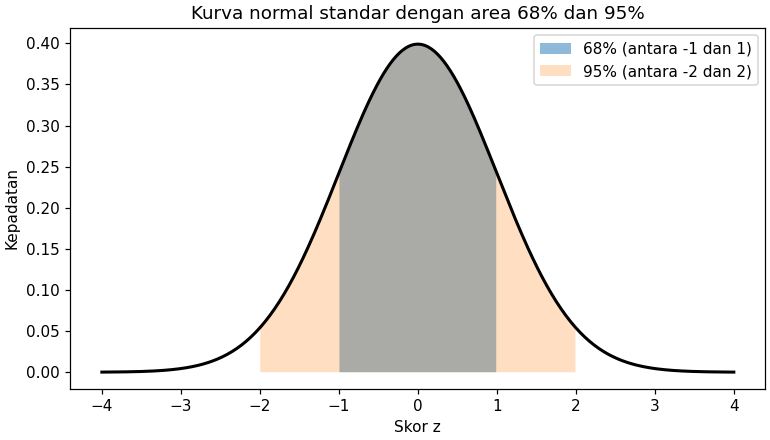
Keluaran menunjukkan 0.6827, 0.9545, dan 0.9973, berdekatan dengan angka 68%, 95%, dan 99.7% pada aturannya. Selisih kecil muncul karena aturan itu sendiri merupakan pembulatan. Gambar pendampingnya memperlihatkan area 68% yang lebih gelap terkurung oleh area 95% yang lebih lebar, keduanya terukur dari CDF dan bukan sekadar diklaim.
Standardisasi menjadi skor z#
Standardisasi mengubah nilai dari distribusi normal apa pun menjadi skor z, yaitu jarak ke rata-rata yang diukur dalam satuan simpangan baku dengan rumus . Skor z menyatukan skala yang berbeda menjadi satu acuan, yaitu normal standar dengan dan . Dengan acuan itu, CDF normal standar sudah cukup untuk membaca peluang semua distribusi normal.
Skrip berikut menghitung skor z untuk tiga tinggi badan dari model dan , lalu membaca peluang kumulatifnya dengan CDF. Nilai 154 cm dipilih karena berjarak tepat dua simpangan baku di bawah rata-rata, sedangkan 186 cm berjarak dua di atasnya. Nilai 170 cm menjadi titik tengahnya.
"""Standardisasi tinggi badan menjadi skor z dan peluangnya."""
from scipy import stats

mu, sigma = 170.0, 8.0
normal = stats.norm(mu, sigma)
for x in (154.0, 170.0, 186.0):
    z = (x - mu) / sigma
print(f"x = {x:.1f} cm -> z = {z:.4f} -> P(Z < z) = {normal.cdf(x):.4f}")x = 154.0 cm -> z = -2.0000 -> P(Z < z) = 0.0228
x = 170.0 cm -> z = 0.0000 -> P(Z < z) = 0.5000
x = 186.0 cm -> z = 2.0000 -> P(Z < z) = 0.9772Skor z mengubah pertanyaan tentang tinggi badan menjadi pertanyaan tentang normal standar, dan jawabannya konsisten dengan aturan sebelumnya, yaitu 0.0228 dan 0.9772 pada batas dua simpangan baku. Selisih juga menegaskan simetri kurva. Dengan kebiasaan yang sama, dua data berskala berbeda dapat diperbandingkan lewat skor z masing-masing.
Kesalahan umum#
- Menggunakan aturan 68-95-99,7 pada data yang tidak berbentuk lonceng. Data menceng seperti waktu antarkedatangan memiliki ekor panjang, sehingga persentase aturannya tidak berlaku. Perbaikannya, periksa histogram terlebih dahulu sebelum menyimpulkan apa pun dari aturan ini.
- Membaca luas dua sisi sebagai peluang satu sisi. Nilai 0.6827 mencakup dua sisi kurva, sedangkan peluang di atas satu simpangan baku hanya sekitar 0.16. Perbaikannya, bagi luas dua sisi dengan dua bila yang ditanyakan hanya satu sisi, atau langsung gunakan CDF.
- Lupa menyesuaikan parameter saat menstandardisasi. Skor z menggunakan rata-rata dan simpangan baku dari sumber data yang sama, sehingga parameter dari model lain menghasilkan skor yang keliru. Perbaikannya, hitung dan dari data yang sedang dianalisis.
Ringkasan#
- Uniform memberi kepadatan konstan pada sebuah selang, sehingga peluang sebanding dengan panjang intervalnya.
- Normal dikendalikan dua parameter, yaitu sebagai posisi puncak dan sebagai lebar, dengan kurva yang simetris.
- Aturan 68-95-99,7 terverifikasi lewat CDF sebagai 0.6827, 0.9545, dan 0.9973.
- Skor z mengubah distribusi normal apa pun menjadi normal standar.
Referensi#
- NumPy Generator — NumPy
— Referensi resmi
rng.uniformdanrng.normalyang dipakai simulasi pada topik ini. - scipy.stats.norm — SciPy — Dokumentasi resmi distribusi normal SciPy beserta pdf dan cdf.
- Normal Distribution — NIST/SEMATECH e-Handbook of Statistical Methods — Referensi sifat distribusi normal dari pegangan resmi NIST.