Dua fitur yang mengukur hal berbeda hampir selalu membawa rentang angka yang berbeda, dan perbedaan itu dapat menggiring sebagian algoritma pada kesimpulan yang keliru. Topik ini membahas penskalaan (scaling) fitur, kapan langkah itu menentukan kinerja, kapan langkah itu tidak berpengaruh apa pun, serta transformasi log untuk distribusi yang miring. Praktiknya menggunakan dataset breast cancer bawaan scikit-learn dan data luas lahan sintetis melalui skrip penskalaan-dan-log.py. Setelah topik ini, keputusan menstandarkan fitur atau mentransformasikannya dapat diambil berdasarkan mekanisme algoritma yang dipakai, bukan berdasarkan kebiasaan.
Penskalaan dan algoritma berbasis jarak#
Penskalaan menggeser dan mengubah lebar setiap fitur agar berada pada rentang yang sebanding, dan bentuk yang paling umum adalah standardisasi berikut.
Rumus itu memusatkan setiap fitur pada rata-rata nol dengan simpangan baku satu, tanpa mengubah urutan nilainya. Algoritma yang menghitung jarak antarbaris sangat peka terhadap skala karena jarak Euclidean, yaitu panjang garis lurus antardua baris, menjumlahkan selisih kuadrat semua fitur sekaligus. Pada dataset breast cancer, fitur mean area bernilai hingga ribuan, sedangkan mean smoothness berada di sekitar 0.1, sehingga selisih area mendominasi jumlah tersebut dan selisih smoothness praktis tidak terhitung. KNN (k-nearest neighbors) mengukur jarak persis seperti itu, sehingga tetangga yang ditemukannya ditentukan oleh fitur dengan angka terbesar, bukan oleh fitur yang paling informatif.
Standardisasi memperbaiki ketimpangan itu dengan memberi setiap fitur lebar yang setara. Setelah ditransformasi, selisih area dan selisih smoothness masuk ke dalam perhitungan jarak dengan bobot yang seimbang, dan tetangga terdekat ditentukan oleh pola gabungan semua fitur. Perubahan perilaku semacam ini seharusnya terlihat pada akurasi, dan pengukurannya dilakukan skrip pada bagian berikutnya.
Kapan penskalaan tidak diperlukan#
Pohon keputusan bekerja dengan cara yang sama sekali berbeda, yaitu mencari satu ambang per fitur satu per satu, misalnya mean area di atas 700 atau tidak. Mengalikan seluruh nilai sebuah fitur dengan konstanta apa pun hanya menggeser ambangnya dan tidak pernah mengubah baris mana yang jatuh di kiri atau kanan ambang itu. Skala fitur dengan demikian tidak masuk ke dalam keputusan pohon sama sekali, dan urutan antarbaris yang menjadi dasar pencarian ambang juga tetap utuh. Memindahkan fitur ke satuan lain pada akhirnya hanya mengubah label ambangnya, bukan struktur pembagian yang terbentuk.
Regresi linear biasa juga relatif kebal karena koefisiennya menyesuaikan diri dengan skala setiap fitur. Penskalaan tetap disarankan pada keluarga model ini apabila regularisasi digunakan. Hukuman ridge dan lasso berbanding lurus dengan besaran koefisien tanpa memandang skala fitur, sehingga fitur berskala kecil dirugikan. Model berbasis gradient descent seperti jaringan saraf juga mencapai konvergensi lebih cepat pada fitur terstandar. Ringkasnya, keputusan menstandarkan diambil dari mekanisme algoritma dan bentuk regularisasinya, bukan dari rutinitas.
Mengukur keduanya pada satu skrip#
Skrip menjalankan tiga pengukuran pada satu eksekusi. Bagian pertama melatih KNN dengan lima tetangga pada dataset breast cancer, tanpa dan dengan StandardScaler, lalu membandingkan akurasinya pada data uji. Bagian kedua mengulang pengukuran yang sama pada pohon keputusan untuk menguji kebalannya terhadap skala. Bagian ketiga menyimulasikan 400 lahan dengan luas berdistribusi log-normal dan target yang mengikuti log luasnya, lalu membandingkan regresi linear pada luas mentah dengan regresi pada log(luas).
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeClassifier

X, y = load_breast_cancer(return_X_y=True)
X_latih, X_uji, y_latih, y_uji = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# bagian 1: KNN sensitif terhadap skala fitur
knn_mentah = KNeighborsClassifier(n_neighbors=5).fit(X_latih, y_latih)
skala = StandardScaler().fit(X_latih)
knn_skala = KNeighborsClassifier(n_neighbors=5).fit(skala.transform(X_latih), y_latih)
print(f"Akurasi KNN tanpa penskalaan   : {knn_mentah.score(X_uji, y_uji):.4f}")
print(f"Akurasi KNN dengan penskalaan  : {knn_skala.score(skala.transform(X_uji), y_uji):.4f}")

# bagian 2: pohon keputusan tidak terpengaruh skala
pohon_mentah = DecisionTreeClassifier(random_state=42).fit(X_latih, y_latih)
pohon_skala = DecisionTreeClassifier(random_state=42).fit(skala.transform(X_latih), y_latih)
print(f"Akurasi pohon tanpa penskalaan : {pohon_mentah.score(X_uji, y_uji):.4f}")
print(f"Akurasi pohon dengan penskalaan: {pohon_skala.score(skala.transform(X_uji), y_uji):.4f}")

# bagian 3: transformasi log untuk fitur yang miring
rng = np.random.default_rng(42)
m = 400
luas = rng.lognormal(mean=1.2, sigma=0.9, size=m)  # luas lahan (hektare), miring ke kanan
hasil = 4.0 + 3.2 * np.log(luas) + rng.normal(0.0, 0.6, m)

Xl, Xu, yl, yu = train_test_split(
    luas.reshape(-1, 1), hasil, test_size=0.2, random_state=42
)
model_mentah = LinearRegression().fit(Xl, yl)
model_log = LinearRegression().fit(np.log(Xl), yl)
print(f"R2 luas mentah                 : {model_mentah.score(Xu, yu):.4f}")
print(f"R2 log(luas)                   : {model_log.score(np.log(Xu), yu):.4f}")

# histogram sebelum dan sesudah transformasi log
fig, axes = plt.subplots(1, 2, figsize=(7, 3))
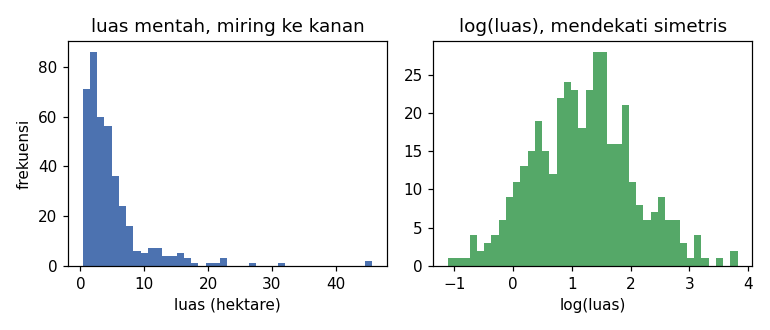
axes[0].hist(luas, bins=40, color="#4c72b0")
axes[0].set_title("luas mentah, miring ke kanan")
axes[0].set_xlabel("luas (hektare)")
axes[0].set_ylabel("frekuensi")
axes[1].hist(np.log(luas), bins=40, color="#55a868")
axes[1].set_title("log(luas), mendekati simetris")
axes[1].set_xlabel("log(luas)")
fig.tight_layout()
fig.savefig("distribusi-log.png", dpi=110)
print("Histogram disimpan ke distribusi-log.png")Akurasi KNN tanpa penskalaan : 0.9123
Akurasi KNN dengan penskalaan : 0.9561
Akurasi pohon tanpa penskalaan : 0.9123
Akurasi pohon dengan penskalaan: 0.9123
R2 luas mentah : 0.7035
R2 log(luas) : 0.9474
Histogram disimpan ke distribusi-log.pngTiga baris pertama keluaran konsisten dengan mekanisme di atas. Akurasi KNN naik dari 0.9123 menjadi 0.9561 setelah penskalaan, padahal model, data, dan pemecahan datanya sama persis. Seluruh perbaikan dengan demikian berasal dari lebar fitur yang kini setara. Akurasi pohon tertulis 0.9123 pada kedua kondisi, tepat sebagaimana teori bahwa ambang per fitur hanya bergeser dan keputusannya tidak berubah. Contoh pada data breast cancer juga menegaskan bahwa penskalaan bukan soal selera, melainkan konsekuensi dari algoritma yang menghitung jarak.
Dua baris terakhir mengukur transformasi log. Banyak pengukuran di dunia nyata berdistribusi miring ke kanan (right-skewed), yaitu sebagian besar nilai kecil dengan ekor panjang yang berisi sedikit nilai sangat besar, dan luas lahan adalah contohnya. Transformasi log memampatkan ekor itu dengan mengganti setiap nilai menjadi . Akibatnya, rasio antarnilai berubah menjadi selisih yang jauh lebih jinak, dan hubungan multiplikatif berubah menjadi hubungan linear. Hasilnya terlihat pada yang naik dari 0.7035 pada luas mentah menjadi 0.9474 pada log(luas). Histogram berikut memperlihatkan sebaran yang tadinya menumpuk di kiri menjadi hampir simetris.
Apabila data memuat nilai nol, tidak terdefinisi dan transformasi gagal. Konvensi yang lazim adalah menggunakan np.log1p, yaitu , yang mempertahankan manfaat pemampatan tanpa menghasilkan error pada nilai nol.
Kesalahan umum#
- Menghitung rata-rata dan simpangan baku dari seluruh dataset sebelum memecahnya. Statistik itu membawa informasi data uji ke dalam data latih dan menimbulkan kebocoran data. Pasang
StandardScalerhanya pada data latih, lalu terapkantransformpada data uji. - Menyimpan scaler secara terpisah dari model sehingga transformasi saat prediksi berbeda dari saat pelatihan. Penyebabnya adalah alur manual yang mudah terlewat satu langkah. Bungkus scaler dan model dalam satu
Pipelineagar transformasi data uji dan data baru berjalan dengan parameter yang sama. - Berharap penskalaan memperbaiki kemiringan. Standardisasi hanya menggeser dan memperlebar, sedangkan ekor panjangnya tetap ada. Gunakan transformasi log atau akar untuk mengubah bentuk distribusinya.
- Menskalakan fitur pada alur pohon keputusan lalu berharap skornya naik. Ambang per fitur hanya bergeser mengikuti skala baru, sehingga keputusannya identik dan langkah penskalaan hanya menambah kerja tanpa efek. Sisakan penskalaan untuk model berbasis jarak atau gradient descent.
- Menerapkan transformasi log pada fitur yang memuat nilai negatif. Logaritma hanya terdefinisi untuk nilai positif, sehingga
np.logmenghasilkan NaN dan pelatihan berhenti di tengah jalan. Periksa rentang nilai terlebih dahulu, gunakannp.log1puntuk nilai nol, dan pilih transformasi lain untuk data negatif.
Ringkasan#
- Penskalaan menyamakan rentang fitur dan wajib dilakukan untuk algoritma berbasis jarak seperti KNN, dengan statistiknya diambil dari data latih saja.
- Pohon keputusan kebal terhadap skala karena ambang per fitur menyesuaikan diri, sehingga penskalaan pada alur pohon hanya menambah langkah tanpa efek.
- Transformasi log mengubah sebaran miring ke kanan menjadi mendekati simetris dan mengubah hubungan multiplikatif menjadi linear, dengan
np.log1psebagai pengaman nilai nol. - Pilihan transformasi mengikuti mekanisme algoritma dan bentuk distribusinya, bukan kebiasaan menstandarkan semua kolom.
Referensi#
- Preprocessing data — scikit-learn — Bagian resmi tentang standardisasi beserta ragam scaler yang tersedia.
- sklearn.preprocessing.StandardScaler — scikit-learn
— Dokumentasi standardisasi fitur dengan
fitpada data latih dantransformpada data lain. - sklearn.neighbors.KNeighborsClassifier — scikit-learn — Dokumentasi KNN yang menjelaskan ketergantungannya pada metrik jarak antarbaris.