Tahap terakhir proyek ini membuka data uji satu kali untuk penilaian akhir, lalu membaca setiap error yang tersisa untuk memahami di mana dan mengapa model gagal. Topik ini membahas pelaporan hasil akhir dengan confusion matrix, pembacaan jenis error yang paling mahal, serta profil fitur dari baris yang salah ditebak. Dataset breast cancer yang telah menyertai seluruh tahapan proyek kembali menjadi datanya. Praktiknya menggunakan skrip evaluasi-akhir.py yang melatih ulang konfigurasi terpilih dari tahap penalaan, yaitu learning_rate=0.2, max_leaf_nodes=15, dan max_iter=50.
Penilaian akhir satu kali pada data uji#
Model akhir dilatih ulang pada seluruh 455 baris data latih dengan konfigurasi terpilih, kemudian dipakai menebak 114 baris data uji yang tersimpan sejak pemisahan pertama. Pembagian datanya persis sama dengan konfigurasi yang dipatok pada tahap EDA dan pemodelan, yaitu 20 persen dengan stratify=y dan random_state=42. Karena pembagiannya identik, baris uji yang dinilai tetap baris yang sama, dan baris itu tidak pernah memengaruhi keputusan apa pun sebelumnya. Prediksi dan peluang kelas ganas dicatat sekali, dan dari titik ini tidak ada lagi perubahan model yang dinilai di data yang sama.
Laporan utamanya berupa confusion matrix beserta metrik per kelas yang ditetapkan sejak definisi masalah. Dengan sebagai jumlah kasus ganas yang dikenali dan sebagai kasus ganas yang terlewat, recall kelas ganas dihitung sebagai . Presisinya dihitung sebagai , dengan sebagai prediksi ganas yang keliru.
"""Evaluasi akhir pada data uji dan analisis error model hasil penalaan."""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import confusion_matrix, f1_score, precision_score, recall_score
from sklearn.model_selection import train_test_split

data = load_breast_cancer(as_frame=True)
X, y = data.data, data.target

# pembagian yang sama sejak tahap EDA dan pemodelan: stratified, 20 persen, seed 42
X_latih, X_uji, y_latih, y_uji = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# konfigurasi terpilih dari tahap penalaan dilatih ulang pada seluruh data latih
model = HistGradientBoostingClassifier(
    learning_rate=0.2, max_leaf_nodes=15, max_iter=50, random_state=42
)
model.fit(X_latih, y_latih)

# penilaian akhir: data uji dibuka satu kali di sini
prediksi = model.predict(X_uji)
peluang = pd.Series(model.predict_proba(X_uji)[:, 0], index=X_uji.index)

cm = confusion_matrix(y_uji, prediksi, labels=[0, 1])
print("Confusion matrix data uji (baris: kelas asli, kolom: prediksi)")
print(f"  ganas  -> ganas  : {cm[0, 0]}")
print(f"  ganas  -> jinak  : {cm[0, 1]}  <- error paling mahal")
print(f"  jinak  -> ganas  : {cm[1, 0]}")
print(f"  jinak  -> jinak  : {cm[1, 1]}")
print(f"Presisi kelas ganas : {precision_score(y_uji, prediksi, pos_label=0):.4f}")
print(f"Recall kelas ganas  : {recall_score(y_uji, prediksi, pos_label=0):.4f}")
print(f"F1 kelas ganas      : {f1_score(y_uji, prediksi, pos_label=0):.4f}")

# analisis error: profil setiap baris uji yang salah ditebak
salah = X_uji.index[prediksi != y_uji]
print(f"Jumlah baris error : {len(salah)} dari {len(y_uji)} baris uji")
for i in salah:
    arah = "ganas ditebak jinak" if y_uji.loc[i] == 0 else "jinak ditebak ganas"
    print(f"  baris uji {i}: {arah}, peluang ganas = {peluang.loc[i]:.3f}, "
          f"worst concave points = {X_uji.loc[i, 'worst concave points']:.4f}")

# pembanding: rata-rata fitur kunci pada masing-masing kelas di data latih
for kelas, nama in ((0, "ganas"), (1, "jinak")):
    rata = X_latih.loc[y_latih == kelas, "worst concave points"].mean()
    print(f"Rata-rata worst concave points kelas {nama} (data latih): {rata:.4f}")

# sebaran peluang kelas ganas pada data uji menurut kelas aslinya
fig, ax = plt.subplots(figsize=(6, 3))
ax.hist(peluang[y_uji == 1], bins=20, alpha=0.6, label="Asli jinak")
ax.hist(peluang[y_uji == 0], bins=20, alpha=0.6, label="Asli ganas")
ax.axvline(0.5, color="#2b4a6f", linestyle="--", linewidth=1.2, label="Ambang 0.5")
ax.set_xlabel("Peluang kelas ganas menurut model")
ax.set_ylabel("Jumlah baris uji")
ax.legend()
fig.tight_layout()
fig.savefig("probabilitas-uji.png", dpi=110)
print("Grafik tersimpan : probabilitas-uji.png")Confusion matrix data uji (baris: kelas asli, kolom: prediksi)
ganas -> ganas : 39
ganas -> jinak : 3 <- error paling mahal
jinak -> ganas : 1
jinak -> jinak : 71
Presisi kelas ganas : 0.9750
Recall kelas ganas : 0.9286
F1 kelas ganas : 0.9512
Jumlah baris error : 4 dari 114 baris uji
baris uji 363: jinak ditebak ganas, peluang ganas = 0.585, worst concave points = 0.0912
baris uji 41: ganas ditebak jinak, peluang ganas = 0.014, worst concave points = 0.1424
baris uji 73: ganas ditebak jinak, peluang ganas = 0.019, worst concave points = 0.1383
baris uji 385: ganas ditebak jinak, peluang ganas = 0.349, worst concave points = 0.1359
Rata-rata worst concave points kelas ganas (data latih): 0.1828
Rata-rata worst concave points kelas jinak (data latih): 0.0728
Grafik tersimpan : probabilitas-uji.pngAngka-angka akhir proyek terbaca langsung dari laporan tersebut. Dari 42 kasus ganas pada data uji, 39 dikenali sehingga recall-nya 0.9286, dan dari 40 prediksi ganas hanya 1 yang keliru sehingga presisinya 0.9750. Nilai F1 kelas ganas tercatat 0.9512, berdekatan dengan perkiraan 0.9585 dari cross-validation pada tahap penalaan, dan kedekatan ini menunjukkan bahwa perkiraan validasi memang menjadi indikator yang jujur untuk hasil akhirnya.
Membaca error yang paling mahal#
Confusion matrix tidak memperlakukan semua error sama, dan justru di situlah nilainya. Baris atas pada keluaran menyatakan kasus asli ganas, dan tiga kasus di antaranya ditebak jinak. Error ini dinyatakan paling mahal pada definisi masalah karena berpotensi menunda penanganan. Error sebaliknya, yaitu satu kasus jinak yang ditebak ganas, hanya berdampak pada pemeriksaan lanjutan. Dari empat error yang ada, tiga berada pada arah yang lebih mahal, dan recall 0.9286 itulah cara metrik ini menghitung harga ketiganya.
Pembacaan arah error membuat laporan akhir dapat dinyatakan dalam bahasa keputusan, bukan sekadar satu angka akurasi. Model ini melewatkan tiga dari 42 kasus ganas, atau sekitar tujuh persen, sekaligus hampir tidak pernah salah menuduh kasus jinak. Perbandingan dengan baseline kelas terbanyak yang melewatkan seluruh 42 kasus ganas menunjukkan jarak yang ditempuh proyek ini dari titik awalnya. Setiap penyebutan hasil pada laporan proyek sebaiknya memuat kedua arah tersebut secara terpisah.
Profil baris yang salah ditebak#
Analisis error berpindah dari hitungan agregat ke baris individual, dan skrip mencetak profil setiap baris yang salah beserta peluang prediksinya. Tiga kasus ganas yang terlewat memperlihatkan pola yang konsisten pada worst concave points. Nilainya sebesar 0.1424, 0.1383, dan 0.1359, semuanya berada di antara rata-rata kelas jinak 0.0728 dan rata-rata kelas ganas 0.1828, lebih dekat ke sisi jinak. Nilai-nilai itu berada tepat di zona tumpang tindih yang sudah terlihat pada histogram EDA.
Dua di antaranya bahkan dinyatakan jinak dengan keyakinan tinggi, yaitu peluang ganas 0.014 dan 0.019, yang berarti geometri tumor tersebut benar-benar menyerupai populasi jinak pada fitur yang tersedia. Satu kasus jinak yang salah ditebak justru berbeda polanya, karena peluangnya hanya 0.585 dan dekat ambang. Nilai worst concave points baris itu 0.0912, sedikit di atas rata-rata kelas jinak.
Grafik berikut merangkum posisi seluruh baris uji berdasarkan peluang prediksinya, dan hasilnya tersimpan sebagai probabilitas-uji.png.
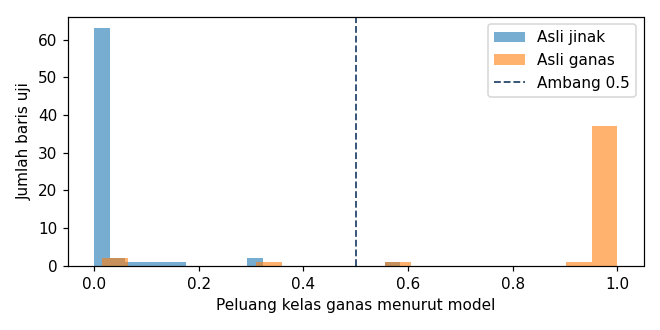
Sebagian besar baris menumpuk di kedua ujung, yaitu peluang dekat 0 untuk kasus jinak dan dekat 1 untuk kasus ganas. Keempat error berada di pita tengah, berdekatan dengan garis ambang 0.5. Kesimpulan perbaikannya mengikuti pola tersebut, karena error tidak berasal dari penyetelan yang kurang, melainkan dari keterbatasan informasi pada fitur geometri yang tersedia. Arah perbaikannya adalah data tambahan pada zona tumpang tindih atau fitur dari sumber lain di luar geometri. Alternatif yang berbeda sifatnya adalah menurunkan ambang keputusan agar lebih banyak kasus ganas tertangkap, dan pilihan itu merupakan keputusan biaya yang harus dinyatakan beserta konsekuensinya.
Kesalahan umum#
- Membuka data uji berkali-kali selama perbaikan. Setiap pembacaan tambahan mengikis netralitas data uji, dan laporan akhir kehilangan dasarnya. Data uji dibuka satu kali, sedangkan percobaan perbaikan dinilai dengan cross-validation pada data latih.
- Memperbaiki model hanya dari metrik agregat. Angka agregat menyatakan berapa banyak error tetapi tidak menyatakan mengapa error itu terjadi. Pembacaan baris error beserta fiturnya dilakukan sebelum memutuskan perbaikan.
- Menggeser ambang keputusan tanpa melaporkan konsekuensinya. Ambang yang diturunkan menaikkan recall sekaligus menurunkan presisi, dan perubahannya wajib dihitung serta dilaporkan pada kedua arah.
- Menambal error dengan penyetelan yang lebih panjang. Profil baris pada bagian sebelumnya menunjukkan sumber errornya adalah zona tumpang tindih data, dan penyetelan tambahan tidak memperkaya informasi yang tidak tersedia. Perbaikan diarahkan ke data dan fitur.
- Melaporkan hasil akhir tanpa arah error. Angka agregat seperti akurasi menyembunyikan pembagian antara kasus yang terlewat dan kasus yang salah dituduh. Laporan akhir memuat kedua arah beserta metrik per kelasnya.
- Menghapus baris error dari data karena dianggap derau. Baris yang sulit ditebak justru membawa informasi tentang batas model dan kualitas datanya. Baris error diprofilkan penyebabnya, bukan dibuang.
Ringkasan#
- Model akhir dilatih ulang pada seluruh data latih dengan konfigurasi terpilih, lalu menilai 114 baris data uji satu kali tanpa perubahan lebih lanjut.
- Hasil akhirnya berupa 39 kasus ganas dikenali dari 42, satu salah tuduh dari 40 prediksi ganas, dengan presisi 0.9750, recall 0.9286, dan F1 0.9512 yang berdekatan dengan perkiraan validasi.
- Tiga dari empat error berada pada arah yang paling mahal, dan seluruhnya berprofil di zona tumpang tindih antara kedua kelas pada fitur
worst concave points. - Analisis error mengarahkan perbaikan ke pengayaan data dan fitur serta pengaturan ambang berbasis biaya, bukan ke penyetelan model yang lebih panjang.
Referensi#
- sklearn.metrics.confusion_matrix — scikit-learn
— Dokumentasi perhitungan confusion matrix beserta parameter
labelsuntuk mengatur urutan baris dan kolomnya. - sklearn.metrics.precision_score — scikit-learn
— Dokumentasi perhitungan presisi dengan argumen
pos_labeluntuk kelas ganas. - 3.3. Metrics and scoring: quantifying the quality of predictions — scikit-learn — Panduan resmi metrik klasifikasi dan keterkaitan presisi, recall, serta F1.