Eksplorasi data (exploratory data analysis, EDA) adalah tahap memahami data sebelum model apa pun dibangun, dan keputusan fitur yang lahir dari tahap ini ikut menentukan bentuk pemodelannya. Topik ini membahas EDA pada proyek klasifikasi jinak atau ganas yang sedang dikerjakan. Pembahasannya mencakup pembacaan skala fitur, pemisahan antarkelas, dan korelasi antar-fitur pada dataset breast cancer yang telah ditetapkan sebagai masalah proyek. Praktiknya menggunakan skrip eda-awal.py yang menghitung statistik tersebut pada data latih dan menggambar distribusi fitur kuncinya.
EDA pada data latih#
EDA menghasilkan keputusan, bukan sekadar angka. Pemilihan fitur yang dipertahankan, transformasi yang diperlukan, hingga keluarga model yang relevan semuanya berpijak pada statistik yang dibaca pada tahap ini. Karena keputusan tersebut membentuk model, statistik EDA yang dihitung dari data yang mencakup baris uji berarti memasukkan informasi data uji ke dalam keputusan pemodelan. Perpindahan informasi semacam ini adalah bentuk kebocoran data (data leakage) yang halus, tanpa pesan error dan tanpa terlihat pada kode.
Cara menutup celahnya adalah menyisihkan data uji terlebih dahulu, lalu menjalankan seluruh EDA pada data latih saja. Skrip eda-awal.py melakukan pemisahan dengan konfigurasi yang dipatok untuk seluruh proyek, yaitu 20 persen untuk uji dengan stratify=y dan random_state=42. Hasilnya 455 baris data latih untuk EDA dan 114 baris data uji yang disimpan tanpa dihitung statistik apa pun. Konfigurasi yang sama digunakan ulang pada setiap tahap berikutnya sehingga baris uji tetap merupakan baris yang sama dari awal hingga akhir proyek.
Skala fitur dan pemisahan kelas#
Skrip berikut menghitung seluruh pembacaan pada topik ini, mulai dari skala fitur, perbedaan antarkelas, kekuatan pemisahan per kelompok fitur, hingga korelasi tertinggi, lalu menggambar distribusi dua fitur kuncinya.
"""EDA pada data latih: skala fitur, pemisahan kelas, dan korelasi antar-fitur."""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split

data = load_breast_cancer(as_frame=True)
X, y = data.data, data.target

# data uji disisihkan lebih dahulu, sehingga seluruh EDA hanya menyentuh data latih
X_latih, X_uji, y_latih, y_uji = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)
print(f"Baris data latih untuk EDA : {X_latih.shape[0]}")
print(f"Baris data uji (disimpan)  : {X_uji.shape[0]}")

# skala antar-fitur berbeda sangat jauh
ringkas = X_latih.agg(["mean", "std"]).T
for fitur in ("mean area", "mean symmetry"):
    print(f"Skala {fitur:<14}: rata-rata {ringkas.loc[fitur, 'mean']:.4f}, "
          f"simpangan baku {ringkas.loc[fitur, 'std']:.4f}")

# perbedaan rata-rata antarkelas pada empat kandidat fitur
latih = X_latih.copy()
latih["target"] = y_latih
for fitur in ("mean radius", "mean concavity", "mean fractal dimension",
              "worst concave points"):
    g0 = latih.loc[latih["target"] == 0, fitur].mean()
    g1 = latih.loc[latih["target"] == 1, fitur].mean()
    print(f"{fitur:<22}: ganas {g0:.4f} vs jinak {g1:.4f}")

# kekuatan pemisahan rata-rata tiap kelompok: jarak antarkelas dibagi simpangan baku
kelompok = {
    "mean": [f for f in X.columns if f.startswith("mean")],
    "error": [f for f in X.columns if f.endswith("error")],
    "worst": [f for f in X.columns if f.startswith("worst")],
}
for nama, daftar in kelompok.items():
    rasio = []
    for fitur in daftar:
        g0 = latih.loc[latih["target"] == 0, fitur].mean()
        g1 = latih.loc[latih["target"] == 1, fitur].mean()
        rasio.append(abs(g0 - g1) / X_latih[fitur].std())
    print(f"Rasio pemisahan rata-rata kelompok {nama:<6}: {sum(rasio) / len(rasio):.2f}")

# korelasi tertinggi antar-fitur sebagai indikasi fitur redundan
korelasi = X_latih.corr().abs()
atas = korelasi.where(np.triu(np.ones(korelasi.shape), k=1).astype(bool))
pasangan = atas.stack().sort_values(ascending=False)
print("Tiga pasangan fitur dengan korelasi tertinggi:")
for (a, b), nilai in pasangan.head(3).items():
    print(f"  {a} dengan {b}: {nilai:.3f}")

# distribusi dua fitur paling memisahkan kelas
fig, ax = plt.subplots(1, 2, figsize=(8, 3))
for i, fitur in enumerate(("mean radius", "worst concave points")):
    ax[i].hist(latih.loc[latih["target"] == 1, fitur], bins=25, alpha=0.6,
               label="Jinak")
    ax[i].hist(latih.loc[latih["target"] == 0, fitur], bins=25, alpha=0.6,
               label="Ganas")
    ax[i].set_title(fitur)
    ax[i].set_xlabel("Nilai fitur")
    ax[i].set_ylabel("Jumlah baris")
    ax[i].legend()
fig.tight_layout()
fig.savefig("eda-distribusi.png", dpi=110)
print("Grafik tersimpan: eda-distribusi.png")Baris data latih untuk EDA : 455
Baris data uji (disimpan) : 114
Skala mean area : rata-rata 648.5411, simpangan baku 344.9446
Skala mean symmetry : rata-rata 0.1806, simpangan baku 0.0281
mean radius : ganas 17.3812 vs jinak 12.0904
mean concavity : ganas 0.1624 vs jinak 0.0455
mean fractal dimension: ganas 0.0628 vs jinak 0.0628
worst concave points : ganas 0.1828 vs jinak 0.0728
Rasio pemisahan rata-rata kelompok mean : 1.12
Rasio pemisahan rata-rata kelompok error : 0.58
Rasio pemisahan rata-rata kelompok worst : 1.24
Tiga pasangan fitur dengan korelasi tertinggi:
mean radius dengan mean perimeter: 0.998
worst radius dengan worst perimeter: 0.993
mean radius dengan mean area: 0.989
Grafik tersimpan: eda-distribusi.pngPembacaan pertama adalah skala, karena rentang nilai antar-fitur pada dataset ini berbeda sangat jauh. Rata-rata mean area berada di sekitar 648.5 dengan simpangan baku 344.9, sedangkan rata-rata mean symmetry hanya 0.1806 dengan simpangan baku 0.0281. Selisih beberapa ribu kali ini berpengaruh langsung pada pemilihan model. Model yang bekerja dengan jarak atau gradien, misalnya regresi logistik, membutuhkan penskalaan agar setiap fitur berkontribusi setara. Model berbasis pohon tidak terpengaruh skala karena setiap pembagiannya hanya membandingkan satu fitur pada satu waktu.
Pembacaan kedua adalah pemisahan kelas pada fitur kandidat. Rata-rata mean radius kelas ganas mencapai 17.3812 berbanding 12.0904 pada kelas jinak, dan worst concave points memisahkan lebih tajam lagi dengan 0.1828 berbanding 0.0728. Sebaliknya, mean fractal dimension mencatat rata-rata yang sama hingga empat desimal pada kedua kelas, yaitu contoh fitur yang nyaris tidak membawa informasi pemisah. Rekapitulasi per kelompok menunjukkan kelompok worst paling kuat memisahkan kelas dengan rasio 1.24, disusul kelompok mean dengan 1.12, sedangkan kelompok error yang mengukur fluktuasi antartitik sampel paling lemah dengan 0.58.
Grafik berikut menggambar distribusi dua fitur kandidat terkuat pada data latih, dan hasilnya tersimpan sebagai eda-distribusi.png.
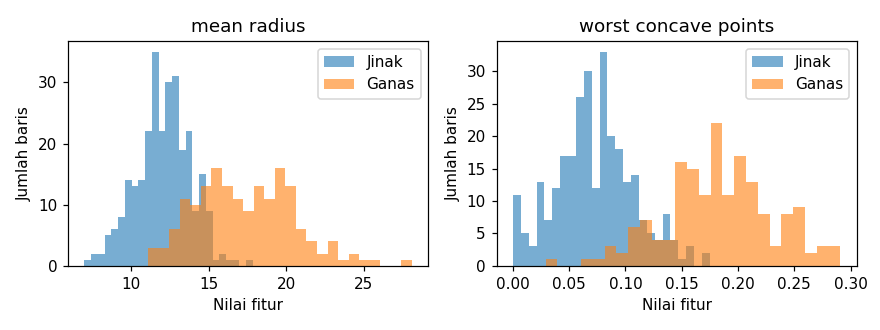
Kedua histogram memperlihatkan pola yang berbeda. mean radius tumpang tindih pada rentang 12 sampai 15, sehingga terdapat wilayah yang tidak dapat dipisahkan oleh fitur itu sendiri. worst concave points hampir terpisah penuh dengan tumpang tindih yang jauh lebih sempit, dan keberadaan wilayah tumpang tindih inilah yang kelak menjadi lokasi error model pada tahap analisis akhir. Pembacaan ini juga menetapkan ekspektasi yang realistis, yaitu akurasi sempurna tidak diperkirakan karena kedua kelas memang saling menembus pada sebagian rentang fiturnya.
Korelasi antar-fitur dan keputusan fitur#
Korelasi Pearson mengukur hubungan linear antara dua fitur dengan pada rentang -1 sampai 1, dan dihitung sebagai berikut.
Tiga pasangan dengan korelasi tertinggi pada data latih adalah mean radius dengan mean perimeter sebesar 0.998, worst radius dengan worst perimeter sebesar 0.993, dan mean radius dengan mean area sebesar 0.989. Nilai yang mendekati sempurna ini bukan kebetulan, melainkan konsekuensi geometri, karena perimeter dan area pada dasarnya adalah fungsi dari radius yang sama. Ketiganya membawa informasi ukuran yang nyaris identik, dan kelompok fitur seperti ini disebut redundan.
Implikasinya bergantung pada keluarga model yang dipakai. Pada model linear, fitur yang saling terkait erat membuat koefisien bergeser-geser antarfitur redundan dan menaikkan varians estimasinya, sehingga regularisasi atau penghapusan yang disengaja perlu dipertimbangkan. Pada model berbasis pohon, keadaan ini nyaris tidak berpengaruh karena setiap pembagian cukup memilih satu fitur terbaik dan fitur sisanya hanya mengulang informasi yang sama. Proyek ini memutuskan mempertahankan seluruh 30 fitur, karena model akhir berada di keluarga boosting, dan keputusan tersebut dicatat agar dapat ditinjau kembali apabila analisis error menuntut perubahan.
Kesalahan umum#
- Menjalankan EDA pada seluruh dataset termasuk baris uji. Statistik yang dihitung dari baris uji ikut menentukan keputusan fitur dan menimbulkan kebocoran halus. Data uji disisihkan lebih dahulu, dan EDA dijalankan pada data latih saja.
- Menghapus setiap fitur yang berkorelasi tinggi secara mekanis. Penghapusan membuang informasi yang tidak mengganggu model pohon dan masih tertahan oleh regularisasi pada model linear. Keputusan redundansi disesuaikan dengan keluarga model yang dipakai.
- Membaca korelasi EDA sebagai hubungan sebab-akibat. Korelasi hanya menyatakan asosiasi, dan fitur yang bergerak bersama bisa saja dipengaruhi faktor lain. EDA digunakan untuk membentuk hipotesis fitur, bukan untuk menyimpulkan penyebab.
- Membuang fitur yang lemah pada pembacaan individual. Fitur dengan rasio pemisahan rendah tetap dapat berguna dalam kombinasi dengan fitur lain, dan keputusan pembuangannya baru dipertimbangkan setelah analisis error menunjukkan kebutuhan yang nyata.
- Membaca EDA tanpa mencatat angkanya. Kesimpulan yang hanya bertumpu pada persepsi grafik tidak dapat dirujuk ulang ketika keputusan fitur ditinjau. Setiap pembacaan penting dicatat sebagai angka dari keluaran skrip beserta alasannya.
Ringkasan#
- EDA dijalankan pada data latih saja, karena keputusan fitur yang lahir darinya ikut membentuk model dan statistik dari baris uji merupakan kebocoran halus.
- Skala antar-fitur berbeda beberapa ribu kali, sehingga penskalaan diperlukan untuk model linear dan tidak diperlukan untuk model berbasis pohon.
worst concave pointsdanmean radiusmenjadi kandidat fitur terkuat, sedangkan kelompok error paling lemah memisahkan kelas.- Korelasi mendekati sempurna antara radius, perimeter, dan area menandakan fitur redundan, dan seluruh 30 fitur tetap dipertahankan untuk keluarga model boosting.
Referensi#
- sklearn.model_selection.train_test_split — scikit-learn
— Dokumentasi pemisahan data dengan parameter
test_size,stratify, danrandom_stateyang dipatok sepanjang proyek. - pandas.DataFrame.corr — pandas — Dokumentasi perhitungan korelasi antarkolom yang dipakai skrip EDA.
- matplotlib.pyplot.savefig — matplotlib — Dokumentasi penyimpanan gambar ke berkas PNG yang dirujuk pada topik ini.