Model yang terlalu sederhana dan model yang terlalu bebas gagal dengan cara yang berbeda, dan perbedaan itu diukur melalui dua komponen kesalahan yang disebut bias dan variance. Topik ini membahas definisi bias dan variance, gejala underfitting dan overfitting yang menyertainya, cara mendeteksi kedua kondisi dari jarak skor data latih dan data uji, serta tiga tuas yang mengendalikan ketegangannya. Praktiknya mengukur kurva kesalahan terhadap derajat polinomial pada data gelombang berderau, lalu membaca titik kompleksitas yang paling menguntungkan dari kurvanya.
Dua sumber kesalahan: bias dan variance#
Bias adalah kesalahan sistematik yang muncul karena model terlalu sederhana untuk menangkap pola pada data. Model polinomial derajat satu yang dipaksa mengikuti gelombang sinus, misalnya, akan meleset dengan pola yang sama di mana pun sampelnya diambil, sehingga penggantian data latih tidak memperbaiki keadaannya. Gejala inilah underfitting, yaitu skor pada data latih maupun data uji sama-sama buruk karena kapasitas model kurang dari kompleksitas pola yang sebenarnya.
Variance adalah kepekaan berlebih model terhadap sampel data latih yang kebetulan diterimanya. Model yang terlalu bebas tidak lagi mempelajari pola umum, melainkan menghafal derau per sampel, sehingga data latih yang sedikit berbeda akan menghasilkan model yang bentuknya berbeda pula. Gejalanya overfitting, yaitu skor data latih yang sangat bagus tidak diikuti data uji. Ketegangan keduanya dirangkum oleh dekomposisi kesalahan pada regresi:
Suku pertama menurun ketika model diberi kapasitas lebih, suku kedua justru naik, dan suku ketiga adalah derau data yang tidak dapat dijelaskan model apa pun. Tugas pemodelan adalah mencari kompleksitas yang meminimalkan jumlah ketiganya, bukan menekan satu suku dengan mengorbankan suku lainnya.
Membaca gejala dari skor latih dan uji#
Diagnosa paling praktis membandingkan skor pada data latih dan data uji. Kedua skor buruk dengan jarak yang sempit menandakan underfitting, karena model gagal pada data yang bahkan sudah pernah dilihatnya. Skor latih yang bagus dengan skor uji yang jauh lebih buruk menandakan overfitting, karena jarak itulah harga yang dibayar atas hafalan derau. Kasus yang paling menguntungkan adalah kedua skor sama-sama baik dengan jarak yang sempit.
Ketegangan bias-variance dikendalikan dari tiga sisi. Kompleksitas model menentukan kapasitas menangkap pola, dan menaikkannya menurunkan bias tetapi menaikkan variance. Ukuran data bekerja pada arah berlawanan, karena makin banyak sampel semakin sulit model menghafal semuanya, sehingga variance turun meskipun bias tidak ikut turun. Derau menaikkan suku error tak terkurangi dan memaksa variance dikendalikan lebih ketat. Ketiga tuas ini disetel bersama, dan pilihan regularisasi maupun hyperparameter lain hanyalah cara menggerakkannya.
Mengukur kurva kompleksitas pada data gelombang#
Praktik berikut membangkitkan enam puluh titik dari gelombang sinus dengan derau kecil, memisahkan dua puluh persennya sebagai data uji, lalu melatih regresi linear di atas fitur PolynomialFeatures untuk derajat 1 sampai 12. MSE data latih dan data uji dikumpulkan per derajat, dicetak sebagai tabel, dan digambar sebagai kurva.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures

pd.set_option("display.width", 80)

rng = np.random.default_rng(42)
n = 60
x = rng.uniform(0.0, 1.0, n)
y = np.sin(2.0 * np.pi * x) + rng.normal(0.0, 0.25, n)

X_latih, X_uji, y_latih, y_uji = train_test_split(
    x.reshape(-1, 1), y, test_size=0.2, random_state=42
)

baris = []
for derajat in range(1, 13):
    model = make_pipeline(
        PolynomialFeatures(degree=derajat), LinearRegression()
    )
    model.fit(X_latih, y_latih)
    baris.append(
        {
            "derajat": derajat,
            "mse_latih": mean_squared_error(y_latih, model.predict(X_latih)),
            "mse_uji": mean_squared_error(y_uji, model.predict(X_uji)),
        }
    )
tabel = pd.DataFrame(baris).set_index("derajat")
print(tabel.to_string(float_format=lambda v: f"{v:.3f}"))

fig, ax = plt.subplots(figsize=(5, 4))
ax.plot(tabel.index, tabel["mse_latih"], marker="o", label="MSE data latih")
ax.plot(tabel.index, tabel["mse_uji"], marker="s", label="MSE data uji")
ax.set_yscale("log")
ax.set_xlabel("Derajat polinomial")
ax.set_ylabel("MSE")
ax.legend()
fig.tight_layout()
fig.savefig("kurva-bias-variance.png", dpi=110) mse_latih mse_uji
derajat
1 0.226 0.327
2 0.224 0.352
3 0.031 0.054
4 0.031 0.054
5 0.030 0.049
6 0.030 0.048
7 0.023 0.050
8 0.020 0.054
9 0.020 0.056
10 0.020 0.053
11 0.019 0.053
12 0.019 0.064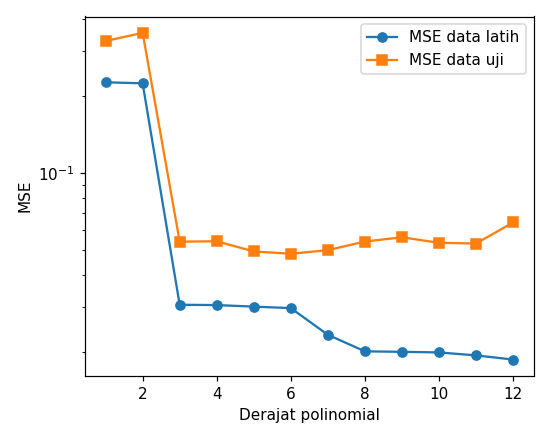
Tabel dan kurvanya memperlihatkan tiga tahap. Pada derajat 1 dan 2, kedua MSE tinggi, yaitu 0.226 dan 0.327 pada derajat 1, karena garis lurus memang tidak mampu mengikuti lengkung sinus. Kondisi inilah underfitting, dengan bias sebagai sumber kesalahan utamanya.
Antara derajat 3 dan 6, kedua skor turun ke lembahnya, dan MSE data uji terendah tercapai pada derajat 6 sebesar 0.048. Mulai derajat 7, pola berbalik. MSE data latih terus menyusut hingga 0.019 pada derajat 12, sedangkan MSE data uji naik kembali hingga 0.064. Kenaikan itu terjadi karena model makin sibuk mengejar derau pada data latih.
Pola umumnya persis seperti teorinya, yaitu MSE data latih turun terus seiring derajat, sedangkan MSE data uji turun terlebih dahulu lalu naik kembali. Titik balik pada kurva data uji adalah kompleksitas yang pas, dan di situlah jumlah bias dan variance paling kecil. Sumbu tegak grafik menggunakan skala logaritmik karena jarak antara wilayah underfitting dan titik lembahnya mencapai satu tingkat besaran. Tanpa skala log, lembah itu tidak akan terbaca.
Kesalahan umum#
- Menilai kualitas model hanya dari skor data latih. Skor itu selalu paling tinggi dan tidak menyatakan apa pun tentang generalisasi, sehingga data uji tetap diperlukan. Penyebabnya, skor data latih memang angka pertama yang tercetak setelah pelatihan. Perbaikannya, jadikan pasangan skor data latih dan skor data uji sebagai bacaan standar setiap pelatihan.
- Mengurangi kompleksitas begitu skor data uji buruk. Kesimpulan overfitting baru sah apabila skor data latihnya bagus, karena apabila skor data latih juga buruk, masalahnya justru underfitting dan kompleksitas perlu dinaikkan. Perbaikannya, periksa skor data latih terlebih dahulu sebelum memutuskan arah penyetelan.
- Menganggap tambahan data selalu memperbaiki model. Ukuran data menurunkan variance, tetapi bias dari model yang terlalu sederhana tidak hilang dengan menambah sampel. Perbaikannya, cocokkan tuas dengan kekurangannya, yaitu kompleksitas model untuk bias yang tinggi dan jumlah data untuk variance yang tinggi.
Ringkasan#
- Bias adalah kesalahan sistematik model yang terlalu sederhana, dan gejalanya underfitting dengan skor data latih maupun data uji yang sama-sama buruk.
- Variance adalah kepekaan berlebih terhadap sampel data latih, dan gejalanya overfitting dengan skor latih yang bagus tidak diikuti data uji.
- Diagnosanya dibaca dari jarak skor data latih dan data uji, sedangkan ketegangannya dikendalikan melalui kompleksitas model, ukuran data, dan derau.
- Kurva kesalahan terhadap kompleksitas memperlihatkan pola baku, yaitu MSE latih yang turun terus dan MSE uji yang turun lalu naik, dengan titik balik sebagai kompleksitas yang pas.
Referensi#
- Learning curves — scikit-learn — Panduan resmi diagnosa underfitting dan overfitting melalui kurva skor.
- sklearn.preprocessing.PolynomialFeatures — scikit-learn — Dokumentasi pembangkit fitur polinomial yang digunakan untuk mengatur kompleksitas.
- sklearn.linear_model.LinearRegression — scikit-learn — Dokumentasi model yang dilatih pada setiap derajat polinomial.
- sklearn.metrics.mean_squared_error — scikit-learn — Dokumentasi metrik yang digunakan pada tabel dan kurva.
- Pipelines and composite estimators — scikit-learn — Panduan resmi Pipeline yang menggabungkan fitur polinomial dan model.