Model yang sudah disajikan bekerja pada data yang terus bergerak, sedangkan parameternya diam di tempat. Topik ini membahas pemantauan drift, yaitu pergeseran distribusi data dari masa pelatihan yang membuat kinerja model menurun tanpa satu pun pesan. Pembahasannya mencakup jenis drift, pengukuran pergeseran dengan population stability index (PSI) dan uji Kolmogorov-Smirnov (KS), skrip pemantauan pada dataset diabetes, serta siklus tindak lanjut ketika ambang terlampaui.
Model yang membusuk diam-diam#
Angka evaluasi model adalah pernyataan tentang masa lalu, yaitu kinerja pada data uji yang dikumpulkan sebelum penyajian. Seiring waktu, dunia yang menghasilkan data itu berubah, misalnya populasi yang dilayani bergeser, alat ukur dikalibrasi ulang, atau perilaku yang dicatat berubah. Model tidak mengetahui perubahan tersebut karena parameternya membeku sejak pelatihan terakhir.
Drift dibedakan menjadi dua jenis. Data drift terjadi ketika distribusi masukan bergeser, misalnya nilai fitur tertentu naik perlahan, tanpa mengubah hubungan fitur dengan target. Concept drift terjadi ketika hubungan fitur dengan target itu sendiri berubah, sehingga pola yang dulu benar menjadi usang. Data drift dapat dideteksi dari masukan saja, sedangkan concept drift menuntut label baru yang sering datang terlambat.
Bahaya utamanya adalah tidak adanya sinyal kegagalan. Prediksi tetap keluar setiap hari, tidak ada pesan error, dan angka penurunan kinerja hanya terlihat apabila model sengaja dipantau. Karena itu pemantauan bukan pelengkap opsional, melainkan satu-satunya cara mengetahui bahwa model yang dijalankan sudah tidak sesuai dengan dunianya.
Mengukur pergeseran distribusi#
PSI membandingkan porsi data antara data referensi dan data periode berjalan pada setiap bin, yaitu rentang nilai yang diperoleh dari pembagian rentang fitur menjadi beberapa kelompok. Dengan sebagai porsi referensi dan sebagai porsi periode berjalan pada bin ke- dari bin, nilainya dihitung sebagai berikut.
Kedua distribusi yang serupa menghasilkan PSI mendekati nol, sedangkan pergeseran yang besar menggembungkan nilainya. Kebiasaan yang lazim digunakan membagi hasilnya menjadi tiga wilayah berikut.
| Rentang PSI | Pembacaan yang lazim |
|---|---|
| Di bawah 0.1 | Distribusi relatif stabil |
| 0.1 sampai 0.25 | Pergeseran moderat, mulai diselidiki |
| Di atas 0.25 | Pergeseran besar, tindak lanjut segera |
Bin biasanya dibuat dari kuantil data referensi, sehingga setiap bin memuat porsi referensi yang sama dan perbandingannya tidak dipengaruhi oleh bin yang hampir kosong. Jumlah bin yang lazim berkisar antara lima hingga sepuluh. Bin terlalu banyak membuat porsi per bin kecil dan nilainya mudah bergoyang akibat derau, sedangkan bin terlalu sedikit menyamarkan pergeseran yang bentuknya halus.
Pengukur kedua adalah uji KS, yaitu uji statistik yang membandingkan dua distribusi melalui jarak maksimum antara dua fungsi sebaran kumulatifnya. Hasilnya berupa statistik jarak dan nilai p, yaitu peluang memperoleh jarak sekurang-kurangnya sebesar itu apabila kedua distribusi sebenarnya sama. Nilai p yang kecil menandakan pergeseran yang terdeteksi, sehingga keduanya melengkapi PSI yang menyatakan besar pergeserannya.
Skrip pemantauan#
Skrip berikut meniru dua periode data pada fitur bmi dari dataset diabetes, yaitu satu sampel periode tanpa pergeseran dan satu sampel periode dengan rata-rata yang digeser 0.06. Skrip menghitung PSI dan uji KS untuk kedua periode, lalu mengukur MAE model regresi linear pada dua data uji, yaitu data uji biasa dan data uji yang fiturnya digeser. Perbandingan histogram menutup skrip sebagai gambaran visual pergeserannya.
"""Memantau drift: mengukur pergeseran distribusi dan dampaknya pada model."""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import ks_2samp
from sklearn.datasets import load_diabetes
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

data = load_diabetes()
X, y = data.data, data.target
kolom_bmi = 2

# data referensi dari masa pelatihan dan sampel periode berjalan
referensi = X[:, kolom_bmi]
rng = np.random.default_rng(42)
indeks = rng.choice(referensi.shape[0], size=200, replace=False)

periode_stabil = referensi[indeks]
periode_geser = referensi[indeks] + 0.06  # pergeseran rata-rata yang disimulasikan


def hitung_psi(referensi, periode, jumlah_bin=5):
    """PSI antara data referensi dan data periode berjalan."""
    batas = np.quantile(referensi, np.linspace(0, 1, jumlah_bin + 1))
    batas[0], batas[-1] = -np.inf, np.inf
    p = np.histogram(referensi, bins=batas)[0] / referensi.shape[0]
    q = np.histogram(periode, bins=batas)[0] / periode.shape[0]
    p = np.clip(p, 1e-6, None)
    q = np.clip(q, 1e-6, None)
    return float(np.sum((p - q) * np.log(p / q)))


for nama, periode in [("stabil", periode_stabil), ("geser", periode_geser)]:
    psi = hitung_psi(referensi, periode)
    hasil_ks = ks_2samp(referensi, periode)
    print(f"Periode {nama}: PSI={psi:.3f}, KS={hasil_ks.statistic:.3f}, p={hasil_ks.pvalue:.4f}")

# dampak drift terhadap model: error naik ketika distribusi masukan bergeser
X_latih, X_uji, y_latih, y_uji = train_test_split(
    X, y, test_size=0.25, random_state=42
)
model = LinearRegression().fit(X_latih, y_latih)

prediksi_uji = model.predict(X_uji)
mae_uji = np.mean(np.abs(y_uji - prediksi_uji))

X_geser = X_uji.copy()
X_geser[:, kolom_bmi] += 0.06
mae_geser = np.mean(np.abs(y_uji - model.predict(X_geser)))

print(f"MAE data uji            : {mae_uji:.2f}")
print(f"MAE dengan bmi bergeser : {mae_geser:.2f}")

# gambar perbandingan distribusi referensi dan periode bergeser
fig, ax = plt.subplots(figsize=(6, 3))
ax.hist(referensi, bins=30, alpha=0.6, label="Referensi")
ax.hist(periode_geser, bins=30, alpha=0.6, label="Periode bergeser")
ax.set_xlabel("Nilai fitur bmi (terskala)")
ax.set_ylabel("Frekuensi")
ax.legend()
fig.tight_layout()
fig.savefig("distribusi-geser.png", dpi=110)
print("Grafik tersimpan : distribusi-geser.png")Periode stabil: PSI=0.016, KS=0.036, p=0.9908
Periode geser: PSI=3.419, KS=0.497, p=0.0000
MAE data uji : 41.55
MAE dengan bmi bergeser : 49.47
Grafik tersimpan : distribusi-geser.pngPeriode stabil menghasilkan PSI 0.016 dan nilai p 0.9908, sehingga kedua ukuran menyatakan distribusinya masih sama dengan referensi. Periode bergeser menghasilkan PSI 3.419 yang jauh melampaui ambang 0.25 dan nilai p 0.0000, yaitu pergeseran yang nyaris mustahil terjadi karena kebetulan. Dampaknya terlihat pada model. MAE naik dari 41.55 menjadi 49.47, atau bertambah sekitar 19 persen, hanya karena satu fitur bergeser 0.06 pada skala fitur dataset diabetes yang memang terskala sempit.
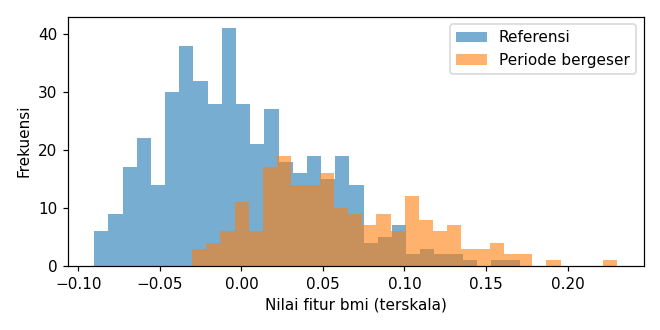
Histogram tersebut memperlihatkan sifat drift yang menipu. Gundukan periode bergeser hanya berpindah sedikit dibandingkan lebar sebarannya, tetapi perpindahan kecil itu cukup untuk menaikkan error model secara nyata. Pemantauan per fitur juga penting karena pergeseran dapat terjadi pada satu fitur saja, sedangkan rata-rata seluruh fitur masih tampak normal.
Siklus pemantauan#
Pemantauan berjalan sebagai siklus yang berulang pada setiap periode data. Diagram berikut merangkum empat langkahnya beserta dua jalur kembalinya.
Setiap periode baru dihitung metriknya, lalu dibandingkan dengan ambang yang ditetapkan. Apabila nilainya masih dalam ambang, hasilnya dicatat dan siklus menunggu periode berikutnya. Apabila ambang terlampaui, tindak lanjutnya bukan langsung melatih ulang, melainkan menyelidiki penyebabnya lebih dahulu. Pergeseran bisa berasal dari kesalahan alat pencatat data, dan bukan dari perubahan dunia yang sesungguhnya. Setelah penyebabnya diketahui dan pelatihan ulang disiapkan, model versi baru masuk ke pemantauan yang sama, dan siklusnya berputar lagi.
Panjang satu periode mengikuti laju perubahan datanya, misalnya harian untuk data yang bergerak cepat dan mingguan untuk data yang bergerak lambat. Periode yang terlalu pendek membuat metriknya bergoyang akibat derau, sedangkan periode yang terlalu panjang membiarkan drift tumbuh tanpa terdeteksi. Panjang yang dipilih perlu dipertahankan dari periode ke periode, karena perbandingan antar periode bermakna hanya bila panjangnya sama. Perubahan panjang periode dinyatakan secara eksplisit, karena hasil pembandingan lama tidak lagi langsung sebanding dengan yang baru.
Kesalahan umum#
- Memantau hanya rata-rata setiap fitur. Dua distribusi dapat berbagi rata-rata yang serupa sementara bentuknya berbeda jauh. Gunakan metrik distribusi seperti PSI pada setiap fitur penting.
- Menunggu label untuk mulai memantau. Label baru sering datang berhari-hari kemudian atau tidak pernah lengkap, sedangkan data drift sudah terdeteksi dari masukan saja. Jalankan pemantauan distribusi sejak hari pertama penyajian.
- Menggabungkan data periode baru ke dalam referensi setiap saat. Referensi yang terus bertambah menyerap pergeseran sehingga drift berikutnya tidak terlihat. Bekukan referensi dari masa pelatihan dan ganti hanya bersama model barunya.
- Membandingkan referensi dengan sampel periode yang ukurannya terlalu kecil. Porsi per bin pada sampel kecil tidak stabil, sehingga PSI melonjak tanpa pergeseran yang nyata. Ambil sampel periode yang cukup besar atau kurangi jumlah binnya.
- Menetapkan ambang tanpa kalibrasi pada periode yang sehat. Ambang yang dipilih asal membuat alarm berbunyi pada hampir setiap periode, dan kepercayaan terhadap pemantauan hilang. Uji ambangnya pada periode-periode tanpa pergeseran terlebih dahulu, lalu sesuaikan sebelum penyajian berjalan.
Ringkasan#
- Drift menurunkan kinerja model tanpa pesan error apa pun, sehingga pemantauan menjadi satu-satunya cara mengetahuinya.
- PSI menyatakan besar pergeseran distribusi melalui porsi per bin, sedangkan uji KS menyatakan keterdeteksinya melalui nilai p.
- Pada simulasi, pergeseran kecil pada fitur bmi menaikkan PSI dari 0.016 menjadi 3.419 dan MAE model dari 41.55 menjadi 49.47.
- Siklusnya berulang, yaitu mengukur, membandingkan ambang, menyelidiki bila melampaui, memperbarui model, lalu memantau lagi.
Referensi#
- scipy.stats.ks_2samp — SciPy — Dokumentasi uji Kolmogorov-Smirnov dua sampel yang dipakai skrip pemantauan.
- sklearn.datasets.load_diabetes — scikit-learn — Deskripsi dataset diabetes beserta fiturnya yang terskala sempit.
- Model evaluation: quantifying the quality of predictions — scikit-learn — Daftar metrik regresi termasuk MAE untuk menilai kinerja model pada pemantauan.