Pada chapter Backpropagation Through Time, kita sudah melihat gejala pembuka: norma gradien menyusut dari 0,424 menjadi 0,035 hanya dalam empat langkah mundur. Pada sekuens yang benar-benar panjang, penyusutan itu berkembang menjadi masalah sentral RNN yang paling terkenal: vanishing gradient. Akar masalahnya bersifat aljabar murni — gradien yang menyeberangi t langkah waktu harus melewati t kali perkalian dengan matriks Wh, dan perkalian berulang bersifat eksponensial, bukan linear. Chapter ini membuktikannya dengan angka: kita mengukur norma gradien untuk T = 5, 10, 20, dan 40 pada kondisi yang paling optimis sekalipun.
Perkalian Berulang Menyusut Eksponensial #
Saat BPTT melangkah mundur dari h_t ke h_{t-1}, gradien dikalikan Wh^T (ditambah faktor turunan tanh yang nilainya antara 0 dan 1). Setelah T langkah mundur, gradien awal telah dikalikan Wh sebanyak T kali. Perilaku perkalian matriks berulang ditentukan jari-jari spektral ρ — nilai singular terbesarnya: norm vektor berubah mendekati faktor ρ pada setiap perkalian. Konsekuensinya:
||dL/dh_0|| ~ ρ^T × ||dL/dh_T||Jika ρ < 1, gradien menyusut eksponensial — ρ sebesar 0,9 saja sudah menghasilkan faktor 0,015 setelah 40 langkah. Jika ρ > 1, gradien justru membesar tak terkendali (exploding gradient). Kondisi ρ tepat 1 hampir tidak pernah tercapai pada inisialisasi acak. Untuk mengukur fenomena ini terlepas dari keberuntungan inisialisasi, kita memakai matriks ortogonal dari dekomposisi QR yang diskalakan ρ — semua nilai singularnya tepat ρ, sehingga hasilnya bersih dari derau.
Mengukur Penyusutan dengan Angka #
Program berikut menghitung ||dL/dh_0|| mundur T langkah untuk empat nilai T dengan ρ = 0,9, dalam dua varian: perkalian linier murni (batas atas paling optimis — tanpa penyusutan tambahan dari tanh) dan versi dengan faktor tanh seperti RNN sesungguhnya:
"""Vanishing gradient pada RNN: perkalian Wh berulang menyusutkan gradien.

Gradien dihitung mundur T langkah untuk T = 5, 10, 20, 40 dengan matriks
Wh ortogonal berskala 0.9 (jari-jari spektral 0.9). Dua varian dibandingkan:
perkalian linier murni (batas atas paling optimis) dan versi dengan tanh
seperti RNN sesungguhnya. Plot bersumbu log disimpan sebagai vanishing_rnn.png.
"""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt
import numpy as np

np.random.seed(0)

H = 8

# Matriks ortogonal dari QR, diskalakan 0.9 -> jari-jari spektral 0.9
Q, _ = np.linalg.qr(np.random.randn(H, H))
W = 0.9 * Q

g_T = np.ones(H)  # dL/dh_T awal, norm = sqrt(8)


def jejak_linier(T, rho):
    """Norma gradien tiap langkah mundur: g <- g @ (rho*Q), tanpa aktivasi."""
    Wr = rho * Q
    g = g_T.copy()
    jejak = [np.linalg.norm(g)]
    for _ in range(T):
        g = g @ Wr
        jejak.append(np.linalg.norm(g))
    return jejak


def jejak_tanh(T):
    """RNN linier-tanpa-input: maju simpan h_t, mundur pakai faktor tanh."""
    h = np.ones(H) * 0.5
    daftar_h = [h.copy()]
    for _ in range(T):
        h = np.tanh(W @ h)
        daftar_h.append(h.copy())
    g = g_T.copy()
    jejak = []
    for t in range(T, 0, -1):
        g = (g * (1.0 - daftar_h[t] ** 2)) @ W
        jejak.append(np.linalg.norm(g))
    return [np.linalg.norm(g_T)] + jejak  # indeks = jumlah langkah mundur


print("||dL/dh_T awal|| =", round(float(np.linalg.norm(g_T)), 6))
print()
print("Tanpa aktivasi (perkalian Wh murni, batas atas optimis):")
print(f"{'T':>4} {'||dL/dh_0||':>14} {'rasio vs 0.9^T':>16}")
for T in (5, 10, 20, 40):
    jejak = jejak_linier(T, 0.9)
    norm = jejak[-1]
    print(f"{T:>4} {norm:>14.6f} {norm / (np.linalg.norm(g_T) * 0.9**T):>16.6f}")

print()
print("Dengan tanh (RNN sesungguhnya, h_0 = 0.5*ones):")
for T in (5, 10, 20, 40):
    norm = jejak_tanh(T)[-1]
    print(f"{T:>4} {norm:>14.6e}")

print()
print("Efek jari-jari spektral pada T = 40 (linier):")
for rho in (0.5, 0.9, 1.0, 1.1):
    norm = jejak_linier(40, rho)[-1]
    arah = "menyusut" if rho < 1 else ("tetap" if rho == 1 else "membesar")
    print(f"  rho = {rho:3.1f} -> ||dL/dh_0|| = {norm:.6e}  ({arah})")

# ---------- Plot kurva (sumbu log) ----------
fig, ax = plt.subplots(figsize=(6.5, 4.2))
T_maks = 40
warna = {0.5: "tab:blue", 0.9: "tab:orange", 1.0: "tab:green", 1.1: "tab:red"}
for rho in (0.5, 0.9, 1.0, 1.1):
    ax.semilogy(range(T_maks + 1), jejak_linier(T_maks, rho),
                color=warna[rho], label=f"linier, jari-jari {rho}")
ax.semilogy(range(T_maks + 1), jejak_tanh(T_maks), color="tab:purple",
            label="dengan tanh, jari-jari 0.9")
ax.axhline(1.0, color="gray", lw=0.8, ls=":")
ax.set_xlabel("jumlah langkah mundur T")
ax.set_ylabel("norma gradien ||dL/dh_0||")
ax.set_title("Penyusutan gradien RNN melintasi waktu (sumbu log)")
ax.legend(fontsize=8, loc="center left")
ax.grid(True, which="both", alpha=0.3)
fig.tight_layout()
fig.savefig("vanishing_rnn.png", dpi=110, bbox_inches="tight")
print()
print("Plot tersimpan: vanishing_rnn.png")
Output yang Dihasilkan:
||dL/dh_T awal|| = 2.828427

Tanpa aktivasi (perkalian Wh murni, batas atas optimis):
   T    ||dL/dh_0||   rasio vs 0.9^T
   5       1.670158         1.000000
  10       0.986212         1.000000
  20       0.343871         1.000000
  40       0.041807         1.000000

Dengan tanh (RNN sesungguhnya, h_0 = 0.5*ones):
   5   1.029118e+00
  10   5.097291e-01
  20   1.106564e-01
  40   1.569306e-02

Efek jari-jari spektral pada T = 40 (linier):
  rho = 0.5 -> ||dL/dh_0|| = 2.572439e-12  (menyusut)
  rho = 0.9 -> ||dL/dh_0|| = 4.180665e-02  (menyusut)
  rho = 1.0 -> ||dL/dh_0|| = 2.828427e+00  (tetap)
  rho = 1.1 -> ||dL/dh_0|| = 1.280125e+02  (membesar)

Plot tersimpan: vanishing_rnn.png
Mari kita telaah kode di atas baris per baris:
- Baris 20-22: matriks
Qortogonal darinp.linalg.qr, laluW = 0.9 * Q— setiap nilai singular tepat 0,9. Inisialisasi RNN acak biasanya lebih buruk dari ini, jadi hasil varian linier adalah batas atas yang murah hati. - Baris 24: gradien awal
g_Tberisi satu dengan norm 2,828 — nilai yang sama untuk semua percobaan agar perbandingan adil. - Baris 27-35:
jejak_liniermengalikang @ Wrberulang T kali tanpa aktivasi dan mencatat normanya setiap langkah. Pada varian ini norma pasti berubah tepat faktor ρ per langkah. - Baris 38-50:
jejak_tanhmenjalankan forward rekurenh = tanh(W @ h)darih_0untuk menyimpan seluruhh_t, lalu mundur dengan faktor(1 - h_t^2)— inilah Jacobian RNN vanilla sesungguhnya. - Baris 57-60: tabel pertama. Kolom rasio membagi hasil dengan
norm × 0,9^Tdan hasilnya 1,000000 pada keempat T — bukti numerik bahwa norma gradien linier memang tepatρ^T. - Baris 64-66: varian tanh menyusut lebih cepat: 1,03 pada T = 5 menjadi 1,57e-02 pada T = 40, karena faktor turunan tanh menambah penyusutan di atas faktor 0,9.
- Baris 70-73: percobaan pamungkas memvariasikan ρ pada T = 40. ρ = 0,5 menghasilkan 2,57e-12 — gradien praktis nol; ρ = 1,0 mempertahankan norma; ρ = 1,1 membesarkannya menjadi 128.
- Baris 76-91: keempat kurva (plus kurva tanh) digambar pada sumbu log sehingga eksponensial tampak sebagai garis lurus; berkas
vanishing_rnn.pngdisimpan di bundle.
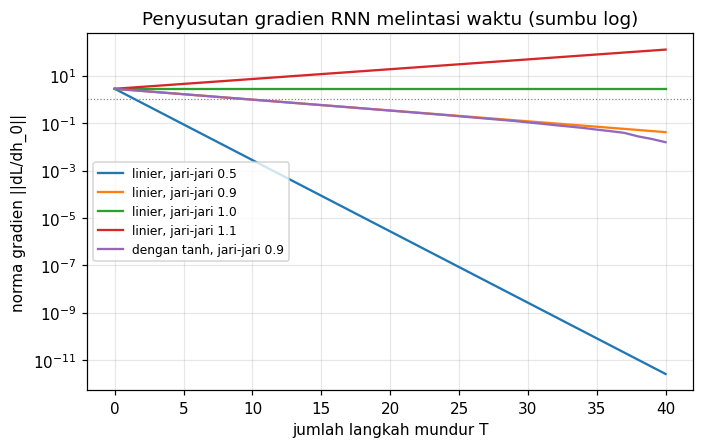
Grafik tersebut menegaskan pola linear pada sumbu log: setiap kurva adalah eksponensial dengan kemiringan yang ditentukan ρ. Kurva ungu (tanh, ρ = 0,9) jatuh lebih curam di awal karena h_0 bernilai 0,5 membuat turunan tanh jauh di bawah 1, lalu sejajar dengan kurva linier begitu h_t mengecil.
Akibat bagi Dependensi Jangka Panjang #
Gradien adalah sinyal pembelajaran: bobot hanya berubah jika gradien sampai. Ketika ||dL/dh_0|| jatuh ke 2,57e-12, peristiwa pada langkah ke-40 praktis tidak bisa mengoreksi bobot yang bekerja pada langkah ke-0 — langkah pembelajaran lr × gradien menjadi nol efektif. Model lalu belajar hanya dari dependensi pendek dan mengabaikan konteks jauh: subjek kalimat panjang tak lagi memengaruhi prediksi kata kerja di akhir, pola musiman panjang pada deret waktu tak terpelajari. Tiga jalan keluar yang dibahas pada chapter-chapter sesudahnya: arsitektur gate (LSTM dan GRU) yang menyediakan jalur gradien hampir konstan, inisialisasi ortogonal yang menjaga ρ dekat 1, dan normalisasi.
Solusi paling berpengaruh datang dari tahun 1997: sel rekuren dengan jalur gradien yang nyaris konstan, dikendalikan tiga gate. Chapter berikutnya membongkar Long Short-Term Memory sampai rumus terakhirnya.