Bab terakhir section ini kembali ke pertanyaan paling praktis: bagaimana tahu agen kita benar-benar baik? Evaluasi supervised learning punya resep mapan — data uji terpisah, metrik tetap — tetapi resep itu tidak langsung terpakai di RL karena dua hal: kurva training terkontaminasi eksplorasi (chapter sebelumnya memperlihatkan return training −0.9 milik agen yang kebijakan akhirnya sempurna), dan hasil pelatihan bergantung pada urutan acak yang berbeda-beda antar keberjalan. Pada chapter ini kita susun protokol evaluasi tiga lapis — metrik yang tepat, evaluasi terpisah tanpa eksplorasi, dan pengulangan antar seed — lalu merapikan kurva belajar dengan rata-rata bergerak agar kemajuan terbaca.
Metrik Performa #
| Metrik | Yang ditanyakan | Cara hitung pada demo |
|---|---|---|
| mean return | rata-rata hasil kebijakan | mean total reward 20 episode evaluasi |
| success rate | seberapa sering tujuan tercapai | jumlah episode dengan return positif |
| sample efficiency | berapa cepat pengetahuan terkumpul | episode pertama saat rata-rata bergerak melewati ambang |
| stabilitas | seberapa konsisten hasilnya | sebaran mean return antar seed |
Metrik pertama dan kedua saling melengkapi: mean return bisa tinggi meski sebagian episode gagal, dan success rate bisa 100% dengan jalur yang berbelang-belit. Metrik ketiga penting justru karena RL mahal — dua agen dengan performa akhir sama bisa berbeda sepuluh kali lipat dalam kebutuhan interaksi.
Evaluasi Terpisah dan Variansi Seed #
Dua prinsip jujur: putuskan eksplorasi saat mengukur, dan jangan percaya satu keberjalan. Berkas evaluasi_agen.py melatih Q-learning pada GridWorld 4x4 yang kini berbatas ketat 16 langkah per episode, lalu melakukan tiga pemeriksaan — perbandingan return training lawan evaluasi greedy, lima seed dengan anggaran sama, dan perataan kurva belajar:
"""Evaluasi agen RL: eval greedy terpisah, beberapa seed, dan smoothing.

Dunia GridWorld 4x4 yang sama dengan chapter sebelumnya: mulai (0,0),
target (3,3), reward -0.05 per langkah, +1 saat tiba. Batas episode
dikecilkan menjadi 16 langkah supaya anggaran interaksi ketat dan
perbedaan antar seed terlihat. Tiga bagian: (A) membandingkan return
saat training (dengan eksplorasi) melawan evaluasi greedy terpisah,
(B) melatih 5 seed dengan anggaran sama lalu menilai hasilnya,
(C) merapikan kurva belajar dengan rata-rata bergerak.
"""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt  # noqa: E402
import numpy as np  # noqa: E402

UKURAN = 4
START, GOAL = (0, 0), (3, 3)
AKSI = [(-1, 0), (1, 0), (0, -1), (0, 1)]
MAKS_LANGKAH = 16


def step(state, aksi):
    """Satu interaksi; kembalikan (state_baru, reward, selesai)."""
    db, dk = AKSI[aksi]
    nb, nk = state[0] + db, state[1] + dk
    state_baru = (nb, nk) if (0 <= nb < UKURAN and 0 <= nk < UKURAN) else state
    selesai = state_baru == GOAL
    return state_baru, (1.0 if selesai else -0.05), selesai


def latih(seed, jumlah_episode, epsilon=0.2, alfa=0.1, gamma=0.9):
    """Q-learning epsilon-greedy; kembalikan (Q, riwayat return)."""
    rng = np.random.default_rng(seed)
    Q = np.zeros((UKURAN, UKURAN, 4))
    riwayat = []
    for _ in range(jumlah_episode):
        state, total = START, 0.0
        for _ in range(MAKS_LANGKAH):
            if rng.random() < epsilon:
                aksi = int(rng.integers(0, 4))
            else:
                aksi = int(np.argmax(Q[state[0], state[1]]))
            state_baru, reward, selesai = step(state, aksi)
            target = reward + gamma * (0.0 if selesai
                                       else Q[state_baru[0], state_baru[1]].max())
            Q[state[0], state[1], aksi] += alfa * (
                target - Q[state[0], state[1], aksi])
            total += reward
            state = state_baru
            if selesai:
                break
        riwayat.append(total)
    return Q, riwayat


def evaluasi_greedy(Q, jumlah_episode=20):
    """Evaluasi terpisah tanpa eksplorasi; kembalikan (mean, sukses)."""
    hasil = []
    for _ in range(jumlah_episode):
        state, total = START, 0.0
        for _ in range(MAKS_LANGKAH):
            aksi = int(np.argmax(Q[state[0], state[1]]))
            state, reward, selesai = step(state, aksi)
            total += reward
            if selesai:
                break
        hasil.append(total)
    return float(np.mean(hasil)), sum(h > 0 for h in hasil)


# ---- Bagian A: eval greedy terpisah vs return saat training ----
Q_A, riwayat_A = latih(seed=7, jumlah_episode=500)
greedy_mean, greedy_sukses = evaluasi_greedy(Q_A)
latih_akhir = float(np.mean(riwayat_A[-50:]))
latih_sukses = sum(r > 0 for r in riwayat_A[-50:])
print("Bagian A: satu agen (seed 7), 500 episode, epsilon=0.2")
print(f"  Mean return training, episode 451-500 : {latih_akhir:+.3f}")
print(f"  Mean return evaluasi greedy (20 episode): {greedy_mean:+.3f}")
print(f"  Sukses training vs evaluasi           : {latih_sukses}/50 vs "
      f"{greedy_sukses}/20")
print(f"  Selisih (greedy - training)           : {greedy_mean - latih_akhir:+.3f}"
      " <- eksplorasi menekan return training")

# ---- Bagian B: lima seed dengan anggaran ketat ----
print("\nBagian B: 5 seed, anggaran ketat 40 episode, lalu evaluasi greedy")
berhasil = 0
for seed in (7, 13, 21, 34, 42):
    Q_B, _ = latih(seed=seed, jumlah_episode=40)
    mean_b, sukses_b = evaluasi_greedy(Q_B)
    berhasil += sukses_b == 20
    print(f"  seed {seed:2d}: mean greedy {mean_b:+.2f}, "
          f"sukses {sukses_b}/20")
print(f"  Kesimpulan: {berhasil}/5 seed menghasilkan kebijakan greedy "
      "yang sampai target")

# ---- Bagian C: smoothing kurva belajar ----
rijak = np.convolve(riwayat_A, np.ones(10) / 10, mode="valid")
print("\nBagian C: return mentah vs rata-rata bergerak (seed 7, jendela 10)")
for i in range(100, 110):
    print(f"  episode {i + 1:3d}: mentah {riwayat_A[i]:+.2f}"
          f"  |  rata-rata bergerak {rijak[i - 9]:+.2f}")
lewat = next((i + 10 for i, v in enumerate(rijak) if v > 0.5), None)
print(f"  Rata-rata bergerak pertama kali > +0.50 pada episode {lewat}")

plt.figure(figsize=(7, 4.5))
plt.plot(range(1, 501), riwayat_A, alpha=0.25, linewidth=0.8,
         label="return per episode (mentah)")
plt.plot(range(10, 501), rijak, linewidth=2,
         label="rata-rata bergerak (jendela 10)")
plt.axhline(0.75, linestyle="--", color="gray", label="optimal +0.75")
plt.xlabel("Episode")
plt.ylabel("Total reward per episode")
plt.title("Kurva belajar: mentah vs smoothing")
plt.legend()
plt.grid(True, alpha=0.3)
plt.savefig("kurva_belajar.png", dpi=110, bbox_inches="tight")
print("\nGrafik kurva belajar tersimpan: kurva_belajar.png")
Output yang Dihasilkan:
Bagian A: satu agen (seed 7), 500 episode, epsilon=0.2
  Mean return training, episode 451-500 : +0.662
  Mean return evaluasi greedy (20 episode): +0.750
  Sukses training vs evaluasi           : 50/50 vs 20/20
  Selisih (greedy - training)           : +0.088 <- eksplorasi menekan return training

Bagian B: 5 seed, anggaran ketat 40 episode, lalu evaluasi greedy
  seed  7: mean greedy -0.80, sukses 0/20
  seed 13: mean greedy +0.75, sukses 20/20
  seed 21: mean greedy +0.75, sukses 20/20
  seed 34: mean greedy -0.80, sukses 0/20
  seed 42: mean greedy -0.80, sukses 0/20
  Kesimpulan: 2/5 seed menghasilkan kebijakan greedy yang sampai target

Bagian C: return mentah vs rata-rata bergerak (seed 7, jendela 10)
  episode 101: mentah +0.65  |  rata-rata bergerak +0.67
  episode 102: mentah +0.75  |  rata-rata bergerak +0.68
  episode 103: mentah +0.50  |  rata-rata bergerak +0.66
  episode 104: mentah +0.70  |  rata-rata bergerak +0.67
  episode 105: mentah +0.75  |  rata-rata bergerak +0.67
  episode 106: mentah +0.65  |  rata-rata bergerak +0.66
  episode 107: mentah +0.65  |  rata-rata bergerak +0.67
  episode 108: mentah +0.55  |  rata-rata bergerak +0.66
  episode 109: mentah +0.75  |  rata-rata bergerak +0.66
  episode 110: mentah +0.60  |  rata-rata bergerak +0.66
  Rata-rata bergerak pertama kali > +0.50 pada episode 39

Grafik kurva belajar tersimpan: kurva_belajar.png
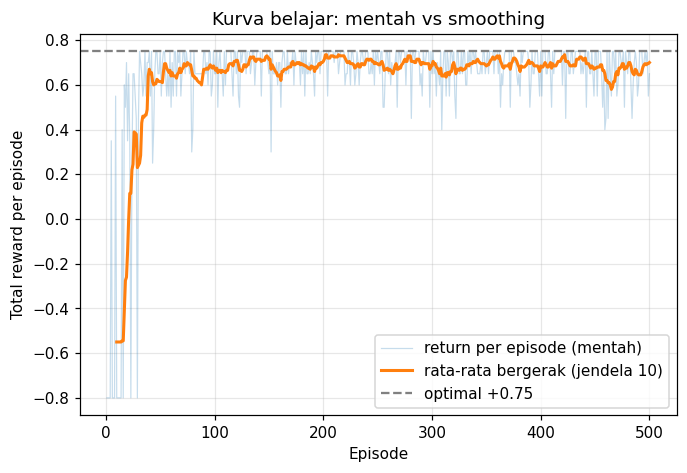
Bagian A mengukur selisih dua protokol pada agen yang sama (seed 7): mean return training episode 451-500 sebesar +0.662, sedangkan evaluasi greedy +0.750 — selisih +0.088 adalah biaya eksplorasi epsilon 0.2 yang mengenakan aksi acak pada kurva training; kebijakan sejatinya sudah optimal. Bagian B adalah peringatan yang lebih serius: dengan anggaran ketat 40 episode, hanya 2/5 seed (13 dan 21) yang menghasilkan kebijakan greedy sampai target — tiga seed lainnya berhenti di −0.80. Ketiga agen gagal itu tidak berbeda algoritma, hyperparameter, ataupun kode; yang berbeda hanya urutan angka acak. Melaporkan hasil satu seed sama saja menampilkan undian. Bagian C merapikan kurva: return mentah per episode berayun +0.50 hingga +0.75, sedangkan rata-rata bergerak jendela 10 (fungsi np.convolve
) bergerak stabil di sekitar +0.66, dan ambang +0.50 pertama kali terlampaui pada episode 39 — ukuran sample efficiency yang jelas. Mari kita telaah kode di atas baris per baris:
- Baris 12-17: backend
Aggdipilih sebelum pyplot agar grafik tersimpan tanpa jendela tampilan — pola yang sama dengan chapter Gradient Descent . - Baris 22:
MAKS_LANGKAH = 16— anggaran ketat per episode; jarak terpendek dunia ini enam langkah, sehingga ruang untuk kekeliruan kecil. - Baris 34-56 (
latih): Q-learning epsilon-greedy parameterized oleh seed; seluruh ketidakpastian mengalir lewatnp.random.default_rng(seed). - Baris 59-71 (
evaluasi_greedy): protokol evaluasi murni — tanpa epsilon, tanpa pembaruan Q, kebijakan greedy dijalankan 20 episode; inilah pemisahan “belajar” dari “menilai”. - Baris 74-85: Bagian A — satu agen, dua cara membaca: return 50 episode training terakhir lawan hasil evaluasi greedy.
- Baris 87-97: Bagian B — lima seed menempuh anggaran identik 40 episode lalu dievaluasi; ringkasan
2/5mengukur stabilitas, bukan keberuntungan tunggal. - Baris 100-106: Bagian C — rata-rata bergerak dihitung lewat konvolusi dengan jendela sepuluh angka
1/10, lalu episode pertama yang melampaui ambang+0.50dicari. - Baris 108-120: kurva mentah digambar transparan tipis, kurva rata-rata bergerak digambar tebal, dan garis optimal
+0.75menjadi acuan visual; matplotlib pyplot menyimpannya kekurva_belajar.png.
Penutup Section #
Kita menutup section ini dengan rantai yang utuh: desain reward membentuk perilaku, MDP memberi kerangka hitung, value function dan policy gradient menjadi dua jalur belajar, jaringan memperluas keduanya lewat DQN dan actor-critic, eksplorasi menjaga pengetahuan tetap bertumbuh, dan evaluasi menjaga kita tetap jujur. Seluruhnya dilatih pada dunia mini yang setiap angkanya bisa diverifikasi — pola yang sama ketika dunia membesar: koordinat robot menggantikan sel papan, citra menggantikan one-hot, dan reward menjadi sinyal tugas nyata. Deep learning berikutnya berpindah pokok bahasan: menggabungkan lebih dari satu jenis data — teks, citra, dan audio — dalam satu model, dimulai dari chapter Pengenalan Multimodal Learning di section berikutnya.