Model yang mencetak akurasi sempurna pada data latih belum tentu model yang berguna. Yang kita cari adalah generalisasi: kemampuan model memberi prediksi baik pada data yang tidak pernah dilihat saat pelatihan. Dua mode kegagalan generalisasi paling klasik adalah overfitting — model menghafal data latih sampai ke noisenya — dan underfitting — model terlalu sederhana untuk menangkap pola sama sekali. Chapter ini membuka section Regularisasi dan Generalisasi dengan memberi alat diagnosis yang presisi: membaca gap antara metrik latih dan metrik validasi, mengenali bentuk kurvanya, lalu mengukur keduanya lewat eksperimen nyata pada CPU dengan PyTorch 2.14.1.
Definisi Presisi: Membaca Gap Latih-Validasi #
Kedua istilah di atas sering dipakai longgar dalam percakapan, tetapi keduanya punya definisi yang dapat diukur. Misalkan galat_latih adalah loss atau galat model pada data latih dan galat_validasi adalah nilai yang sama pada data validasi yang tidak pernah ikut melatih bobot. Dua besaran tersebut, bersama selisihnya yang kita sebut gap, langsung membentuk diagnosis:
| Kondisi | Galat latih | Galat validasi | Gap | Bacaan |
|---|---|---|---|---|
| Underfitting | tinggi | tinggi | sempit | model tidak sanggup belajar pola, bahkan dari data latih |
| Sehat | rendah | rendah | sempit | model belajar pola yang juga berlaku pada data baru |
| Overfitting | rendah | tinggi | lebar | model menghafal data latih, polanya tidak berlaku pada data baru |
Gap didefinisikan sebagai selisih galat_validasi − galat_latih (atau kebalikannya untuk metrik naik seperti akurasi). Alur diagnosisnya ringkas — ukur dua angka, bandingkan, simpulkan:
Kurva Karakteristik #
Overfitting paling mudah dikenali dari bentuk kurva loss terhadap epoch. Loss latih turun terus sepanjang pelatihan karena optimizer memang ditugaskan mengecilkannya. Loss validasi turun di awal bersama loss latih, mencapai titik terendah, lalu berbalik naik — titik balik itulah momen model beralih dari “belajar pola” menjadi “menghafal noise”. Gambar berikut dihasilkan langsung oleh skrip demo di bawah pada mesin uji ini:
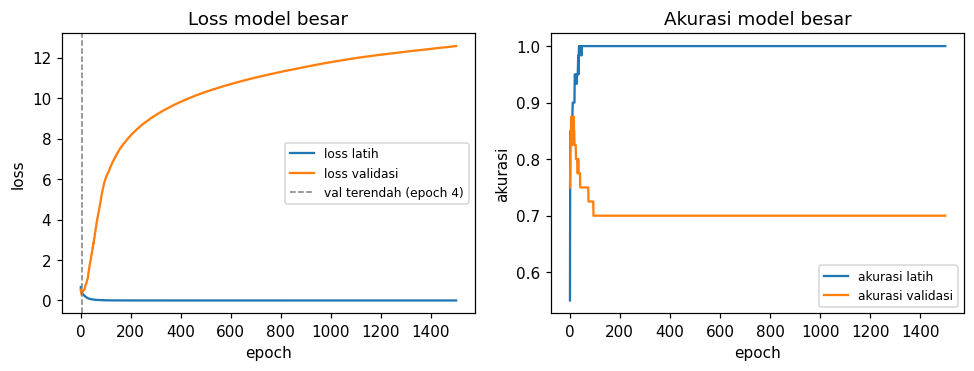
Panel kiri memperlihatkan pola gunting yang khas: loss latih merosot menuju nol sementara loss validasi menanjak. Panel kanan menunjukkan akurasi latih menempel di 1,000 sedangkan akurasi validasi tertahan — jarak kedua kurva itulah gap yang kita definisikan di atas.
Demo Terukur: Tiga Ukuran Model pada 100 Sampel #
Eksperimen berikut memakai bahan overfitting yang mudah diulang: 100 sampel make_moons dengan noise 0,30, dibagi 60 sampel latih dan 40 sampel validasi. Tiga MLP dengan lebar hidden layer 2, 16, dan 128 dilatih 1500 epoch penuh dengan seed tetap sehingga seluruh angka keluaran dapat direproduksi:
"""Overfitting yang terukur: MLP tiga ukuran pada 100 sampel make_moons.

Tiga model dengan kapasitas berbeda (kecil, sedang, besar) dilatih pada
60 sampel latih dan diuji pada 40 sampel validasi. Model besar sengaja
diberi kapasitas jauh melebihi jumlah data supaya gap train-validasi
terlihat jelas. Kurva loss latih vs validasi model besar disimpan ke
berkas kurva_overfitting.png.
"""

import torch
import torch.nn as nn
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split

torch.manual_seed(42)

# ---------- 1. Data: 100 sampel make_moons, 60 latih / 40 validasi ----------
X, y = make_moons(n_samples=100, noise=0.30, random_state=42)
X_latih, X_val, y_latih, y_val = train_test_split(
    X, y, test_size=0.40, random_state=42
)

# Standardisasi dihitung dari data latih saja
rata2 = X_latih.mean(axis=0)
simpangan = X_latih.std(axis=0)
X_latih = (X_latih - rata2) / simpangan
X_val = (X_val - rata2) / simpangan

X_latih_t = torch.tensor(X_latih, dtype=torch.float32)
y_latih_t = torch.tensor(y_latih, dtype=torch.long)
X_val_t = torch.tensor(X_val, dtype=torch.float32)
y_val_t = torch.tensor(y_val, dtype=torch.long)

print("dataset : make_moons 100 sampel | latih", len(y_latih_t),
      "| validasi", len(y_val_t), "| noise 0.30")


# ---------- 2. Pembuat model dengan lebar hidden layer bervariasi ----------
def buat_model(lebar):
    torch.manual_seed(42)  # ketiga model berangkat dari bobot awal serupa
    return nn.Sequential(
        nn.Linear(2, lebar),
        nn.ReLU(),
        nn.Linear(lebar, lebar),
        nn.ReLU(),
        nn.Linear(lebar, 2),
    )


def jumlah_parameter(model):
    return sum(p.numel() for p in model.parameters())


# ---------- 3. Training full-batch dengan pencatatan metrik tiap epoch ----------
criterion = nn.CrossEntropyLoss()
JUMLAH_EPOCH = 1500

riwayat = {}
for nama, lebar in (("kecil", 2), ("sedang", 16), ("besar", 128)):
    model = buat_model(lebar)
    optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
    catatan = {"loss_latih": [], "loss_val": [], "akurasi_latih": [],
               "akurasi_val": []}

    for epoch in range(JUMLAH_EPOCH):
        model.train()
        optimizer.zero_grad()
        logits = model(X_latih_t)
        loss = criterion(logits, y_latih_t)
        loss.backward()
        optimizer.step()

        model.eval()
        with torch.no_grad():
            logits_val = model(X_val_t)
            catatan["loss_latih"].append(loss.item())
            catatan["loss_val"].append(criterion(logits_val, y_val_t).item())
            catatan["akurasi_latih"].append(
                (logits.argmax(dim=1) == y_latih_t).float().mean().item())
            catatan["akurasi_val"].append(
                (logits_val.argmax(dim=1) == y_val_t).float().mean().item())

    riwayat[nama] = catatan
    print(f"model {nama:5s}: lebar {lebar:3d} | parameter {jumlah_parameter(model):5d}")

# ---------- 4. Kurva model besar: gap train-validasi melebar ----------
print("\nepoch terpilih | loss latih | loss val | akurasi latih | akurasi val")
besar = riwayat["besar"]
for epoch in (1, 250, 500, 750, 1000, 1250, 1500):
    i = epoch - 1
    print(f"epoch {epoch:5d}      | {besar['loss_latih'][i]:10.4f} | "
          f"{besar['loss_val'][i]:8.4f} | {besar['akurasi_latih'][i]:13.3f} | "
          f"{besar['akurasi_val'][i]:11.3f}")

epoch_terbaik = min(range(JUMLAH_EPOCH), key=lambda i: besar["loss_val"][i]) + 1
print(f"\nloss validasi terendah model besar dicapai di epoch {epoch_terbaik}")

# ---------- 5. Ringkasan akhir tiga model ----------
print(f"\n{'model':6s} | {'parameter':>9s} | {'akurasi latih':>14s} | "
      f"{'akurasi val':>12s} | {'gap':>6s}")
for nama in ("kecil", "sedang", "besar"):
    c = riwayat[nama]
    ak_latih = c["akurasi_latih"][-1]
    ak_val = c["akurasi_val"][-1]
    lebar = {"kecil": 2, "sedang": 16, "besar": 128}[nama]
    model = buat_model(lebar)  # hanya untuk menghitung jumlah parameter
    print(f"{nama:6s} | {jumlah_parameter(model):9d} | {ak_latih:14.3f} | "
          f"{ak_val:12.3f} | {ak_latih - ak_val:6.3f}")

# ---------- 6. Simpan kurva loss dan akurasi model besar ----------
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(9, 3.5))
epok = range(1, JUMLAH_EPOCH + 1)
ax1.plot(epok, besar["loss_latih"], label="loss latih")
ax1.plot(epok, besar["loss_val"], label="loss validasi")
ax1.axvline(epoch_terbaik, color="gray", linestyle="--", linewidth=1,
            label=f"val terendah (epoch {epoch_terbaik})")
ax1.set_xlabel("epoch")
ax1.set_ylabel("loss")
ax1.set_title("Loss model besar")
ax1.legend(fontsize=8)
ax2.plot(epok, besar["akurasi_latih"], label="akurasi latih")
ax2.plot(epok, besar["akurasi_val"], label="akurasi validasi")
ax2.set_xlabel("epoch")
ax2.set_ylabel("akurasi")
ax2.set_title("Akurasi model besar")
ax2.legend(fontsize=8)
fig.tight_layout()
fig.savefig("kurva_overfitting.png", dpi=110, bbox_inches="tight")
print("\nberkas kurva_overfitting.png berhasil dibuat")
Output yang Dihasilkan:
dataset : make_moons 100 sampel | latih 60 | validasi 40 | noise 0.30
model kecil: lebar   2 | parameter    18
model sedang: lebar  16 | parameter   354
model besar: lebar 128 | parameter 17154

epoch terpilih | loss latih | loss val | akurasi latih | akurasi val
epoch     1      |     0.6690 |   0.5331 |         0.550 |       0.750
epoch   250      |     0.0008 |   8.7157 |         1.000 |       0.700
epoch   500      |     0.0002 |  10.3006 |         1.000 |       0.700
epoch   750      |     0.0001 |  11.1585 |         1.000 |       0.700
epoch  1000      |     0.0000 |  11.7748 |         1.000 |       0.700
epoch  1250      |     0.0000 |  12.2182 |         1.000 |       0.700
epoch  1500      |     0.0000 |  12.5691 |         1.000 |       0.700

loss validasi terendah model besar dicapai di epoch 4

model  | parameter |  akurasi latih |  akurasi val |    gap
kecil  |        18 |          0.883 |        0.750 |  0.133
sedang |       354 |          1.000 |        0.725 |  0.275
besar  |     17154 |          1.000 |        0.700 |  0.300

berkas kurva_overfitting.png berhasil dibuat
Mari kita telaah kode di atas baris per baris:
- Baris 15 (
torch.manual_seed(42)): mengunci pembangkit acak global — bersamarandom_state=42padamake_moonsdantrain_test_split, seluruh alur data dan inisialisasi bobot menjadi deterministik. - Baris 18-21 (data dan pembagian): 100 sampel dibagi 60 latih / 40 validasi;
train_test_splitmengacak sebelum memotong sehingga kedua subset berimbang kelasnya. - Baris 23-27 (standardisasi jujur): rata-rata dan simpangan dihitung dari data latih saja lalu diterapkan ke keduanya — statistik data validasi tidak boleh bocor ke preprocessing.
- Baris 39-47 (
buat_model): seed di-reset ke 42 di dalam fungsi sehingga ketiga model berangkat dari bobot awal yang serupa; satu-satunya perbedaan adalah lebar hidden layer yang menentukan jumlah parameter: 18, 354, dan 17154. - Baris 59-63 (loop tiga model): tiap model mendapat optimizer Adam yang sama (
lr=0.01) dan kuota epoch yang sama, sehingga perbedaan hasil murni berasal dari kapasitas. - Baris 65-81 (satu epoch): pola
train() → zero_grad → forward → loss → backward → stepdari chapter Training Loop , lalueval()+torch.no_grad()untuk mencatat metrik latih dan validasi tiap epoch. - Baris 87-96 (tabel epoch terpilih): mencetak tujuh epoch sampel agar pola gunting terbaca tanpa membanjiri terminal; baris 95 mencari epoch dengan loss validasi terendah — titik balik kurva.
- Baris 98-108 (ringkasan): kolom
gapdihitung sebagaiakurasi_latih − akurasi_val, definisi operasional dari pembuka chapter. - Baris 110-134 (PNG): kurva model besar disimpan ke
kurva_overfitting.pngdengandpi=110danbbox_inches="tight"— gambar yang disematkan pada bagian sebelumnya.
Membaca Hasil: Kapasitas Menentukan Gap #
Tiga baris ringkasan akhir menceritakan tiga diagnosis berbeda. Model kecil (18 parameter) underfitting ringan: akurasi latihnya 0,883 — belum sempurna karena kapasitasnya kurang untuk memisahkan dua bulan sabit yang bertumpuk noise — dengan gap 0,133. Model sedang dan besar sama-sama mencapai akurasi latih 1,000, tetapi gap melebar dari 0,275 menjadi 0,300. Model besar memegang 17.154 parameter untuk 60 sampel latih — hampir 286 parameter per sampel — cukup luas untuk menghafal posisi tiap titik beserta noisenya. Tabel epoch memperlihatkan proses hafalan itu: loss latih 0,0008 di epoch 250 lalu praktis nol, sementara loss validasi justru menanjak dari 8,7157 ke 12,5691. Paling mencolok, loss validasi terendah model besar sudah tercapai di epoch 4 — sebelum model sempat menghafal apa pun.
Penyebab dan Penangkalnya #
Overfitting dan underfitting punya beberapa sumber umum dengan penangkal yang berbeda. Tabel berikut merangkum keduanya sekaligus menjadi peta jalan sisa section ini:
| Sumber masalah | Diagnosis umum | Penangkal | Dibahas pada |
|---|---|---|---|
| Kapasitas model jauh melebihi jumlah data | overfitting | perkecil model, atau regularisasi | Dropout , Weight Decay |
| Pelatihan terlalu lama melewati titik balik | overfitting | hentikan saat validasi memburuk | Early Stopping |
| Data latih terlalu sedikit | overfitting | augmentasi data, transfer learning | Data Augmentation , Transfer Learning |
| Model terlalu sederhana / fitur terlalu sedikit | underfitting | tambah kapasitas, latih lebih lama, perbaiki fitur | — |
| Learning rate terlalu kecil / optimizer salah | underfitting | naikkan learning rate, ganti optimizer | Loss dan Optimizer |
Kita kini punya definisi terukur dan bukti empiris bahwa gap latih-validasi tumbuh bersama kapasitas model. Pertanyaan berikutnya bersifat teoretis namun praktis: dari mana gap itu berasal secara matematis, dan mengapa menambah kapasitas memperlebar gap pada sebagian data tetapi tidak pada data lain? Chapter Bias-Variance menjawabnya lewat dekomposisi galat yang membedakan galat sistematis, kepekaan terhadap data latih, dan noise yang mustahil diprediksi siapa pun.