Chapter Overfitting dan Underfitting memberi kita definisi operasional: gap antara metrik latih dan validasi. Dekomposisi bias-variance menjelaskan dari mana gap itu berasal. Galat model pada data baru dapat diurai menjadi tiga komponen — galat sistematis yang tidak hilang berapa pun data dilatih, kepekaan model terhadap data latih tertentu, dan noise yang mustahil diprediksi siapa pun. Pemahaman ini mengubah pilihan arsitektur dari tebakan menjadi penyeimbangan yang sadar: model terlalu kaku menanggung bias, model terlalu lentur menanggung variance. Chapter ini membuktikan keduanya lewat regresi polinomial derajat 1, 3, dan 15 yang diuji nyata dengan NumPy dan scikit-learn.
Dekomposisi Galat Menjadi Tiga Komponen #
Bayangkan proses pembangkitan data y = f(x) + noise, dengan f fungsi sejati dan noise acak yang tidak bergantung pada x. Untuk satu titik x, galat kuadrat prediksi model — dirata-ratakan atas berbagai kemungkinan himpunan data latih — terurai menjadi:
| Komponen | Makna | Sumber | Dapat dikurangi? |
|---|---|---|---|
| Bias² | galat sistematis: rata-rata prediksi meleset dari f(x) secara konsisten | model terlalu kaku untuk pola f | ya, tambah kapasitas |
| Variance | kepekaan: prediksi bergoyang ketika data latih diganti-ganti | model terlalu lentur, menghafal tiap sampel | ya, regularisasi / data lebih banyak |
Noise (sigma^2) | komponen acak yang tidak bergantung pada x | proses pengukuran / ketidakpastian data | tidak — batas bawah galat |
Tiga komponen tersebut menarik ke arah berlawanan. Model sederhana — garis lurus untuk data sinus — punya bias tinggi: rata-rata prediksinya meleset secara konsisten, tetapi variance rendah karena hasil latih nyaris tak berubah saat data diganti. Model raksasa melakukan kebalikannya: bias pada data latih mendekati nol, tetapi tiap pertukaran data menghasilkan fungsi yang jauh berbeda. Hubungan ini persis menjelaskan diagnosis pada chapter sebelumnya: underfitting adalah bias dominan, overfitting adalah variance dominan.
Percobaan Tunggal: Derajat 1, 3, 15 #
Data dibangkitkan dari fungsi sejati sin(2*pi*x) ditambah noise acak bersimpangan 0,25 pada rentang x antara 0 dan 1. Tiga model polinomial — derajat 1 (garis), derajat 3 (lengkung sederhana), derajat 15 (sangat lentur) — dilatih pada 24 sampel lalu diuji pada 200 sampel tetap. Skrip lengkapnya:
"""Dekomposisi bias-variance lewat regresi polinomial derajat 1, 3, 15.

Data dibangkitkan dari fungsi sejati sin(2*pi*x) dengan noise Gaussian.
Tiga model polinomial dilatih pada 24 sampel latih lalu diuji pada 200
sampel uji tetap. Percobaan diulang 40 kali dengan sampel latih berbeda
untuk menunjukkan variance: goyangan galat uji antar percobaan.
Kurva bias-variance (galat latih vs galat uji terhadap derajat) disimpan
ke berkas kurva_bias_variance.png.
"""

import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures

def f_sejati(x):
    return np.sin(2 * np.pi * x)

def buat_sampel_latih(rng, jumlah=24, noise=0.25):
    x = rng.uniform(0.0, 1.0, size=jumlah)
    y = f_sejati(x) + rng.normal(0.0, noise, size=jumlah)
    return x, y

# ---------- 1. Satu percobaan representatif: derajat 1, 3, 15 ----------
rng = np.random.default_rng(42)
x_latih, y_latih = buat_sampel_latih(rng)

rng_uji = np.random.default_rng(7)
x_uji = np.linspace(0.0, 1.0, 200)
y_uji = f_sejati(x_uji) + rng_uji.normal(0.0, 0.25, size=200)

def format_nilai(v):
    """Format angka: desimal tetap bila kecil, notasi ilmiah bila besar."""
    return f"{v:.4f}" if abs(v) < 1000 else f"{v:.2e}"

print("percobaan tunggal | 24 sampel latih | 200 sampel uji | noise sigma 0.25")
print(f"{'derajat':>7s} | {'MSE latih':>10s} | {'MSE uji':>9s} | "
      f"{'||koefisien||':>13s}")
for derajat in (1, 3, 15):
    pola = PolynomialFeatures(degree=derajat, include_bias=False)
    X_latih = pola.fit_transform(x_latih.reshape(-1, 1))
    X_uji = pola.transform(x_uji.reshape(-1, 1))
    model = LinearRegression().fit(X_latih, y_latih)
    mse_latih = np.mean((model.predict(X_latih) - y_latih) ** 2)
    mse_uji = np.mean((model.predict(X_uji) - y_uji) ** 2)
    norm_koef = np.linalg.norm(model.coef_)
    print(f"{derajat:7d} | {format_nilai(mse_latih):>10s} | "
          f"{format_nilai(mse_uji):>9s} | {format_nilai(norm_koef):>13s}")

# ---------- 2. Ulangi 40 kali: mean dan simpangan galat uji ----------
JUMLAH_ULANGAN = 40
hasil_uji = {1: [], 3: [], 15: []}
for ulang in range(JUMLAH_ULANGAN):
    rng = np.random.default_rng(1000 + ulang)
    x_l, y_l = buat_sampel_latih(rng)
    for derajat in (1, 3, 15):
        pola = PolynomialFeatures(degree=derajat, include_bias=False)
        X_l = pola.fit_transform(x_l.reshape(-1, 1))
        X_u = pola.transform(x_uji.reshape(-1, 1))
        model = LinearRegression().fit(X_l, y_l)
        mse_uji = np.mean((model.predict(X_u) - y_uji) ** 2)
        hasil_uji[derajat].append(mse_uji)

print(f"\n{JUMLAH_ULANGAN} ulangan, sampel latih diacak ulang tiap ulangan")
print(f"{'derajat':>7s} | {'rata2 MSE uji':>14s} | {'simpangan':>10s}")
for derajat in (1, 3, 15):
    nilai = np.array(hasil_uji[derajat])
    print(f"{derajat:7d} | {format_nilai(nilai.mean()):>14s} | "
          f"{format_nilai(nilai.std()):>10s}")

# ---------- 3. Kurva bias-variance: derajat 0 sampai 15 ----------
rata_latih, rata_uji = [], []
for derajat in range(0, 16):
    galat_l, galat_u = [], []
    for ulang in range(JUMLAH_ULANGAN):
        rng = np.random.default_rng(1000 + ulang)
        x_l, y_l = buat_sampel_latih(rng)
        if derajat == 0:
            X_l = np.ones((len(x_l), 1))   # model konstan: hanya intercept
            X_u = np.ones((len(x_uji), 1))
        else:
            pola = PolynomialFeatures(degree=derajat, include_bias=False)
            X_l = pola.fit_transform(x_l.reshape(-1, 1))
            X_u = pola.transform(x_uji.reshape(-1, 1))
        model = LinearRegression().fit(X_l, y_l)
        galat_l.append(np.mean((model.predict(X_l) - y_l) ** 2))
        galat_u.append(np.mean((model.predict(X_u) - y_uji) ** 2))
    rata_latih.append(np.mean(galat_l))
    rata_uji.append(np.mean(galat_u))

# ---------- 4. Simpan kurva bias-variance ----------
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(7, 4))
derajat_axis = range(0, 16)
ax.plot(derajat_axis, rata_uji, marker="o", label="galat uji (40 ulangan)")
ax.plot(derajat_axis, rata_latih, marker="s", label="galat latih (40 ulangan)")
ax.set_yscale("log")
ax.set_xlabel("derajat polinomial (kompleksitas model)")
ax.set_ylabel("MSE rata-rata (skala log)")
ax.set_title("Kurva bias-variance")
ax.legend()
fig.tight_layout()
fig.savefig("kurva_bias_variance.png", dpi=110, bbox_inches="tight")
print("\nderajat dengan galat uji terendah:",
      int(np.argmin(rata_uji)), "| MSE uji:", format_nilai(min(rata_uji)))
print("berkas kurva_bias_variance.png berhasil dibuat")
Output yang Dihasilkan:
percobaan tunggal | 24 sampel latih | 200 sampel uji | noise sigma 0.25
derajat |  MSE latih |   MSE uji | ||koefisien||
      1 |     0.2210 |    0.2795 |        1.8470
      3 |     0.0280 |    0.0573 |       45.2848
     15 |     0.0112 |  7.26e+03 |      5.45e+10

40 ulangan, sampel latih diacak ulang tiap ulangan
derajat |  rata2 MSE uji |  simpangan
      1 |         0.3039 |     0.0245
      3 |         0.0664 |     0.0101
     15 |       3.75e+06 |   1.33e+07

derajat dengan galat uji terendah: 3 | MSE uji: 0.0664
berkas kurva_bias_variance.png berhasil dibuat
Mari kita telaah kode di atas baris per baris:
- Baris 15-21 (fungsi bangkit data):
f_sejatiadalah fungsi sejati yang ingin kita dekati;buat_sampel_latihmenarik x acak seragam lalu menambahkan noise normal — menerima objekrngagar tiap ulangan reproducible. - Baris 24-29 (dua himpunan tetap): seed 42 membangkitkan 24 sampel latih; seed 7 membangkitkan 200 sampel uji yang dipakai tetap di seluruh percobaan — syarat agar perbandingan antar model adil.
- Baris 31-33 (
format_nilai): memformat angka kecil sebagai desimal tetap dan angka besar sebagai notasi ilmiah. - Baris 38-47 (percobaan tunggal):
PolynomialFeaturesmengubah kolomxmenjadi kolomx, x², …, x^derajat(dokumentasi: PolynomialFeatures );LinearRegressionmenyelesaikan regresi linear pada fitur hasil perluasan itu; norma koefisien dicetak sebagai indikator kompleksitas. - Baris 52-61 (40 ulangan): tiap ulangan memakai seed berbeda
1000 + ulangsehingga 24 sampel latih diacak ulang, model dilatih dari nol, lalu MSE uji dicatat — 40 angka per derajat. - Baris 63-68 (tabel ulangan): rata-rata MSE uji memperkirakan galat yang diharapkan; simpangan antar ulangan memperkirakan variance — komponen kedua dekomposisi.
- Baris 70-88 (kurva lengkap): perluasan ke derajat 0 sampai 15, masing-masing 40 ulangan, menghasilkan titik kurva bias-variance; derajat 0 dimodelkan sebagai kolom konstan satu-satunya.
- Baris 90-108 (PNG): kurva disimpan dalam skala log karena rentang MSE mencapai tujuh orde besaran.
Membaca Angka: Pola Bias dan Pola Variance #
Tabel percobaan tunggal menampilkan pola klasik. Derajat 1 mengalami bias: MSE latih 0,2210 dan MSE uji 0,2795 sama-sama besar — garis lurus memang tidak bisa mengikuti sinus, di data latih maupun data uji. Derajat 3 menyeimbangkan keduanya (0,0280 berbanding 0,0573). Derajat 15 memperlihatkan tanda variance: MSE latih terkecil (0,0112) tetapi MSE uji melesat ke 7.26e+03 dengan norma koefisien 5.45e+10 — kurva berkelok liar demi menembus tiap titik latih, dan di sela-sela titik itu prediksinya melesat jauh.
Bagian kedua keluaran mengukur komponen tersebut secara langsung. Rata-rata MSE uji derajat 1 adalah 0,3039 dengan simpangan 0,0245 — galatnya besar tapi stabil: bias dominan. Derajat 15 mencatat rata-rata 3.75e+06 dengan simpangan 1.33e+07 — simpangan yang jauh melampaui rata-ratanya berarti hasil latih benar-benar bergantung pada 24 sampel yang kebetulan ditarik: variance dominan. Derajat 3 menang dengan MSE uji terendah 0,0664 dan simpangan kecil 0,0101.
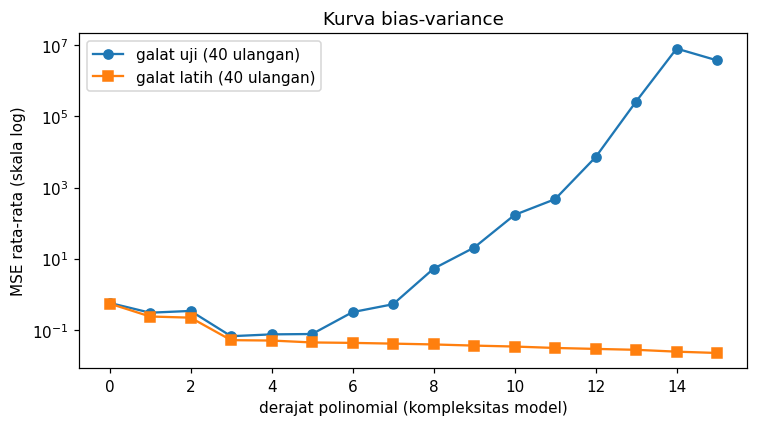
Kurva di atas — rata-rata atas 40 ulangan untuk derajat 0 sampai 15 — memperlihatkan trade-off: galat uji (lingkaran) merosot sampai sekitar derajat 3 lalu menanjak kembali, sementara galat latih (kotak) terus menurun. Jarak kedua kurva yang melebar di kanan adalah variance yang tumbuh; ketinggalan galat latih di kiri adalah bias.
Estimasi Empiris dengan Repeated Splits #
Bagaimana praktiknya di deep learning, tempat dekomposisi analitik tidak bisa dihitung? Resepnya persis skrip di atas: ulangi pelatihan dengan pembagian data latih yang diacak ulang, lalu baca rata-rata galat validasi sebagai perkiraan galat dan simpangannya sebagai perkiraan variance. Rata-rata tinggi dengan simpangan rendah menandakan bias — perbaiki dengan kapasitas; simpangan tinggi menandakan variance — perbaiki dengan regularisasi, fokus tiga chapter berikutnya.
Mekanisme regularisasi paling terkenal dimulai dari satu gagasan sederhana: bagaimana jika selama pelatihan kita acak-acak jaringan sendiri? Chapter Dropout membahas teknik tersebut — mematikan neuron secara acak tiap forward pass — dan membuktikan efeknya pada gap latih-validasi yang menyempit.