Dua pertanyaan dari chapter sebelumnya masih terbuka. Pertama, bagaimana memilih jadwal β_1 … β_T — noise schedule — karena pilihan itu menentukan seberapa cepat sinyal mati dan seberapa halus tiap langkah pembalikan. Kedua, mengapa jaringan cukup dilatih dengan MSE biasa untuk memprediksi derau, tanpa loss adversarial maupun istilah regularizer apa pun. Chapter ini menjawab keduanya lalu menggabungkan seluruh potongan menjadi pipeline utuh: denoiser mini di atas data cincin 2D, dilatih seribu iterasi, lalu menghasilkan sampel baru lewat loop sampling reverse — dari derau murni menjadi titik-titik yang menempel pada cincin.
Noise Schedule: Linear vs Cosine #
Jadwal DDPM asli bersifat linear: β_t naik dari 1e-4 ke 0.02 selama T = 1000. Persoalannya terlihat pada ᾱ_t: linear menjatuhkan sisa sinyal terlalu cepat di paruh awal, sehingga langkah-langkah tengah bekerja pada data yang hampir habis. Jadwal cosine dari Nichol & Dhariwal (Improved DDPM, arxiv.org/abs/2102.09672
) membentuk ᾱ_t langsung sebagai kurva kosinus yang mulus turun ke nol. Berkas noise_schedule.py membandingkan keduanya:
"""Jadwal derau (noise schedule): linear vs cosine untuk T = 1000.

Kedua jadwal dibandingkan lewat alpha_bar_t dan SNR-nya pada beberapa
timestep, lalu kurvanya disimpan sebagai berkas noise_schedule.png.
"""

import numpy as np
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt

T = 1000


def alpha_bar_linear(T, beta_awal=1e-4, beta_akhir=0.02):
    """Jadwal DDPM asli: beta naik linear, alpha_bar hasil kali beruntun."""
    beta = np.linspace(beta_awal, beta_akhir, T)
    return np.cumprod(1.0 - beta)


def alpha_bar_cosine(T, s=0.008):
    """Jadwal cosine (Nichol & Dhariwal 2021)."""
    def f(t):
        return np.cos((t / T + s) / (1.0 + s) * np.pi / 2.0) ** 2
    return f(np.arange(T + 1)) / f(0.0)


ab_linear = alpha_bar_linear(T)
ab_cosine = alpha_bar_cosine(T)


def snr_db(ab):
    """SNR (dB) dari alpha_bar; tangani kasus tepat 0 dan 1."""
    if ab <= 0.0:
        return float("-inf")
    if ab >= 1.0:
        return float("inf")
    return 10.0 * np.log10(ab / (1.0 - ab))


print(f"Jadwal derau untuk T = {T} langkah")
print()
print("   t   | alpha_bar linear | alpha_bar cosine | SNR lin (dB) | SNR cos (dB)")
print("-------+------------------+------------------+--------------+-------------")
for t in (1, 100, 250, 500, 750, 900, 1000):
    lin = ab_linear[t - 1]
    cos = ab_cosine[t]
    print(f" {t:5d} | {lin:16.4f} | {cos:16.4f} | "
          f"{snr_db(lin):12.1f} | {snr_db(cos):12.1f}")

print()
print("Selisih terbesar alpha_bar (t di 1..1000):",
      f"{np.max(ab_cosine[1:] - ab_linear):.3f}",
      "pada t =", int(np.argmax(ab_cosine[1:] - ab_linear)) + 1)

# ---------- Kurva alpha_bar kedua jadwal ----------
fig, ax = plt.subplots(figsize=(6.5, 3.8))
langkah = np.arange(1, T + 1)
ax.plot(langkah, ab_linear, label="linear (DDPM)", color="#1f77b4")
ax.plot(langkah, ab_cosine[1:], label="cosine", color="#d62728")
ax.set_yscale("log")
ax.set_xlabel("timestep t")
ax.set_ylabel("alpha_bar_t (skala log)")
ax.set_title("Sisa sinyal: jadwal linear vs cosine")
ax.legend()
ax.grid(True, which="both", alpha=0.3)
fig.savefig("noise_schedule.png", dpi=110, bbox_inches="tight")
print("\nKurva disimpan ke noise_schedule.png")
Output yang Dihasilkan:
Jadwal derau untuk T = 1000 langkah

   t   | alpha_bar linear | alpha_bar cosine | SNR lin (dB) | SNR cos (dB)
-------+------------------+------------------+--------------+-------------
     1 |           0.9999 |           1.0000 |         40.0 |         43.8
   100 |           0.8970 |           0.9721 |          9.4 |         15.4
   250 |           0.5241 |           0.8470 |          0.4 |          7.4
   500 |           0.0786 |           0.4938 |        -10.7 |         -0.1
   750 |           0.0034 |           0.1443 |        -24.7 |         -7.7
   900 |           0.0003 |           0.0241 |        -35.6 |        -16.1
  1000 |           0.0000 |           0.0000 |        -43.9 |       -324.3

Selisih terbesar alpha_bar (t di 1..1000): 0.453 pada t = 409

Kurva disimpan ke noise_schedule.png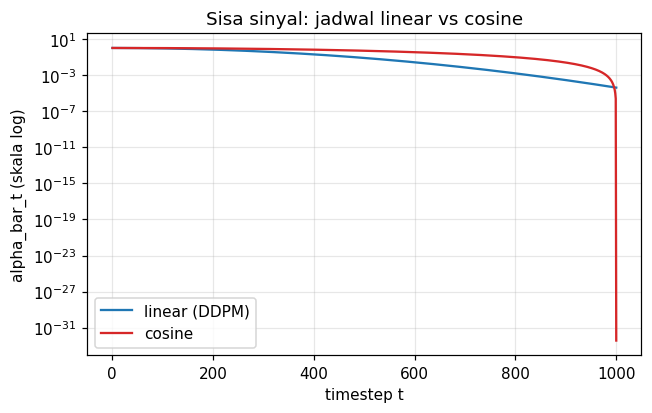
Angka kuncinya: pada t = 250, linear hanya menyisakan 0.524 sinyal sedangkan cosine masih 0.847; selisih terbesar 0.453 terjadi di t = 409. Cosine menjaga langkah-langkah awal-tengah tetap kaya sinyal dan menunda proses hilangnya sinyal hingga ujung rantai — SNR cosine masih -0.1 dB di t = 500, saat linear sudah -10.7 dB. Pada model gambar nyata, perbedaan ini berdampak langsung pada kualitas sampel. Mari kita telaah kodenya baris per baris:
- Baris 17-20 (
alpha_bar_linear): jadwal linear persis DDPM —np.linspaceuntukβlalunp.cumproduntukᾱ. - Baris 23-27 (
alpha_bar_cosine): cosine justru mendefinisikanᾱ_tlebih dulu lewatf(t)/f(0); nilaiβjika perlu diperoleh dengan membalik relasiβ_t = 1 − ᾱ_t/ᾱ_{t-1}(pola yang dipakai lagi di skrip kedua). Parameters = 0.008menggeser kurva agarβ_1tidak nol. - Baris 33-39 (
snr_db): SNR dihitung dariᾱ; dua penjagaifmenangani tepiᾱ = 0danᾱ = 1agar logaritma tetap aman. - Baris 41-60 (tabel dan plot): tujuh timestep cukup untuk membaca karakter kurva; plot memakai skala log agar rentang
1e-5 … 1terlihat sekaligus, lalu disimpan ke bundle sebagai PNG.
Objectif Training: Mengapa MSE pada ε Sudah Cukup #
Objectif DDPM tampak mencurigakan sederhana:
L = E_{t, x_0, ε} [ || ε − ε_θ( sqrt(ᾱ_t)·x_0 + sqrt(1−ᾱ_t)·ε , t ) ||² ]
Pilih t acak, bangun x_t lewat bentuk tertutup, minta jaringan menebak ε, dan hukum kesalahan dengan MSE. Intuisinya: pada setiap (x_t, t), mengetahui derau ε sama dengan mengetahui x_0 (rumus pembalikan dari chapter sebelumnya) sekaligus mean reverse μ_θ. MSE antara ε dan ε_θ karenanya adalah pengukur langsung kualitas setiap langkah pembalikan — dan secara formal dapat diturunkan sebagai batas atas (bound) log-likelihood data dengan bobot tetap dari jadwal. Tidak ada dua jaringan yang saling menekan seperti GAN; gradien datang dari satu istilah kuadrat yang mulus.
Pilihan memprediksi ε (bukan langsung x_0) juga bukan kebetulan:
| Parametrisasi | Target | Sifat |
|---|---|---|
ε_θ (DDPM) | derau N(0, I) | target berskala seragam di semua t — stabil |
x̂_0 | data asli | skala bergantung data; galat kecil di t besar terpelintir besar saat dibalik |
v (v-prediction) | gabungan keduanya | kompromi untuk t besar, dipakai model modern |
Karena ε selalu berdistribusi sama (N(0, I)) di semua timestep, loss MSE tidak bergeser masalah skala antar t — salah satu sumber kestabilan training diffusion.
Denoiser Mini: Training dan Sampling Reverse dalam Satu Berkas #
Berkas denoiser_mini.py adalah pipeline lengkap skala meja. Data berupa 400 titik cincin radius 2.0; denoiser MLP dengan embedding timestep sinusoidal (pola sepupu positional embedding pada section Attention dan Transformer
) dilatih 1000 iterasi penuh-batch dengan Adam; sampling reverse lalu membalik T = 150 langkah dari derau murni menjadi 200 sampel baru:
"""Denoiser mini: melatih epsilon_theta lalu sampling reverse penuh.

Data 2D berbentuk cincin radius 2.0 (400 titik). Denoiser MLP menerima
(x_t, t) dan memprediksi derau epsilon. Training memakai bentuk tertutup
forward; sampling membalik T = 150 langkah dari derau murni menuju
sampel baru yang statistiknya dibandingkan dengan data.
Diuji pada CPU dengan PyTorch 2.14.
"""

import math

import numpy as np
import torch
import torch.nn as nn

torch.manual_seed(0)
rng = np.random.default_rng(0)

# ---------- 1. Data sintetis: cincin radius 2.0 ----------
N = 400
sudut = rng.uniform(0.0, 2.0 * np.pi, N)
r = 2.0 + 0.05 * rng.standard_normal(N)
data = np.stack([r * np.cos(sudut), r * np.sin(sudut)], axis=1)
x0 = torch.tensor(data, dtype=torch.float32)
radius_data = torch.linalg.norm(x0, dim=1)
print(f"data   : {N} titik cincin | radius rata-rata "
      f"{radius_data.mean():.3f} | std radius {radius_data.std():.3f}")

# ---------- 2. Jadwal derau cosine untuk T = 150 ----------
T = 150
s = 0.008


def f_cos(t):
    return np.cos((t / T + s) / (1.0 + s) * np.pi / 2.0) ** 2


ab_np = f_cos(np.arange(T + 1)) / f_cos(0.0)          # alpha_bar 0..T
beta_np = np.clip(1.0 - ab_np[1:] / ab_np[:-1], 1e-5, 0.999)
beta = torch.tensor(beta_np, dtype=torch.float32)
alpha = 1.0 - beta
alpha_bar = torch.cumprod(alpha, dim=0)
print(f"jadwal : cosine | beta {beta[0]:.5f}..{beta[-1]:.3f} | "
      f"alpha_bar_{T} = {alpha_bar[-1]:.2e}")

# ---------- 3. Denoiser: MLP dengan embedding timestep sinusoidal ----------
DIM_EMB = 32


def embedding_t(t):
    """Embedding sinusoidal timestep, seperti positional embedding."""
    setengah = DIM_EMB // 2
    frekuensi = torch.exp(
        -math.log(10000.0)
        * torch.arange(setengah, dtype=torch.float32) / setengah
    )
    sudut = t.float().unsqueeze(1) * frekuensi
    return torch.cat([torch.sin(sudut), torch.cos(sudut)], dim=1)


class Denoiser(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(2 + DIM_EMB, 256),
            nn.SiLU(),
            nn.Linear(256, 256),
            nn.SiLU(),
            nn.Linear(256, 2),
        )

    def forward(self, x, t):
        return self.net(torch.cat([x, embedding_t(t)], dim=1))


model = Denoiser()
n_param = sum(p.numel() for p in model.parameters())
print(f"model  : MLP [2+{DIM_EMB}, 256, 256, 2] | {n_param} parameter")

# ---------- 4. Training: prediksi epsilon dari (x_t, t) ----------
optimizer = torch.optim.Adam(model.parameters(), lr=3e-3)
loss_fn = nn.MSELoss()
ITERASI = 1000

for i in range(1, ITERASI + 1):
    t = torch.randint(1, T + 1, (N,))
    ab = alpha_bar[t - 1].unsqueeze(1)
    eps = torch.randn_like(x0)
    xt = torch.sqrt(ab) * x0 + torch.sqrt(1.0 - ab) * eps
    loss = loss_fn(model(xt, t), eps)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()
    if i in (1, 250, 500, 1000):
        print(f"iter {i:4d} | loss MSE {loss.item():.4f}")

# ---------- 5. Sampling: balik T langkah dari derau murni ----------
N_SAMPEL = 200
model.eval()
with torch.no_grad():
    x = torch.randn(N_SAMPEL, 2)                    # x_T ~ N(0, I)
    for t in range(T, 0, -1):
        t_batch = torch.full((N_SAMPEL,), t, dtype=torch.long)
        eps_pred = model(x, t_batch)                # tebakan derau
        ab = alpha_bar[t - 1]
        beta_t = beta[t - 1]
        koef = beta_t / torch.sqrt(1.0 - ab)
        mean = (x - koef * eps_pred) / torch.sqrt(alpha[t - 1])
        if t > 1:
            x = mean + torch.sqrt(beta_t) * torch.randn_like(x)
        else:
            x = mean                                # langkah terakhir tanpa derau

radius_sampel = torch.linalg.norm(x, dim=1)
acak = torch.randn(N_SAMPEL, 2)                    # pembanding derau murni
radius_acak = torch.linalg.norm(acak, dim=1)
pita = (radius_sampel > 1.8) & (radius_sampel < 2.2)
pita_acak = (radius_acak > 1.8) & (radius_acak < 2.2)

print(f"\nsampel : {N_SAMPEL} titik dari sampling reverse")
print(f"radius rata-rata sampel : {radius_sampel.mean():.3f} "
      f"(data: {radius_data.mean():.3f})")
print(f"std radius sampel       : {radius_sampel.std():.3f} "
      f"(data: {radius_data.std():.3f})")
print(f"di pita radius 1.8-2.2  : sampel {pita.float().mean():.1%} | "
      f"derau murni {pita_acak.float().mean():.1%}")
print("lima sampel pertama     :")
print(np.round(x[:5].numpy(), 3))
Output yang Dihasilkan:
data   : 400 titik cincin | radius rata-rata 2.000 | std radius 0.050
jadwal : cosine | beta 0.00037..0.999 | alpha_bar_150 = 1.08e-07
model  : MLP [2+32, 256, 256, 2] | 75266 parameter
iter    1 | loss MSE 0.9783
iter  250 | loss MSE 0.4678
iter  500 | loss MSE 0.4678
iter 1000 | loss MSE 0.4138

sampel : 200 titik dari sampling reverse
radius rata-rata sampel : 1.994 (data: 2.000)
std radius sampel       : 0.125 (data: 0.050)
di pita radius 1.8-2.2  : sampel 98.5% | derau murni 10.5%
lima sampel pertama     :
[[ 1.391 -1.658]
 [ 2.069 -0.042]
 [ 1.904  0.875]
 [ 0.532  1.884]
 [ 1.336  1.318]]
Hasilnya tegas: radius rata-rata sampel 1.994 terhadap data 2.000, dan 98.5% sampel jatuh di pita radius 1.8–2.2 — bandingkan dengan 10.5% jika titik ditarik langsung dari derau murni. Jaringan yang tidak pernah melihat proses pembalikan secara eksplisit berhasil merekonstruksi distribusi cincin dari sinyal x_t saja. Mari kita telaah kode di atas baris per baris:
- Baris 16-17 (seed):
torch.manual_seedmengunci inisialisasi bobot dan seluruh derau PyTorch;default_rngmengunci pembuatan data — keluaran identik di setiap eksekusi. - Baris 20-25 (data): sudut seragam + gangguan radius
0.05menghasilkan cincin;torch.linalg.norm(x0, dim=1)menghitung radius tiap titik sebagai statistik pembanding. - Baris 34-44 (jadwal cosine): sama seperti skrip pertama,
βdiperoleh dengan membalikᾱlalu dijepit (np.clip) ke[1e-5, 0.999]agarβtetap valid saatᾱmengecil drastis di ujung;alpha_bar_150 = 1.08e-07memastikanx_Tpraktis murni derau. - Baris 50-58 (
embedding_t): timestep integer diubah menjadi vektor 32 dimensi lewat sinus-kosinus multi-frekuensi — jaringan menerima informasityang kaya, bukan satu skalar;SiLUdipilih karena gradiennya halus di daerah negatif. - Baris 61-73 (
Denoiser):forward(x, t)menyambung koordinatx(2 dimensi) dengan embeddingt(32 dimensi) menjadi input 34 dimensi — satu jaringan melayani seluruh timestep. - Baris 85-95 (loop training): per iterasi,
torch.randintmemilihtacak per titik;xtdibangun sekali lewat bentuk tertutup (tanpa looptlangkah); target adalahepsyang benar-benar dipakai. Loss naik-turun antar iterasi (0.4678muncul dua kali) karena setiap iterasi mengestimasi ekspektasi padatberbeda — tren menurunnya tetap jelas:0.9783 → 0.4138. - Baris 99-101 (persiapan sampling):
model.eval()membekukan perilaku layer (wajib dibiasakan, lihat chapter Training Loop );torch.no_grad()mematikan pencatatan gradien;x = torch.randn(...)adalah titik awalx_T ~ N(0, I)— sama persis dengan distribusi tujuan forward. - Baris 102-112 (loop sampling reverse — inti proses): untuk
tdariTturun ke1: (a)eps_predadalah tebakan derau jaringan pada kondisi saat ini; (b)koef = β_t / sqrt(1−ᾱ_t)danmean = (x − koef·eps_pred) / sqrt(α_t)persis rumusμ_θdari chapter sebelumnya — kode dan rumus saling mengunci baris demi baris; (c) untukt > 1, derau segarsqrt(β_t)·zditambahkan kembali sesuaiσ_t = sqrt(β_t); (d) di langkah terakhir (t = 1) derau tidak ditambahkan agar sampel tidak menyimpan sisa gangguan. - Baris 114-118 (statistik): radius sampel dibandingkan radius data; pembanding
acakmenarik titik dariN(0, I)untuk menunjukkan seberapa jauh sampling reverse mengubah distribusi.
Membaca Trade-off Jumlah Langkah #
Loop sampling mengevaluasi jaringan T kali per sampel — biaya inference bawaan diffusion. Memangkas T dari 150 ke 50 mempercepat sampling tiga kali, tetapi tiap langkah kini membuang derau lebih besar sehingga kualitas sampel menurun. Riset decoding modern (DDIM, sampler konsistensi) memangkas ratusan langkah menjadi belasan dengan mengubah struktur loop-nya; loop ancestral di atas tetap rujukan paling mudah dipahami.
Pipeline kita bekerja pada ruang data asli berdimensi rendah. Pada gambar 512×512×3, ratusan evaluasi denoiser pada tensor piksel sebesar itu terasa berat — mahal saat training maupun sampling. Chapter Latent Diffusion menyelesaikannya dengan memindahkan seluruh proses diffusion ke ruang laten terkompresi.