Confusion matrix pada chapter sebelumnya memotret kondisi model setelah pelatihan selesai. Kurva learning memotret prosesnya — grafik loss latih dan loss validasi yang dicatat setiap epoch. Grafik tersebut memperlihatkan kapan model mulai menghafal, kapan kapasitasnya kurang, atau kapan langkah optimasinya terlalu agresif — jauh sebelum angka akhir memberi tanda. Chapter ini membangun eksperimen terkendali dengan empat konfigurasi yang sengaja dirancang untuk menampilkan empat pola berbeda, lalu melatih kebiasaan membaca kurva menjadi diagnosis dan tindakan. Seluruh pelatihan dijalankan nyata pada CPU dengan PyTorch 2.14 dan dataset kecil dari scikit-learn.
Anatomi Kurva Learning #
Kurva learning adalah grafik dengan dua garis. Sumbu horizontal mencatat epoch, sumbu vertikal mencatat nilai loss. Garis loss latih adalah rata-rata loss pada data yang dipakai memperbarui bobot; garis loss validasi dihitung pada data yang tidak pernah ikut pelatihan. Garis pertama mengukur seberapa baik model menghafal, garis kedua mengukur seberapa baik model menggeneralisasi.
Membaca kurva berarti menjawab tiga pertanyaan berikut:
- Level: di angka berapa kedua loss berakhir? Loss yang berhenti jauh di atas nol menandakan model tidak menangkap pola data.
- Gap: seberapa jauh garis validasi berada di atas garis latih? Gap lebar berarti performa pada data baru jauh di bawah performa saat pelatihan.
- Getaran: seberapa halus kurva pada paruh kedua? Kurva yang bergoyang kuat menandakan langkah optimasi terlalu besar.
Merekam kurva nyaris tanpa biaya: tambahkan dua list di Training Loop
dan catat nilai loss per epoch. Nilai validasi dihitung dengan model.eval() dan torch.no_grad() sehingga bobot tidak berubah selama evaluasi.
Eksperimen: Empat Konfigurasi yang Disengaja #
Berkas kurva_learning.py melatih empat konfigurasi pada dataset dua lingkaran konsentris (make_circles). Kuncinya pada dua konfigurasi besar: model sehat dan model overfit memakai arsitektur yang sama persis — 17.154 parameter — dengan bobot awal dan urutan batch yang identik; pembedanya hanya Dropout(0.5) dan weight decay 0.1 pada model sehat. Perbedaan kurva keduanya pun murni efek regularisasi.
"""Kurva learning: empat pola diagnosis pada loss latih dan validasi.

Empat konfigurasi dilatih pada dataset make_circles (320 sampel latih,
180 sampel validasi) dengan urutan batch dan bobot awal yang identik;
yang berbeda hanya arsitektur, regularisasi, dan learning rate:
  1. sehat     : MLP besar + Dropout 0.5 + weight decay 0.1
  2. underfit  : model linear tanpa hidden layer (kapasitas kurang)
  3. overfit   : MLP besar tanpa regularisasi (menghafal data latih)
  4. bergoyang : MLP kecil dengan learning rate 0.8 (terlalu besar)
Kurva loss keempat konfigurasi disimpan ke kurva_learning.png (panel 2x2).
"""

import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(42)

# ---------- 1. Data: dua lingkaran konsentris ----------
X, y = make_circles(n_samples=500, noise=0.22, factor=0.45, random_state=42)
X_latih, X_val, y_latih, y_val = train_test_split(
    X, y, test_size=0.36, random_state=42
)
rata2 = X_latih.mean(axis=0)
simpangan = X_latih.std(axis=0)
X_latih_t = torch.tensor((X_latih - rata2) / simpangan, dtype=torch.float32)
X_val_t = torch.tensor((X_val - rata2) / simpangan, dtype=torch.float32)
y_latih_t = torch.tensor(y_latih, dtype=torch.long)
y_val_t = torch.tensor(y_val, dtype=torch.long)
print("dataset: make_circles 500 sampel | 320 latih | 180 validasi | noise 0.22")
print("model sehat dan overfit memakai arsitektur yang sama persis;")
print("pembedanya hanya Dropout 0.5 dan weight decay 0.1.")

criterion = nn.CrossEntropyLoss()


# ---------- 2. Satu prosedur pelatihan untuk semua konfigurasi ----------
def latih(buat_model, lr, jumlah_epoch, weight_decay=0.0):
    torch.manual_seed(42)  # bobot awal seragam antar konfigurasi
    loader = DataLoader(
        TensorDataset(X_latih_t, y_latih_t),
        batch_size=64,
        shuffle=True,
        generator=torch.Generator().manual_seed(42),  # urutan batch seragam
    )
    model = buat_model()
    optimizer = torch.optim.AdamW(
        model.parameters(), lr=lr, weight_decay=weight_decay
    )
    loss_latih, loss_val = [], []
    for _ in range(jumlah_epoch):
        model.train()
        total, n = 0.0, 0
        for X_batch, y_batch in loader:
            optimizer.zero_grad()
            loss = criterion(model(X_batch), y_batch)
            loss.backward()
            optimizer.step()
            total += loss.item() * len(y_batch)
            n += len(y_batch)
        loss_latih.append(total / n)
        model.eval()
        with torch.no_grad():
            loss_val.append(criterion(model(X_val_t), y_val_t).item())
    return model, loss_latih, loss_val


def jumlah_parameter(model):
    return sum(p.numel() for p in model.parameters())


# ---------- 3. Empat konfigurasi ----------
def model_linear():
    return nn.Sequential(nn.Linear(2, 2))


def model_kecil():
    return nn.Sequential(nn.Linear(2, 16), nn.ReLU(), nn.Linear(16, 2))


def model_besar():
    return nn.Sequential(
        nn.Linear(2, 128),
        nn.ReLU(),
        nn.Linear(128, 128),
        nn.ReLU(),
        nn.Linear(128, 2),
    )


def model_besar_teratur():
    return nn.Sequential(
        nn.Linear(2, 128),
        nn.ReLU(),
        nn.Dropout(0.5),
        nn.Linear(128, 128),
        nn.ReLU(),
        nn.Dropout(0.5),
        nn.Linear(128, 2),
    )


konfigurasi = (
    ("sehat", model_besar_teratur, 0.005, 400, 0.1),
    ("underfit", model_linear, 0.01, 200, 0.0),
    ("overfit", model_besar, 0.005, 400, 0.0),
    ("bergoyang", model_kecil, 0.8, 150, 0.0),
)

riwayat = {}
for nama, buat, lr, epoch, wd in konfigurasi:
    model, tl, vl = latih(buat, lr, epoch, weight_decay=wd)
    riwayat[nama] = {"tl": tl, "vl": vl}
    print(f"model {nama:10s}: {jumlah_parameter(model):6d} parameter | "
          f"lr {lr:.3f} | wd {wd:.1f} | {epoch} epoch")

# ---------- 4. Ringkasan diagnosis ----------
print("\nmodel      | loss latih akhir | val terbaik | epochnya | val akhir | gap")
for nama, _, _, _, _ in konfigurasi:
    tl, vl = riwayat[nama]["tl"], riwayat[nama]["vl"]
    i_terbaik = vl.index(min(vl))
    print(f"{nama:10s} | {tl[-1]:16.4f} | {min(vl):11.4f} | {i_terbaik + 1:8d} | "
          f"{vl[-1]:9.4f} | {vl[-1] - tl[-1]:6.4f}")
print("underfit: loss ~0.693 = ln(2), loss tebakan acak pada 2 kelas.")

# getaran: rata-rata perubahan loss latih pada paruh kedua pelatihan
print("\ngetaran (rata-rata |delta loss latih| paruh kedua):")
for nama, _, _, _, _ in konfigurasi:
    tl = riwayat[nama]["tl"]
    paruh = tl[len(tl) // 2:]
    getaran = sum(abs(paruh[i + 1] - paruh[i]) for i in range(len(paruh) - 1))
    getaran /= max(len(paruh) - 1, 1)
    print(f"  {nama:10s}: {getaran:.4f}")

# ---------- 5. Detail model overfit: kurva val berbentuk U ----------
print("\nmodel overfit, loss per epoch terpilih:")
print("epoch | loss latih | loss val")
tl, vl = riwayat["overfit"]["tl"], riwayat["overfit"]["vl"]
for epoch in (10, 50, 100, 200, 400):
    print(f"{epoch:5d} | {tl[epoch - 1]:10.4f} | {vl[epoch - 1]:8.4f}")
print("loss validasi terendah dicapai di epoch",
      vl.index(min(vl)) + 1, "lalu menanjak terus")

# ---------- 6. Panel 2x2: empat pola ----------
judul = {
    "sehat": "Sehat: dua-duanya rendah, gap sempit",
    "underfit": "Underfit: dua-duanya tinggi",
    "overfit": "Overfit: gap melebar (gunting)",
    "bergoyang": "Lr terlalu besar: bergoyang",
}
fig, axes = plt.subplots(2, 2, figsize=(9.5, 6.5))
for ax, (nama, _, _, _, _) in zip(axes.flat, konfigurasi):
    tl, vl = riwayat[nama]["tl"], riwayat[nama]["vl"]
    epok = range(1, len(tl) + 1)
    ax.plot(epok, tl, label="loss latih", linewidth=1.2)
    ax.plot(epok, vl, label="loss validasi", linewidth=1.2)
    ax.set_title(judul[nama], fontsize=10)
    ax.set_xlabel("epoch")
    ax.set_ylabel("loss")
    ax.legend(fontsize=8)
fig.tight_layout()
fig.savefig("kurva_learning.png", dpi=110, bbox_inches="tight")
print("\nberkas kurva_learning.png berhasil dibuat")
Skrip di atas menghasilkan keluaran berikut saat dijalankan di mesin uji; kolom gap dan getaran pada tabel ringkasan memisahkan keempat pola.
Output yang Dihasilkan:
dataset: make_circles 500 sampel | 320 latih | 180 validasi | noise 0.22
model sehat dan overfit memakai arsitektur yang sama persis;
pembedanya hanya Dropout 0.5 dan weight decay 0.1.
model sehat     :  17154 parameter | lr 0.005 | wd 0.1 | 400 epoch
model underfit  :      6 parameter | lr 0.010 | wd 0.0 | 200 epoch
model overfit   :  17154 parameter | lr 0.005 | wd 0.0 | 400 epoch
model bergoyang :     82 parameter | lr 0.800 | wd 0.0 | 150 epoch

model      | loss latih akhir | val terbaik | epochnya | val akhir | gap
sehat      |           0.2593 |      0.2967 |        9 |    0.3269 | 0.0675
underfit   |           0.6932 |      0.6933 |      115 |    0.6941 | 0.0010
overfit    |           0.1338 |      0.2840 |        5 |    0.6731 | 0.5392
bergoyang  |           0.4228 |      0.3102 |       12 |    0.5168 | 0.0940
underfit: loss ~0.693 = ln(2), loss tebakan acak pada 2 kelas.

getaran (rata-rata |delta loss latih| paruh kedua):
  sehat     : 0.0125
  underfit  : 0.0002
  overfit   : 0.0073
  bergoyang : 0.0237

model overfit, loss per epoch terpilih:
epoch | loss latih | loss val
   10 |     0.2969 |   0.2952
   50 |     0.2710 |   0.3027
  100 |     0.2477 |   0.3229
  200 |     0.1844 |   0.4053
  400 |     0.1338 |   0.6731
loss validasi terendah dicapai di epoch 5 lalu menanjak terus

berkas kurva_learning.png berhasil dibuat
Mari kita telaah kode di atas baris per baris:
- Baris 26-38 (data):
make_circlesdenganrandom_state=42menghasilkan dua lingkaran konsentris; standardisasi memakai statistik data latih agar validasi tidak bocor. - Baris 44-55 (prosedur latih): seed 42 pada bobot awal dan urutan batch membuat keempat konfigurasi berangkat dari kondisi identik;
AdamWdenganweight_decay=0.0setara Adam. - Baris 57-71 (siklus epoch): loss latih dirata-rata per epoch;
model.eval()+torch.no_grad()menghitung loss validasi tanpa mengubah bobot — sekaligus mematikan Dropout. - Baris 87-106 (arsitektur besar):
model_besardanmodel_besar_teraturdibedakan hanya oleh dua layerDropout(0.5); keduanya tetap berjumlah 17.154 parameter karena Dropout tidak punya parameter. - Baris 109-114 (konfigurasi): sehat (weight decay 0,1), underfit (model linear), overfit (tanpa regularisasi), dan bergoyang (lr 0,8).
- Baris 123-130 (ringkasan): tiap konfigurasi dicatat loss akhir, loss validasi terbaik beserta epochnya, dan gap; ln(2) menjelaskan angka 0,693 pada underfit.
- Baris 132-148 (getaran dan kurva U): rata-rata perubahan mutlak loss latih pada paruh kedua mengubah kesan visual menjadi angka; tabel epoch terpilih memperlihatkan validasi overfit menanjak setelah epoch 5.
- Baris 150-169 (PNG): panel 2×2 menggambar kedua kurva keempat konfigurasi ke
kurva_learning.png.
Membaca Empat Pola #
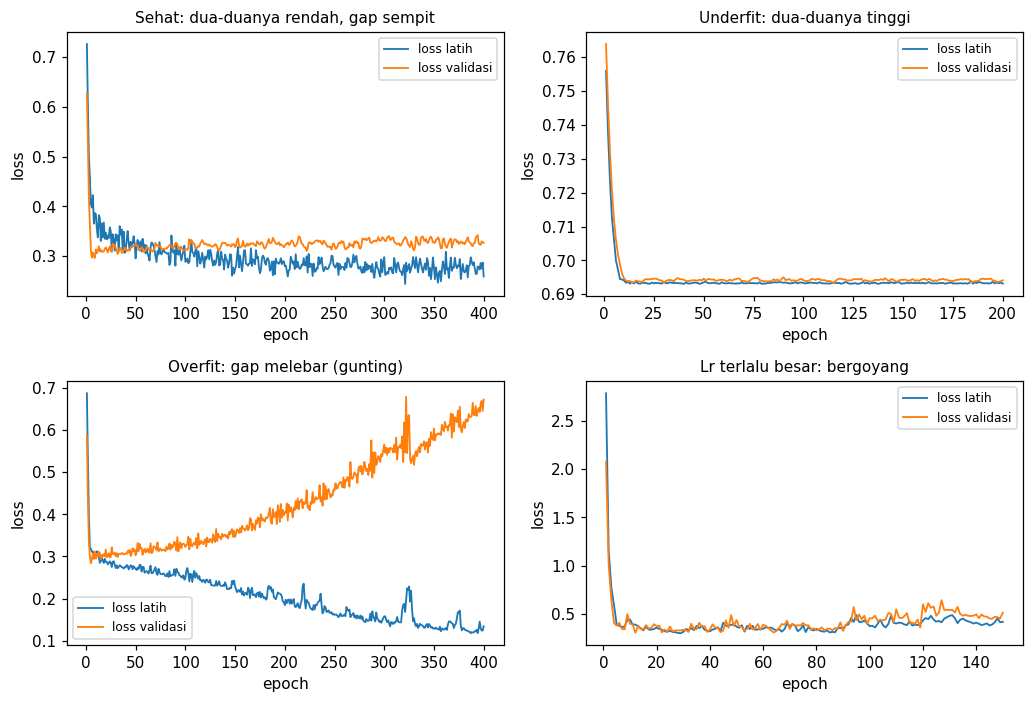
Panel kiri atas adalah pola sehat: kedua loss berakhir rendah (latih 0,259, validasi 0,327) dengan gap hanya 0,068. Panel kanan atas adalah pola underfit: kedua loss macet di 0,693 — persis ln(2), loss tebakan acak pada dua kelas — karena batas keputusan model linear berupa garis lurus tidak sanggup memisahkan dua lingkaran konsentris. Panel kiri bawah adalah pola overfit: loss latih terus turun ke 0,134 sementara loss validasi menyentuh titik terendah 0,284 di epoch 5 lalu menanjak ke 0,673 — bentuk gunting yang membuka, tanda model mulai menghafal. Panel kanan bawah adalah pola bergoyang akibat learning rate 0,8: getarannya 0,0237 — tertinggi dari semua konfigurasi, hampir dua kali lipat model sehat.
Alur membacanya dirangkum menjadi diagram berikut:
Diagram di atas mengubah tiga pertanyaan diagnosis menjadi jalur keputusan yang berujung pada satu nama pola. Tabel berikut melengkapinya dengan tindakan pertama yang lazim:
| Pola pada kurva | Diagnosis | Tindakan pertama |
|---|---|---|
| Kedua loss rendah, gap sempit | Generalisasi baik | Lanjutkan; kumpulkan data validasi lebih besar bila kurva masih menurun |
| Kedua loss tinggi, gap sempit | Underfit — kapasitas atau fitur kurang | Perbesar model, latih lebih lama, kurangi regularisasi |
| Loss latih turun, validasi menanjak | Overfit — model menghafal data latih | Dropout, weight decay, early stopping, data tambahan |
| Kedua kurva bergoyang di paruh akhir | Learning rate terlalu besar | Turunkan learning rate, perbesar batch, gradient clipping |
| Validasi melonjak tajam ke nilai sangat besar | Divergensi — masalah stabilitas | Periksa learning rate dan skala input; lanjut ke Debugging Gradient |
Dari Diagnosis ke Tindakan #
Setiap diagnosis pada tabel di atas sudah memiliki chapter obatnya. Overfitting diurai tuntas di Overfitting dan Underfitting , dengan tiga obat spesifik pada chapter Dropout , Weight Decay , dan Early Stopping . Eksperimen kita membuktikannya pada arsitektur yang sama persis: Dropout 0.5 dan weight decay 0.1 memangkas gap dari 0,539 menjadi 0,068. Pola bergoyang ditangani lewat pemilihan Learning Rate , sedangkan divergensi diperbedah lewat norm gradien pada chapter Debugging Gradient .
Riwayat loss per epoch juga layak disimpan sebagai log tiap eksperimen agar kurva dapat dibandingkan antar run — kebiasaan yang dibahas pada chapter Experiment Tracking . Kurva learning menjawab pertanyaan “kapan dan bagaimana model mulai keliru”. Pertanyaan berikutnya lebih tajam: pada sampel mana model keliru dan apa polanya — wilayah chapter Analisis Kesalahan .