Backpropagation mengalirkan gradien dari loss mundur ke layer paling awal melalui perkalian turunan berantai — dan perkalian itulah sumber dua penyakit klasik deep learning. Banyak faktor yang lebih kecil dari satu dikalikan berulang akan menuju nol: gradien yang tiba di layer awal menjadi begitu kecil sehingga layer tersebut nyaris tidak belajar (vanishing gradient). Sebaliknya, banyak faktor yang lebih besar dari satu akan bertumbuh pesat hingga satu langkah optimizer melempar bobot jauh dari wilayah baik (exploding gradient). Chapter ini membuktikan kedua fenomena itu dengan angka nyata pada CPU — jaringan 15 layer untuk kasus vanishing dan simulasi RNN untuk kasus exploding — lalu memetakan obat yang tersedia.
Kenapa Perkalian Berantai Bisa Gagal #
Aturan rantai pada Backpropagation
menyatakan bahwa gradien loss terhadap parameter layer ke-k adalah hasil kali turunan semua operasi di antara layer k dan loss. Turunan aktivasi menjadi faktor perkalian yang paling menentukan:
- Turunan sigmoid paling besar
0.25dan jauh lebih kecil saat saturasi, sehingga tiap layer sigmoid mengalikan gradien dengan faktor di bawah 0.25. Empat belas layer sigmoid menghasilkan faktor0.25¹⁴ ≈ 3.7e-9di skenario paling optimistis — itulah penyusutan yang akan kita ukur. - Turunan ReLU hanya bernilai
0atau1: unit yang aktif meneruskan gradien tanpa memperkecilnya, dan unit yang mati memblokirnya sepenuhnya. Pada jaringan yang sebagian besar unitnya aktif, gradien bertahan lintas kedalaman.
Kedalaman bukan satu-satunya sumber masalah. Pada RNN, turunan yang sama dikalikan lintas langkah waktu: gradien loss pada langkah ke-T terhadap state awal memuat produk Wᵀ berulang T kali. Ketika nilai eigen terbesar matriks bobot bermodulus di atas satu, produk itu bertumbuh eksponensial — pembahasan khususnya tersedia di chapter Vanishing Gradient pada RNN
.
Demonstrasi Teruji: 15 Layer Sigmoid vs ReLU #
Berkas vanishing_exploding.py membangun dua jaringan sama dalam — 15 layer Linear selebar 16 — dengan aktivasi berbeda. Jaringan sigmoid memakai inisialisasi bawaan; jaringan ReLU memakai inisialisasi Kaiming yang menjaga varians gradien antar layer. Program mencetak norm gradien weight tiap layer setelah satu backward pass, lalu mensimulasikan gradien RNN linear dengan jari-jari spektral 1.5 dan 0.5:
"""Vanishing vs exploding gradient dengan angka nyata.

Bagian A: jaringan 15 layer dengan sigmoid vs ReLU -> norm gradien
tiap kedalaman setelah satu backward pass (sigmoid menyusut geometris,
ReLU dengan inisialisasi Kaiming bertahan di kisaran serupa).
Bagian B: produk matriks berulang ala RNN -> norm gradien yang
membengkak ketika jari-jari spektral 1.5, dan menyusut ketika 0.5.
Bagian C: simpan plot PNG norm gradien per kedalaman (sumbu log).
"""

import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt  # noqa: E402
import torch  # noqa: E402
import torch.nn as nn  # noqa: E402

torch.manual_seed(42)

LEBAR = 16
KEDALAMAN = 15


def bangun_jaringan(aktivasi, kaiming=False):
    """15 layer Linear; aktivasi disisipkan di antara layer tersembunyi."""
    layers = [nn.Linear(2, LEBAR), aktivasi()]
    for _ in range(KEDALAMAN - 2):
        layers += [nn.Linear(LEBAR, LEBAR), aktivasi()]
    layers += [nn.Linear(LEBAR, 1)]
    model = nn.Sequential(*layers)
    if kaiming:
        for m in model:
            if isinstance(m, nn.Linear):
                nn.init.kaiming_normal_(
                    m.weight, mode="fan_out", nonlinearity="relu"
                )
                nn.init.zeros_(m.bias)
    return model


def norm_gradien_tiap_layer(model, x, target):
    """Forward + backward satu kali, kembalikan norm gradien weight per layer."""
    loss = ((model(x) - target) ** 2).mean()
    loss.backward()
    riwayat = []
    for m in model:
        if isinstance(m, nn.Linear):
            riwayat.append(m.weight.grad.norm().item())
    return riwayat


x = torch.randn(1, 2)
target = torch.tensor([[0.5]])

# ---------- A. vanishing: sigmoid vs ReLU + Kaiming ----------
net_sigmoid = bangun_jaringan(nn.Sigmoid)
norm_sigmoid = norm_gradien_tiap_layer(net_sigmoid, x, target)

net_relu = bangun_jaringan(nn.ReLU, kaiming=True)
norm_relu = norm_gradien_tiap_layer(net_relu, x, target)

print("== A. norm gradien per kedalaman (layer 1 = paling dekat input) ==")
print(f"{'layer':>5} {'sigmoid':>12} {'ReLU+Kaiming':>14}")
for i in range(KEDALAMAN):
    print(f"{i + 1:>5} {norm_sigmoid[i]:>12.3e} {norm_relu[i]:>14.3e}")
rasio_sigmoid = norm_sigmoid[0] / norm_sigmoid[-1]
rasio_relu = norm_relu[0] / norm_relu[-1]
print(f"rasio layer-1 / layer-15  sigmoid      : {rasio_sigmoid:.2e}")
print(f"rasio layer-1 / layer-15  ReLU+Kaiming : {rasio_relu:.3f}")

# ---------- B. exploding: produk matriks berulang ala RNN linear ----------
print("\n== B. gradien RNN linear: jari-jari spektral 1.5 vs 0.5 ==")
torch.manual_seed(7)
Q, _ = torch.linalg.qr(torch.randn(8, 8))     # matriks ortogonal
W_besar = 1.5 * Q                              # semua nilai eigen bermodulus 1.5
W_kecil = 0.5 * Q                              # semua nilai eigen bermodulus 0.5

g_besar = torch.ones(8)
g_kecil = torch.ones(8)
print(f"{'langkah':>8} {'rho=1.5':>13} {'rho=0.5':>13}")
for t in range(0, 31, 5):
    print(f"{t:>8} {g_besar.norm().item():>13.3e} "
          f"{g_kecil.norm().item():>13.3e}")
    for _ in range(5):
        g_besar = W_besar.T @ g_besar
        g_kecil = W_kecil.T @ g_kecil

# ---------- C. plot PNG gradien per kedalaman ----------
kedalaman = list(range(1, KEDALAMAN + 1))
fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(kedalaman, norm_sigmoid, "o-", label="sigmoid")
ax.plot(kedalaman, norm_relu, "s-", label="ReLU + Kaiming")
ax.set_yscale("log")
ax.set_xlabel("index layer (1 = paling dekat input)")
ax.set_ylabel("norm gradien weight")
ax.set_title("Norm gradien per kedalaman: 15 layer")
ax.legend()
ax.grid(True, which="both", alpha=0.3)
fig.savefig("gradien_per_kedalaman.png", dpi=110, bbox_inches="tight")
print("\nplot disimpan ke gradien_per_kedalaman.png")
Output yang Dihasilkan:
== A. norm gradien per kedalaman (layer 1 = paling dekat input) ==
layer      sigmoid   ReLU+Kaiming
    1    2.008e-13      3.074e-01
    2    9.725e-12      8.578e-01
    3    7.497e-11      6.724e-01
    4    4.858e-10      1.126e+00
    5    3.550e-09      1.530e+00
    6    2.213e-08      1.526e+00
    7    1.667e-07      1.398e+00
    8    1.462e-06      1.319e+00
    9    1.183e-05      1.360e+00
   10    8.685e-05      7.770e-01
   11    6.547e-04      5.436e-01
   12    9.854e-03      5.944e-01
   13    5.941e-02      4.529e-01
   14    3.984e-01      4.953e-01
   15    2.474e+00      1.138e-01
rasio layer-1 / layer-15  sigmoid      : 8.12e-14
rasio layer-1 / layer-15  ReLU+Kaiming : 2.702

== B. gradien RNN linear: jari-jari spektral 1.5 vs 0.5 ==
 langkah       rho=1.5       rho=0.5
       0     2.828e+00     2.828e+00
       5     2.148e+01     8.839e-02
      10     1.631e+02     2.762e-03
      15     1.239e+03     8.632e-05
      20     9.405e+03     2.697e-06
      25     7.142e+04     8.429e-08
      30     5.424e+05     2.634e-09

plot disimpan ke gradien_per_kedalaman.png
Mari kita telaah kode di atas baris per baris:
- Baris 24-38 (
bangun_jaringan): rakitan 15 layerLineardengan aktivasi yang bisa dipilih. Parameterkaiming=Truemenerapkannn.init.kaiming_normal_modefan_out— inisialisasi yang menjaga varians gradien pada jalur mundur — sekaligus meng-nol-kan bias. - Baris 41-49 (
norm_gradien_tiap_layer): satu forward dan satu backward pada satu sampel, lalu norm gradien weight setiapnn.Lineardikumpulkan berurutan dari layer terdekat input. - Baris 55-69 (bagian A): dua jaringan dibangun dan dibandingkan. Rasio norm layer-1 terhadap layer-15 dirangkum dua baris terakhir keluaran.
- Baris 71-86 (bagian B):
torch.linalg.qrmenghasilkan matriks ortogonalQyang deterministik dari seed 7. Skala 1.5 membuat semua nilai eigen bermodulus tepat 1.5, sehingga setiap perkalianWᵀmengalikan norm gradien dengan faktor tepat 1.5 — pembaca dapat memverifikasi2.828 × 1.5³⁰ ≈ 5.42e+05dengan kalkulator. - Baris 88-100 (bagian C): kedua riwayat norm digambar pada sumbu log lalu disimpan sebagai PNG di bundle.
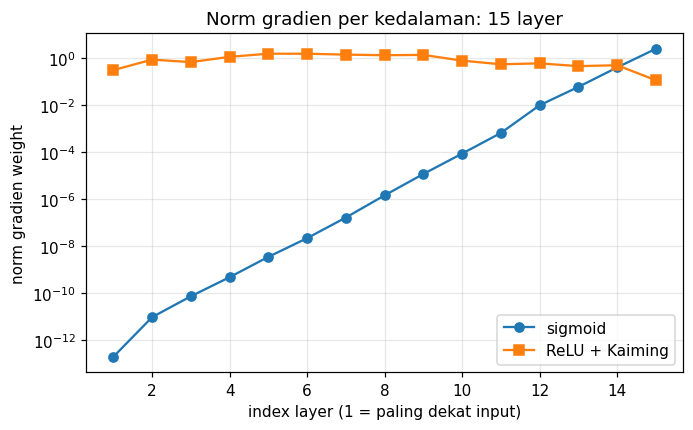
Membaca Angka: Dua Penyakit, Satu Mekanisme #
Pada jaringan sigmoid, norm gradien layer 1 hanya 2.008e-13 sedangkan layer 15 mencapai 2.474 — rasio 8.12e-14. Penyusutan terjadi konsisten sekitar faktor 5-10 per layer, persis perkalian turunan sigmoid yang rata-rata jauh di bawah 0.25. Learning rate berapa pun hampir tidak berpengaruh pada layer 1: gradien sekecil 1e-13 tidak akan menggeser bobot secara berarti. Pada jaringan ReLU + Kaiming, norm tiap layer berada di kisaran 0.11 sampai 1.53 dengan rasio hanya 2.702 — layer awal menerima sinyal yang setara dengan layer akhir.
Bagian B memperlihatkan sisi kebalikannya pada sekuens. Gradien yang dirambatkan mundur 30 langkah waktu pada jari-jari spektral 1.5 membengkak dari 2.83 menjadi 5.42e+05 — tumbuh tepat 1.5^t. Dalam float32, pertumbuhan berlanjut akan melampaui 3.4e+38 dan menghasilkan inf, lalu loss menjadi nan beberapa epoch kemudian. Kolom rho=0.5 menunjukkan bahwa jari-jari spektral di bawah satu justru menghasilkan vanishing — dua penyakit ini adalah dua sisi dari mata uang yang sama. RNN nyata menambahkan turunan tanh (maksimum 1) pada produk, sehingga kecenderungannya justru menyusut; pembahasan lengkapnya menunggu di section Sequence Modeling.
Obat untuk Vanishing dan Exploding #
| Obat | Menyasar | Cara kerja | Pembahasan lanjut |
|---|---|---|---|
| ReLU (dan varian GELU/LeakyReLU) | vanishing | turunan 0/1 tidak memperkecil gradien lintas layer | Fungsi Aktivasi |
| Inisialisasi Kaiming/Xavier | keduanya | menjaga varians forward dan backward tetap satu antar layer | Weight Initialization |
| Batch/Layer Normalization | vanishing | menstandarkan aktivasi tiap layer sehingga tidak bergeser ke wilayah saturasi | Batch Normalization |
| Residual connection | vanishing | jalur penjumlahan identitas memberi gradien jalan pintas melewati layer | Residual Network |
| Gradient clipping | exploding | memangkas norm gradien ke batas sebelum optimizer.step() | Gradient Clipping |
| LSTM / GRU | vanishing pada RNN | gerbang memilih informasi yang dipertahankan lintas langkah waktu | Long Short-Term Memory |
Dengan penyakit gradien dan obatnya terpetakan, satu pekerjaan tersisa sebelum hasil model bisa dipercaya: memastikan setiap perubahan yang kita coba benar-benar tercatat dan dapat dibandingkan. Chapter berikutnya, Experiment Tracking , mengatur eksperimen agar tidak lagi menjadi coba-coba tanpa jejak.