Metrik pada dua chapter sebelumnya merangkum seluruh prediksi menjadi satu angka — dan justru di titik itu informasi dibuang. Dua model dengan recall 0,771 bisa memiliki pola kesalahan yang sepenuhnya berbeda: satu tertukar antara kelas A dan B, satu lagi menyebar ke mana-mana. Confusion matrix mengembalikan informasi tersebut dalam bentuk tabel dua dimensi: baris menyimpan label aktual, kolom menyimpan label prediksi, dan setiap sel menghitung sampel yang jatuh ke kombinasi tersebut. Chapter ini memverifikasi konvensi pembacaan scikit-learn lewat contoh tangan, membedah satu kelas menjadi TP/FP/FN/TN, lalu menormalisasi tabel untuk menemukan kelas mana yang paling sering tertukar pada model tiga kategori harga rumah — semuanya pada eksperimen nyata yang dapat diulang di CPU.
Orientasi: Baris Aktual, Kolom Prediksi #
scikit-learn menempatkan label aktual pada baris dan prediksi pada kolom — kebalikan dari beberapa buku teks dan tabel di Wikipedia, sehingga kekeliruan membaca sumbu adalah galat klasik yang mengubah seluruh analisis. Konvensi ini bisa diverifikasi tanpa membaca dokumentasi: jumlah tiap baris pasti sama dengan banyaknya sampel aktual di kelas tersebut (support), karena setiap sampel pasti diprediksi ke salah satu kolom. Diagram berikut memetakan struktur binernya:
Dua jenis kesalahan pada diagram punya bobot praktis yang berbeda. FP adalah kesalahan Type I — alarm palsu: tenaga tim terbuang memeriksa kasus yang sebenarnya sehat. FN adalah kesalahan Type II — kasus terlewat: sinyal yang seharusnya ditindak berlalu begitu saja. Presisi menghukum FP, recall menghukum FN; pilihan metrik pada chapter pertama section ini kini terlihat akar struktur matematisnya. Pada matriks multikelas, sel [i, j] dibaca: sampel aktual kelas i yang diprediksi kelas j — diagonal adalah wilayah benar, dan luar diagonal adalah peta kesalahan yang akan kita tambang.
Eksperimen: Model Tiga Kategori Harga Rumah #
Berkas confusion_3kelas.py membuka dengan contoh tangan enam sampel untuk mengunci orientasi, lalu melatih logistic regression pada 900 sampel sintetis tiga kelas — kategori harga murah, menengah, mahal — dan membedah matriks hasilnya hingga heatmap:
"""Confusion matrix: cara membaca, membedah per kelas, dan normalisasi.

Bagian 1: contoh tangan 6 sampel untuk memverifikasi orientasi matriks
scikit-learn (baris = label aktual, kolom = prediksi).
Bagian 2: model 3 kelas prediksi kategori harga rumah -> matriks mentah,
ekstraksi TP/FP/FN/TN untuk satu kelas (satu-lawan-sisa), matriks
ternormalisasi per baris, pasangan kelas paling sering tertukar, dan
heatmap yang disimpan sebagai heatmap_confusion.png.
"""

import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
    accuracy_score,
    confusion_matrix,
    precision_score,
    recall_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

NAMA_KELAS = np.array(["murah", "menengah", "mahal"])

# ---------- 1. Contoh tangan: verifikasi orientasi ----------
y_benar = np.array([0, 0, 1, 1, 2, 2])
y_prediksi = np.array([0, 1, 1, 1, 2, 0])
cm_kecil = confusion_matrix(y_benar, y_prediksi)

print("== contoh tangan: 6 sampel, 3 kelas ==")
print(cm_kecil)
print("jumlah tiap baris = banyak sampel tiap kelas aktual:", cm_kecil.sum(axis=1))
print("jumlah tiap kolom = banyak prediksi tiap kelas     :", cm_kecil.sum(axis=0))
print("diagonal = prediksi benar:", int(np.trace(cm_kecil)), "dari", int(cm_kecil.sum()),
      "| akurasi", round(accuracy_score(y_benar, y_prediksi), 3))

# ---------- 2. Model 3 kelas: kategori harga rumah ----------
X, y = make_classification(
    n_samples=900,
    n_features=12,
    n_informative=8,
    n_redundant=2,
    n_classes=3,
    class_sep=1.2,
    random_state=42,
)
X_latih, X_uji, y_latih, y_uji = train_test_split(
    X, y, test_size=0.4, random_state=42, stratify=y
)
skala = StandardScaler().fit(X_latih)
model = LogisticRegression(max_iter=1000)
model.fit(skala.transform(X_latih), y_latih)
prediksi = model.predict(skala.transform(X_uji))
cm = confusion_matrix(y_uji, prediksi)

print("\n== matriks kebingungan 360 sampel uji (baris = aktual, kolom = prediksi) ==")
print("kolom ->  " + " ".join(f"{n:>9s}" for n in NAMA_KELAS))
for i, nama in enumerate(NAMA_KELAS):
    print(f"{nama:>9s} [" + " ".join(f"{int(v):4d}" for v in cm[i]) + "]  "
          f"(support {int(cm[i].sum())})")
print("akurasi keseluruhan:", round(accuracy_score(y_uji, prediksi), 3))

# ---------- 3. Satu kelas dibedah: TP/FP/FN/TN (satu-lawan-sisa) ----------
k = 1  # kelas "menengah"
TP = int(cm[k, k])
FP = int(cm[:, k].sum() - TP)
FN = int(cm[k, :].sum() - TP)
TN = int(cm.sum() - TP - FP - FN)
print(f"\n== kelas '{NAMA_KELAS[k]}' dibaca sebagai satu-lawan-sisa ==")
print(f"TP = {TP} (cm[1,1]) | FP = {FP} (kolom 1, baris lain) | "
      f"FN = {FN} (baris 1, kolom lain) | TN = {TN} (sisanya)")
print(f"presisi manual = TP/(TP+FP) = {TP}/{TP + FP} = {TP / (TP + FP):.3f}")
print(f"recall   manual = TP/(TP+FN) = {TP}/{TP + FN} = {TP / (TP + FN):.3f}")
print("presisi sklearn:", round(precision_score(y_uji == k, prediksi == k), 3))
print("recall   sklearn:", round(recall_score(y_uji == k, prediksi == k), 3))

# ---------- 4. Normalisasi per baris: recall tiap kelas ----------
cm_norm = cm / cm.sum(axis=1, keepdims=True)
print("\n== matriks ternormalisasi per baris (tiap baris berjumlah 1.00) ==")
print("kolom ->  " + " ".join(f"{n:>9s}" for n in NAMA_KELAS))
for i, nama in enumerate(NAMA_KELAS):
    print(f"{nama:>9s} [" + " ".join(f"{v:4.2f}" for v in cm_norm[i]) + "]")

# ---------- 5. Pasangan kelas paling sering tertukar ----------
pasangan = sorted(
    ((int(cm[i, j]), i, j) for i in range(3) for j in range(3) if i != j),
    reverse=True,
)
print("\n== pasangan tertukar teratas ==")
for jumlah, i, j in pasangan[:3]:
    print(f"aktual {NAMA_KELAS[i]:>9s} -> prediksi {NAMA_KELAS[j]:>9s} : "
          f"{jumlah} sampel")

# ---------- 6. Heatmap PNG ----------
fig, ax = plt.subplots(figsize=(4.6, 3.9))
im = ax.imshow(cm, cmap="Blues")
ax.set_xticks(range(3), NAMA_KELAS)
ax.set_yticks(range(3), NAMA_KELAS)
ax.set_xlabel("Prediksi")
ax.set_ylabel("Aktual")
for i in range(3):
    for j in range(3):
        warna = "white" if cm[i, j] > cm.max() * 0.6 else "black"
        ax.text(j, i, str(int(cm[i, j])), ha="center", va="center", color=warna)
fig.colorbar(im, ax=ax, label="banyak sampel")
fig.tight_layout()
fig.savefig("heatmap_confusion.png", dpi=110, bbox_inches="tight")
print("\nberkas heatmap_confusion.png berhasil dibuat")
Skrip di atas menghasilkan keluaran berikut saat dijalankan di mesin uji. Cocokkan baris demi baris pada matriks pertama dengan daftar y_benar dan y_prediksi sebelum lanjut.
Output yang Dihasilkan:
== contoh tangan: 6 sampel, 3 kelas ==
[[1 1 0]
 [0 2 0]
 [1 0 1]]
jumlah tiap baris = banyak sampel tiap kelas aktual: [2 2 2]
jumlah tiap kolom = banyak prediksi tiap kelas     : [2 3 1]
diagonal = prediksi benar: 4 dari 6 | akurasi 0.667

== matriks kebingungan 360 sampel uji (baris = aktual, kolom = prediksi) ==
kolom ->      murah  menengah     mahal
    murah [  79   26   17]  (support 122)
 menengah [  19   91    8]  (support 118)
    mahal [  23   11   86]  (support 120)
akurasi keseluruhan: 0.711

== kelas 'menengah' dibaca sebagai satu-lawan-sisa ==
TP = 91 (cm[1,1]) | FP = 37 (kolom 1, baris lain) | FN = 27 (baris 1, kolom lain) | TN = 205 (sisanya)
presisi manual = TP/(TP+FP) = 91/128 = 0.711
recall   manual = TP/(TP+FN) = 91/118 = 0.771
presisi sklearn: 0.711
recall   sklearn: 0.771

== matriks ternormalisasi per baris (tiap baris berjumlah 1.00) ==
kolom ->      murah  menengah     mahal
    murah [0.65 0.21 0.14]
 menengah [0.16 0.77 0.07]
    mahal [0.19 0.09 0.72]

== pasangan tertukar teratas ==
aktual     murah -> prediksi  menengah : 26 sampel
aktual     mahal -> prediksi     murah : 23 sampel
aktual  menengah -> prediksi     murah : 19 sampel

berkas heatmap_confusion.png berhasil dibuat
Mari kita telaah kode di atas baris per baris:
- Baris 27-29 (contoh tangan): enam sampel dengan dua sampel per kelas; prediksinya sengaja memuat dua kesalahan supaya struktur matriks terlihat jelas.
- Baris 32-39 (verifikasi orientasi): jumlah baris
[2, 2, 2]cocok dengan banyak sampel tiap kelas aktual, jumlah kolom[2, 3, 1]cocok dengan banyak prediksi tiap kelas, dan diagonal berjumlah 4 — akurasi 0,667 terhitung tanpa metrik tambahan. - Baris 42-58 (model tiga kelas):
class_sep=1.2membuat kelas saling bertumpuk cukup dekat sehingga kebingungan antar kelas nyata terjadi — prasyarat matriks yang menarik dianalisis. - Baris 60-66 (cetak matriks): tiap baris diawali nama kelas dan diakhiri support-nya agar pembacaan baris-aktual tidak bergeser ke kolom.
- Baris 69-80 (satu-lawan-sisa): empat angka TP/FP/FN/TN kelas menengah dihitung langsung dari sel matriks, lalu presisi dan recall manual dibandingkan dengan
precision_scoredanrecall_scorepada label yang dibinarisasi. - Baris 83-89 (normalisasi): setiap baris dibagi jumlah barisnya sendiri, sehingga nilai diagonal menjadi recall kelas tersebut.
- Baris 92-108 (pasangan tertukar dan PNG): sel luar diagonal diurutkan menurun untuk menemukan pasangan tertukar teratas, lalu
imshowmenggambar heatmap beranotasi yang disimpan sebagaiheatmap_confusion.png.
Satu Kelas Dibedah: Empat Kotak dari Matriks Multikelas #
Matriks 3×3 terlihat berbeda dari diagram biner, tetapi setiap kelas bisa dibaca sebagai masalah biner satu-lawan-sisa (one-vs-rest). Ambil kelas menengah: TP adalah sel diagonalnya cm[1,1] = 91; FP adalah sisa kolomnya 37 (murah dan mahal yang salah diprediksi menengah); FN adalah sisa barisnya 27 (menengah yang salah diprediksi kelas lain); TN adalah seluruh sel sisanya 205. Dari empat angka itu, presisi 91/128 = 0,711 dan recall 91/118 = 0,771 — keduanya cocok persis dengan keluaran sklearn pada label yang dibinarisasi. Seluruh metrik dari chapter Metrik Klasifikasi
pada dasarnya hanyalah transformasi dari tabel ini.
Normalisasi: Recall per Kelas dan Pasangan Tertukar #
Matriks mentah berskala banyak sampel, sehingga kelas dengan support besar otomatis punya angka besar di mana-mana. Matriks ternormalisasi per baris menyeragamkan tiap baris menjadi 1,00 — nilai diagonalnya langsung terbaca sebagai recall: murah 0,65, menengah 0,77, mahal 0,72. Kelas murah ternyata yang paling lemah: 21 persennya mengalir ke menengah dan 14 persen ke mahal.
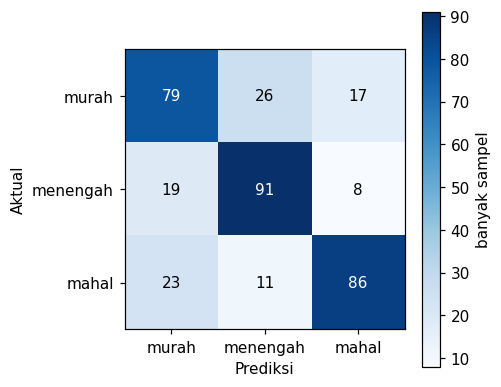
Pemeringkatan pasangan tertukar menutup analisis: murah → menengah dengan 26 sampel adalah sumber kesalahan terbesar, disusul mahal → murah dengan 23 sampel. Polanya masuk akal — kategori bertetangga (murah dan menengah) berbagi rentang fitur yang tumpang-tindih, sedangkan mahal → murah adalah kesalahan paling berisiko bisnis: rumah mahal yang ditawarkan murah. Temuan seperti inilah bahan masukan langsung bagi chapter Analisis Kesalahan .
Heatmap dan matriks ternormalisasi menunjukkan di mana model keliru pada satu titik waktu. Pertanyaan berikutnya bersifat dinamis: bagaimana kesalahan itu terbentuk sepanjang pelatihan, dan apakah model sedang membaik atau justru mulai menghafal? Chapter berikutnya, Kurva Learning , melatih kita membaca kurva loss latih-validasi sebagai sinyal diagnosis.