Kita telah membedah setiap komponen neural network satu per satu: neuron, layer, aktivasi, forward pass, loss, backpropagation, gradient descent, hingga computational graph. Chapter penutup section ini merangkai seluruh komponen menjadi satu program utuh — sebuah multilayer perceptron yang ditulis dari nol hanya dengan NumPy, tanpa framework deep learning apa pun. Program ini bukan sekadar ilustrasi: kelasnya menerima arsitektur berupa daftar ukuran layer berapa pun, backward pass-nya mengikuti aturan rantai yang telah diverifikasi, dan training-nya benar-benar konvergen hingga akurasi 0,970 pada dataset klasifikasi non-linear dalam waktu sekitar empat detik. Setelah menjalankannya, frasa “model belajar” tidak lagi kotak tertutup — seluruh mekanismenya tampak dalam satu berkas yang bisa dibaca dari atas ke bawah.
Seluruh Section dalam Satu Program #
Tabel berikut memetakan chapter-chapter sebelumnya ke bagian program yang menerapkannya:
| Konsep | Chapter | Peran di program |
|---|---|---|
| MLP dan arsitektur berlapis | Multilayer Perceptron | daftar ukuran layer [2, 8, 1] |
| Fungsi aktivasi ReLU dan sigmoid | Fungsi Aktivasi | pemilihan aktivasi di forward |
| Forward propagation | Forward Propagation | metode forward |
| Fungsi loss BCE | Loss Function | metode loss_bce |
| Backpropagation | Backpropagation | metode backward |
| Gradient descent | Gradient Descent | metode step dan training loop |
| Computational graph | Computational Graph | alur data dan gradien antar metode |
Alur training loop memanggil keempat metode secara bergiliran, persis siklus yang sejak section Pengenalan Deep Learning kita sebut sebagai empat langkah training:
Dataset dan Arsitektur #
Dataset uji adalah make_moons
dari scikit-learn: 200 titik dua fitur yang membentuk dua bulan sabit saling mengapit — pola yang mustahil dipisahkan garis lurus, sehingga kekuatan hidden layer benar-benar teruji. Arsitektur [2, 8, 1] berarti 2 input, 8 neuron hidden dengan ReLU, dan 1 output sigmoid; loss binary cross-entropy; training batch gradient descent dengan learning rate 0.5 selama 3000 epoch. Fitur distandardisasi lebih dulu karena gradient descent sensitif terhadap skala — kedua fitur make_moons punya rentang berbeda. Seluruh sumber ketidakpastian dikunci: random_state=42 untuk dataset, np.random.seed(42) untuk inisialisasi bobot, dan batch penuh untuk menghilangkan pengacakan pemilihan sampel.
Program Utuh #
Berkas mlp_numpy.py berisi kelas MLP lengkap, training loop, evaluasi, dan pembuatan grafik decision boundary:
"""MLP lengkap dari nol dengan NumPy: forward, backward, update, evaluasi.

Dataset make_moons dari scikit-learn (2 fitur, 2 kelas) dilatih dengan
multilayer perceptron: hidden layer ReLU + output sigmoid + binary
cross-entropy. Training loop menjalankan siklus forward -> loss ->
backward -> step pada seluruh data (batch gradient descent).
"""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import make_moons

np.random.seed(42)


class MLP:
    """Multilayer perceptron dengan hidden ReLU dan output sigmoid."""

    def __init__(self, ukuran_layer):
        """ukuran_layer misalnya [2, 8, 1]: 2 input, 8 neuron hidden, 1 output."""
        self.W = []
        self.b = []
        for masuk, keluar in zip(ukuran_layer[:-1], ukuran_layer[1:]):
            skala = np.sqrt(2.0 / masuk)      # inisialisasi He
            self.W.append(np.random.randn(masuk, keluar) * skala)
            self.b.append(np.zeros(keluar))

    def forward(self, X):
        """Kembalikan daftar aktivasi tiap layer; indeks 0 adalah input."""
        aktivasi = [X]
        for i in range(len(self.W)):
            z = aktivasi[-1] @ self.W[i] + self.b[i]
            if i < len(self.W) - 1:
                a = np.maximum(0.0, z)        # ReLU di hidden layer
            else:
                a = 1.0 / (1.0 + np.exp(-z))  # sigmoid di output
            aktivasi.append(a)
        return aktivasi

    def loss_bce(self, prob, y):
        """Binary cross-entropy dengan clipping epsilon."""
        eps = 1e-7
        prob = np.clip(prob, eps, 1.0 - eps)
        return -np.mean(y * np.log(prob) + (1.0 - y) * np.log(1.0 - prob))

    def backward(self, aktivasi, y):
        """Kembalikan gradien loss terhadap tiap W dan b (aturan rantai)."""
        n = y.shape[0]
        delta = (aktivasi[-1] - y) / n        # turunan BCE x sigmoid digabung
        grads_W, grads_b = [], []
        for i in reversed(range(len(self.W))):
            grads_W.insert(0, aktivasi[i].T @ delta)
            grads_b.insert(0, delta.sum(axis=0))
            if i > 0:
                delta = (delta @ self.W[i].T) * (aktivasi[i] > 0)
        return grads_W, grads_b

    def step(self, grads_W, grads_b, lr):
        """Gradient descent: geser parameter melawan arah gradien."""
        for i in range(len(self.W)):
            self.W[i] -= lr * grads_W[i]
            self.b[i] -= lr * grads_b[i]

    def predict(self, X):
        """Kelas prediksi: 1 bila probabilitas > 0.5, selain itu 0."""
        return (self.forward(X)[-1] > 0.5).astype(int)


# ---------- Dataset: make_moons, 2 fitur, 2 kelas ----------
X, y = make_moons(n_samples=200, noise=0.20, random_state=42)
y = y.reshape(-1, 1)

# Standardisasi fitur agar training stabil
rata2, simpangan = X.mean(axis=0), X.std(axis=0)
X = (X - rata2) / simpangan

# ---------- Training loop ----------
model = MLP([2, 8, 1])
lr = 0.5
jumlah_epoch = 3000

print("Dataset  : make_moons, 200 sampel, noise 0.20")
print("Arsitektur: [2, 8, 1]  |  loss: BCE  |  lr:", lr)
print()

for epoch in range(1, jumlah_epoch + 1):
    aktivasi = model.forward(X)
    loss = model.loss_bce(aktivasi[-1], y)
    if epoch in (1, 500, 1000, 1500, 2000, 2500, 3000):
        print(f"epoch {epoch:4d}  loss = {loss:.4f}")
    grads_W, grads_b = model.backward(aktivasi, y)
    model.step(grads_W, grads_b, lr)

akurasi = np.mean(model.predict(X) == y)
print(f"\nAkurasi akhir pada data latih: {akurasi:.3f}")

# ---------- Plot decision boundary ----------
rentang_x = np.linspace(X[:, 0].min() - 0.5, X[:, 0].max() + 0.5, 200)
rentang_y = np.linspace(X[:, 1].min() - 0.5, X[:, 1].max() + 0.5, 200)
xx, yy = np.meshgrid(rentang_x, rentang_y)
kisi = np.column_stack([xx.ravel(), yy.ravel()])
prob = model.forward(kisi)[-1].reshape(xx.shape)

plt.figure(figsize=(6, 5))
plt.contourf(xx, yy, prob, levels=20, cmap="RdBu", alpha=0.8)
plt.scatter(X[y.ravel() == 0, 0], X[y.ravel() == 0, 1],
            c="tab:blue", s=25, label="kelas 0")
plt.scatter(X[y.ravel() == 1, 0], X[y.ravel() == 1, 1],
            c="tab:red", s=25, label="kelas 1")
plt.xlabel("Fitur 1 (terstandardisasi)")
plt.ylabel("Fitur 2 (terstandardisasi)")
plt.title(f"Decision boundary MLP [2, 8, 1]  |  akurasi {akurasi:.3f}")
plt.legend(loc="upper right")
plt.savefig("decision_boundary.png", dpi=110, bbox_inches="tight")
print("Gambar decision boundary tersimpan: decision_boundary.png")
Output yang Dihasilkan:
Dataset  : make_moons, 200 sampel, noise 0.20
Arsitektur: [2, 8, 1]  |  loss: BCE  |  lr: 0.5

epoch    1  loss = 1.6689
epoch  500  loss = 0.1701
epoch 1000  loss = 0.0890
epoch 1500  loss = 0.0762
epoch 2000  loss = 0.0708
epoch 2500  loss = 0.0664
epoch 3000  loss = 0.0640

Akurasi akhir pada data latih: 0.970
Gambar decision boundary tersimpan: decision_boundary.png
Loss turun dari 1,67 menjadi 0,064 — penurunan 96 persen — dan akurasi mencapai 0,970 (194 dari 200 sampel benar). Mari kita bedah kelas intinya baris per baris:
- Baris 23-30 (
__init__): membangun parameter dari daftar ukuran layer.zip(ukuran_layer[:-1], ukuran_layer[1:])memasangkan layer berurutan (2→8, 8→1), sehingga arsitektur apa pun bekerja tanpa mengubah kode. Bobot diacak dengan skala Hesqrt(2/masuk)— inisialisasi standar untuk ReLU yang menjaga variansi aktivasi tetap stabil antar layer; bias cukup nol. - Baris 32-42 (
forward): satu perulangan untuk semua layer —z = a @ W + b, lalu ReLU untuk hidden layer dan sigmoid hanya di layer terakhir. Metode mengembalikan daftar seluruh aktivasi karena daftar itulah bahan baku backward pass. - Baris 44-48 (
loss_bce): rumus BCE dari chapter Loss Function — klip epsilon, kedua suku logaritma, rata-rata, balik tanda. - Baris 50-60 (
backward): inti backpropagation. Baris 53 memulai rantai dari output:delta = (a − y)/n. Perulanganreversedberjalan dari layer output mundur; gradien bobot layeriadalahaktivasi[i].T @ delta(aturan rantai + rata-rata lewat pembagiann), gradien bias penjumlahan delta, lalu delta diteruskan mundur: dikalikanW[i].Tdan diperhalus mask ReLU(aktivasi[i] > 0). - Baris 62-66 (
step): aturan gradient descentw ← w − lr × gradienuntuk seluruh parameter. - Baris 68-70 (
predict): probabilitas output dipotong di ambang 0.5 menjadi kelas 0/1. - Baris 73-79: dataset make_moons dibuat deterministik, label dibentuk kolom
(n, 1)agar cocok dengan output(n, 1), lalu fitur distandardisasi. - Baris 90-96 (training loop): empat langkah siklus dalam empat baris — forward, loss, backward, step; keluaran dicetak hanya pada epoch terpilih.
- Baris 101-119: decision boundary digambar dengan menilai probabilitas model pada kisi 200×200 titik via
model.forward, sehingga wilayah keputusan model terlihat sebagai latar berwarna di belakang data.
Membaca Hasil Training #
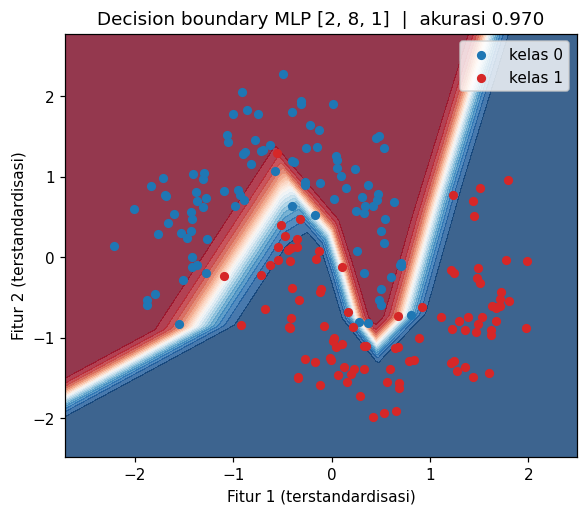
Grafik tersebut menampilkan jaringan 200 titik data di atas peta probabilitas model: wilayah biru adalah prediksi kelas 0, wilayah merah kelas 1, dengan transisi mulus di antara keduanya. Batas keputusan yang terbentuk melengkung mengikuti celah antara dua bulan sabit — bukti bahwa delapan neuron ReLU pada hidden layer berhasil melipat ruang input menjadi garis pemisah baru, persis peran hidden layer pada chapter Multilayer Perceptron. Kurva loss juga patut dibaca: penurunan tajam terjadi pada 500 epoch pertama (1,67 → 0,17), lalu melambat dan merapat di sekitar 0,06 — pola khas gradient descent yang mendekati lembah datar.
Keterbatasan dan Langkah Berikutnya #
Implementasi ini sengaja minimal agar setiap barisnya terbaca: batch penuh, tanpa optimizer lain, tanpa pembagian data latih-uji, tanpa regularisasi. Framework produksi menambahkan autograd agar backward tidak ditulis manual, mini-batch dan optimizer adaptif seperti Adam agar training lebih cepat, serta utilitas checkpoint dan device GPU. Seluruh tambahan itu dibangun di atas fondasi yang persis sama dengan program kita — tidak ada konsep baru yang belum dibahas pada section ini.
Kini fondasi lengkap. Section berikutnya, Tensor dan Komputasi , memperkenalkan struktur data yang menjadi bahasa kerja framework: tensor beserta operasi, broadcasting, dan komputasi gradien berskala besar — jembatan menuju PyTorch dan TensorFlow di section sesudahnya.