Backpropagation telah menghitung gradien loss terhadap setiap bobot, tetapi gradien itu belum dipakai untuk apa pun. Gradient descent adalah algoritma yang memakainya, dan aturan intinya hanya satu baris: parameter baru = parameter lama dikurangi learning rate dikali gradien. Kesederhanaan itu menipu, karena keberhasilan training sangat ditentukan oleh dua keputusan di dalamnya — seberapa besar langkah tiap pembaruan (learning rate) dan dari berapa banyak data gradien dihitung (ukuran batch). Pada chapter ini kita menjalankan gradient descent murni NumPy pada regresi linear, membedakan learning rate yang lambat, tepat, dan divergen, lalu memetakan varian batch, mini-batch, dan stochastic.
Aturan Pembaruan yang Sederhana #
Bayangkan kita berdiri di lereng pegunungan dalam kabut dan ingin turun ke lembah. Kita tidak bisa melihat lembahnya, tetapi bisa merasakan kemiringan tanah di bawah kaki: itulah gradien. Langkah paling masuk akal adalah melangkah ke arah berlawanan dari kemiringan paling curam — dan itulah seluruh isi gradient descent:
w ← w − lr × ∂L/∂w
Tanda negatif berarti kita melawan arah gradien, karena gradien menunjuk ke arah loss naik paling cepat sedangkan kita ingin loss turun. Learning rate lr mengatur panjang langkah. Terapkan aturan yang sama pada setiap parameter model secara serentak, ulangi ribuan kali, dan loss akan merosot menuju lembahnya.
Demo: Regresi Linear dengan Gradient Descent Murni #
Kita uji aturan tersebut pada masalah yang jawabannya sudah diketahui supaya konvergensinya terukur: delapan titik data yang mengikuti garis y = 3x + 2 persis. Model y = w·x + b dimulai dari parameter nol, dan gradient descent seharusnya menemukan w = 3, b = 2 tanpa diberi tahu. Berkas gd_regresi.py menjalankan 300 iterasi:
"""Melatih regresi linear y = w*x + b dengan gradient descent batch murni.

Data delapan titik mengikuti pola persis y = 3x + 2. Training dimulai
dari parameter nol; loss harus turun secara monoton menuju nol dan
parameter harus merapat ke w = 3, b = 2.
"""

import numpy as np

x = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 2.5, 3.0, 3.5])
y = 3.0 * x + 2.0

w, b = 0.0, 0.0        # parameter awal: model menebak garis datar
lr = 0.1               # learning rate

print("Target sebenarnya : w = 3, b = 2")
print(f"Kondisi awal      : w = {w:.4f}, b = {b:.4f}")
print()

sejarah_loss = []
for iterasi in range(1, 301):
    # Forward pass: prediksi dan loss dengan parameter saat ini
    prediksi = w * x + b
    galat = prediksi - y
    loss = np.mean(galat**2)
    sejarah_loss.append(loss)

    # Backward pass: gradien MSE terhadap w dan b
    grad_w = 2.0 * np.mean(galat * x)
    grad_b = 2.0 * np.mean(galat)

    # Pembaruan parameter: melawan arah gradien
    w -= lr * grad_w
    b -= lr * grad_b

    if iterasi in (1, 5, 20, 50, 100, 300):
        print(f"iterasi {iterasi:3d}  w={w:7.4f}  b={b:7.4f}  loss={loss:.6f}")

turun_monoton = all(
    sejarah_loss[i + 1] <= sejarah_loss[i]
    for i in range(len(sejarah_loss) - 1)
)
print(f"\nLoss turun monoton sepanjang 300 iterasi : {turun_monoton}")
print(f"Parameter akhir                          : w = {w:.4f}, b = {b:.4f}")
Output yang Dihasilkan:
Target sebenarnya : w = 3, b = 2
Kondisi awal      : w = 0.0000, b = 0.0000

iterasi   1  w= 3.3250  b= 1.4500  loss=64.375000
iterasi   5  w= 3.2006  b= 1.5278  loss=0.074986
iterasi  20  w= 3.0911  b= 1.7856  loss=0.015455
iterasi  50  w= 3.0188  b= 1.9558  loss=0.000657
iterasi 100  w= 3.0014  b= 1.9968  loss=0.000003
iterasi 300  w= 3.0000  b= 2.0000  loss=0.000000

Loss turun monoton sepanjang 300 iterasi : True
Parameter akhir                          : w = 3.0000, b = 2.0000
Jalur konvergensinya instruktif untuk dibaca. Iterasi pertama melompat jauh — gradien awal besar sehingga w melampaui 3 hingga 3,325 — lalu melangkah mundur dan merapat mulus: 3,2006 → 3,0911 → 3,0188 → 3,0000. Nilai loss pada tiap baris adalah loss sebelum pembaruan iterasi tersebut, sehingga baris pertama menampilkan kondisi awal (64,375). Cek turun_monoton memastikan tidak ada satu pun iterasi yang menaikkan loss. Mari kita telaah kodenya baris per baris:
- Baris 10-11: data latih delapan titik dengan pola persis
y = 3x + 2, sehingga solusi optimal diketahui dan keberhasilan konvergensi dapat dibuktikan. - Baris 13-14: parameter awal nol dan learning rate 0.1 — nilai yang stabil untuk masalah ini.
- Baris 20-26: forward pass — prediksi delapan titik sekaligus berkat operasi vektor, galat, dan MSE; nilai loss dicatat ke
sejarah_lossuntuk pemeriksaan monotonicitas. - Baris 29-30: backward pass — dua rumus gradien MSE yang berasal dari chapter Backpropagation .
- Baris 33-34: aturan pembaruan gradient descent, diterapkan pada kedua parameter serentak.
- Baris 36-37: mencetak kondisi model hanya pada iterasi terpilih agar keluaran tetap ringkas.
- Baris 39-44: memverifikasi loss tidak pernah naik sepanjang 300 iterasi, lalu mencetak parameter akhir yang merapat tepat ke
w = 3, b = 2.
Pengaruh Learning Rate #
Learning rate adalah tuas paling berpengaruh pada gradient descent. Tabel berikut merangkum empat kondisi yang mungkin terjadi:
| Kondisi learning rate | Perilaku loss | Akibat pada training |
|---|---|---|
| Terlalu kecil | turun sangat lambat | butuh epoch sangat banyak, biaya komputasi tinggi |
| Tepat | turun cepat dan stabil | konvergen mulus ke lembah loss |
| Sedikit terlalu besar | berayun naik-turun | konvergen lambat atau berhenti di titik yang belum optimal |
| Terlalu besar | meningkat makin cepat | divergen; bobot membesar tak terkendali hingga overflow |
Berkas learning_rate_banding.py mengukur tiga kondisi tersebut pada masalah yang sama, lalu menyimpan grafik ketiga kurva loss ke dalam berkas konvergensi.png:
"""Membandingkan tiga learning rate pada regresi linear yang sama.

Learning rate yang terlalu kecil membuat loss turun sangat lambat,
yang tepat membuat loss turun cepat dan stabil, dan yang terlalu
besar membuat loss meningkat cepat (divergen). Grafik ketiga kurva
loss disimpan sebagai konvergensi.png.
"""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt
import numpy as np

x = np.array([0.0, 0.5, 1.0, 1.5, 2.0, 2.5, 3.0, 3.5])
y = 3.0 * x + 2.0


def latih(lr, jumlah_iterasi):
    """Jalankan gradient descent dan kembalikan riwayat loss."""
    w, b = 0.0, 0.0
    sejarah = []
    for _ in range(jumlah_iterasi):
        galat = w * x + b - y
        sejarah.append(np.mean(galat**2))
        w -= lr * 2.0 * np.mean(galat * x)
        b -= lr * 2.0 * np.mean(galat)
    return sejarah


pengaturan = [
    ("terlalu kecil (0.001)", 0.001),
    ("tepat (0.1)", 0.1),
    ("terlalu besar (0.9)", 0.9),
]

plt.figure(figsize=(7, 4.5))
for label, lr in pengaturan:
    sejarah = latih(lr, 50)
    plt.plot(range(1, 51), sejarah, label=label)
    print(f"lr = {lr:<6}  loss awal = {sejarah[0]:9.4f}  "
          f"loss akhir = {sejarah[-1]:.4e}")

plt.yscale("log")
plt.xlabel("Iterasi")
plt.ylabel("Loss (skala log)")
plt.title("Pengaruh learning rate pada laju penurunan loss")
plt.legend()
plt.grid(True, which="both", alpha=0.3)
plt.savefig("konvergensi.png", dpi=110, bbox_inches="tight")
print("\nGrafik konvergensi tersimpan: konvergensi.png")
Output yang Dihasilkan:
lr = 0.001   loss awal =   64.3750  loss akhir = 2.3551e+01
lr = 0.1     loss awal =   64.3750  loss akhir = 6.5653e-04
lr = 0.9     loss awal =   64.3750  loss akhir = 2.7005e+91

Grafik konvergensi tersimpan: konvergensi.png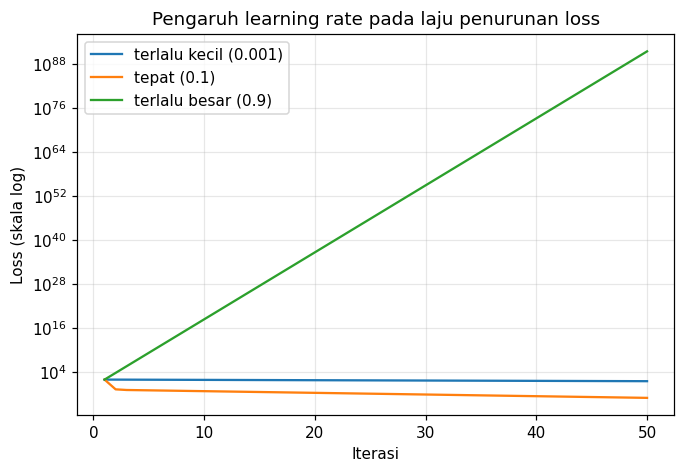
Ketiga kurva berangkat dari titik yang sama (loss 64,375) lalu berpisah drastis dalam 50 iterasi. Learning rate 0.001 nyaris diam — loss hanya turun ke 23,55 karena langkahnya terlalu pendek. Learning rate 0.1 mencapai 6,57 × 10⁻⁴ dan akan terus merosot. Learning rate 0.9 justru menanjak hingga 2,70 × 10⁹¹: langkahnya melewati lembah ke sisi seberang, gradien di sana mengarah balik dengan kemiringan lebih curam, pembaruan berikutnya melompat lebih jauh lagi — bobot berayun kiri-kanan dengan amplitudo yang membesar. Sumbu-y grafik memakai skala logaritmik agar tiga kurva yang terpisah 90 orde magnitudo tetap terbaca dalam satu gambar. Mari kita telaah kodenya baris per baris:
- Baris 9-11: memilih backend
Aggsebelum mengimpor pyplot — matplotlib mode non-interaktif untuk menyimpan grafik ke berkas tanpa membuka jendela tampilan. - Baris 20-29: fungsi
latihmerangkum satu sesi gradient descent penuh dan mengembalikan riwayat loss per iterasi, sehingga tiga pengaturan bisa dijalankan dari fungsi yang sama. - Baris 32-36: tiga pengaturan learning rate dengan label deskriptif untuk grafik.
- Baris 38-43: menjalankan 50 iterasi untuk tiap learning rate, menggambar kurvanya, dan mencetak loss awal serta akhir.
- Baris 45: mengaktifkan skala logaritmik pada sumbu-y dengan
plt.yscale("log"). - Baris 51: menyimpan grafik ke berkas
konvergensi.pngdalam bundle chapter dengandpi=110danbbox_inches="tight".
Varian: Batch, Mini-Batch, dan Stochastic #
Demo di atas menghitung gradien dari seluruh data latih pada setiap pembaruan — itulah batch gradient descent. Pada dataset besar, menunggu seluruh data untuk satu langkah menjadi mahal, dan ketiganya punya trade-off:
| Varian | Gradien dihitung dari | Pembaruan per epoch | Perilaku loss |
|---|---|---|---|
| Batch | seluruh data | 1 | halus, turun monoton |
| Mini-batch (8-256 sampel) | sebagian data | n/batch_size | berayun kecil di sekitar tren turun |
| Stochastic (SGD) | satu sampel | n | bergelombang tajam, tren tetap turun |
Mini-batch menjadi standar deep learning karena dua alasan: gradien dari 32-256 sampel sudah mewakili arah umum dengan biaya komputasi jauh lebih rendah, dan bentuk paralel GPU paling efisien pada ukuran batch tetap. Getaran (noise) pada gradien mini-batch bahkan membantu training keluar dari titik datar (saddle point) yang menghentikan batch murni. Praktiknya, framework seperti scikit-learn SGDRegressor dan optimizer di Keras memakai varian mini-batch secara bawaan.
Dari loss turun monoton hingga tiga kurva yang berpisah, kita kini memegang gambaran lengkap siklus belajar pada parameter level kecil. Persoalan berikutnya struktural: network sesungguhnya adalah rangkaian operasi bertingkat — bagaimana mengorganisasi perkalian, penjumlahan, dan aktivasi itu agar forward maupun backward dapat dijalankan otomatis dan benar untuk bentuk network apa pun? Jawabannya adalah computational graph, topik chapter berikutnya.