Fungsi step yang kita pakai sejauh ini berhasil memutuskan aktif atau tidaknya sebuah neuron, tetapi ia punya cacat fatal untuk pelatihan: turunannya bernilai nol di semua titik sehingga tidak memberi arah perbaikan apa pun saat bobot salah. Deep learning modern menggantinya dengan keluarga fungsi aktivasi yang mulus dan kaya perilaku — dari sigmoid yang melengkung lembut hingga ReLU yang sederhana namun menjadi standar industri. Pada chapter ini kita implementasikan enam fungsi aktivasi dengan NumPy murni, membandingkan keluarannya pada vektor yang sama, menggambar kurvanya, lalu menyusun panduan memilih fungsi yang tepat untuk hidden layer maupun output layer.
Peran Fungsi Aktivasi #
Fungsi aktivasi membawa dua sifat yang tidak dimiliki transformasi affine z = W·x + b. Pertama, non-linearitas. Tanpa fungsi aktivasi, dua layer berurutan hanya menghasilkan transformasi linear baru: karena perkalian matriks asosiatif, (X @ W1) @ W2 = X @ (W1 @ W2). Menumpuk seribu layer affine setara dengan satu layer affine — jaringan kehilangan seluruh kemampuannya membentuk batas keputusan yang melengkung, termasuk kemampuan menyelesaikan XOR pada chapter sebelumnya.
Kedua, kemulusan untuk pembelajaran. Algoritma pelatihan seperti backpropagation memakai turunan untuk mengukur pengaruh tiap bobot terhadap loss — materi chapter Kalkulus untuk Deep Learning . Fungsi step memiliki turunan nol di semua titik dan tak terdefinisi tepat di titik lompatan, sehingga sinyal perbaikan tidak pernah mengalir. Fungsi mulus seperti sigmoid dan ReLU menyediakan turunan yang bermakna hampir di semua wilayah input.
Enam Fungsi Aktivasi #
Tabel berikut merangkum keenam fungsi yang akan kita implementasikan:
| Fungsi | Rumus | Rentang | Kegunaan umum |
|---|---|---|---|
| Step | 1 jika z >= 0, selainnya 0 | {0, 1} | Sejarah; model McCulloch-Pitts dan perceptron |
| Sigmoid | 1 / (1 + e^-z) | (0, 1) | Output binary classification; komponen gerbang pada arsitektur berulang |
| Tanh | tanh(z) | (-1, 1) | Hidden layer; keluaran berpusat di nol |
| ReLU | max(0, z) | [0, ∞) | Hidden layer; standar default jaringan modern |
| Leaky ReLU | max(α·z, z) | (-∞, ∞) | Alternatif ReLU untuk menghindari dying ReLU |
| Softmax | e^zj / Σk e^zk | (0, 1), jumlah = 1 | Output multi-class classification |
Lima fungsi pertama bekerja elemen per elemen: satu nilai z masuk, satu nilai keluar. Softmax berbeda — ia memproses seluruh vektor sekaligus dan mengubahnya menjadi distribusi probabilitas yang jumlahnya tepat satu, sehingga hanya relevan di output layer pengklasifikasi.
Implementasi dengan NumPy #
Berkas fungsi_aktivasi.py mendefinisikan keenam fungsi sebagai fungsi Python murni di atas operasi NumPy, mengujinya pada vektor z = [-4, -1, 0, 2, 5], lalu menyimpan kurva masing-masing ke berkas aktivasi.png:
"""Implementasi enam fungsi aktivasi dengan NumPy murni.

Step, sigmoid, tanh, ReLU, dan Leaky ReLU diuji elemen per elemen pada
satu vektor z. Softmax mengubah seluruh vektor menjadi distribusi
probabilitas. Skrip juga menyimpan kurva tiap fungsi ke aktivasi.png.
"""

import matplotlib

matplotlib.use("Agg")

import matplotlib.pyplot as plt
import numpy as np


def step(z):
    """Step: 1 bila z >= 0, selain itu 0."""
    return (z >= 0.0).astype(float)


def sigmoid(z):
    """Sigmoid: memetakan nilai z ke rentang (0, 1)."""
    return 1.0 / (1.0 + np.exp(-z))


def tanh(z):
    """Tanh: memetakan nilai z ke rentang (-1, 1)."""
    return np.tanh(z)


def relu(z):
    """ReLU: nilai negatif dipotong menjadi nol."""
    return np.maximum(0.0, z)


def leaky_relu(z, alpha=0.1):
    """Leaky ReLU: nilai negatif dikalikan alpha agar tetap ada sinyal."""
    return np.where(z >= 0.0, z, alpha * z)


def softmax(z):
    """Softmax: seluruh vektor menjadi distribusi probabilitas."""
    e = np.exp(z - np.max(z))
    return e / e.sum()


z = np.array([-4.0, -1.0, 0.0, 2.0, 5.0])

print("Perbandingan fungsi aktivasi pada vektor z =", z)
print()
print(f"{'z':>6} {'step':>6} {'sigmoid':>8} {'tanh':>8} {'relu':>6} {'leaky':>7}")
for i in range(len(z)):
    print(f"{z[i]:6.1f} {step(z[i]):6.0f} {sigmoid(z[i]):8.4f}"
          f" {tanh(z[i]):8.4f} {relu(z[i]):6.1f} {leaky_relu(z[i]):7.2f}")

p = softmax(z)
print()
print("softmax(z) :", " ".join(f"{v:7.4f}" for v in p))
print("jumlah     :", round(p.sum(), 6))

# Bagian grafik: kurva tiap fungsi + softmax sebagai diagram batang
xs = np.linspace(-6.0, 6.0, 601)
fig, axes = plt.subplots(2, 3, figsize=(12, 6), constrained_layout=True)

axes[0, 0].plot(xs, step(xs))
axes[0, 0].set_title("Step")
axes[0, 1].plot(xs, sigmoid(xs))
axes[0, 1].set_title("Sigmoid")
axes[0, 2].plot(xs, tanh(xs))
axes[0, 2].set_title("Tanh")
axes[1, 0].plot(xs, relu(xs))
axes[1, 0].set_title("ReLU")
axes[1, 1].plot(xs, leaky_relu(xs))
axes[1, 1].set_title("Leaky ReLU (alpha=0.1)")

logits = np.array([2.0, 1.0, 0.1, -1.0])
axes[1, 2].bar(range(len(logits)), softmax(logits))
axes[1, 2].set_title("Softmax (4 kelas)")
axes[1, 2].set_xticks(range(len(logits)))

for ax in axes.flat:
    ax.axhline(0.0, color="gray", linewidth=0.6)
    ax.axvline(0.0, color="gray", linewidth=0.6)
    ax.set_xlabel("z")
    ax.set_ylabel("f(z)")

axes[1, 2].set_xlabel("indeks kelas")
axes[1, 2].set_ylabel("probabilitas")

fig.savefig("aktivasi.png", dpi=110)
print("Grafik disimpan ke aktivasi.png")
Output yang Dihasilkan:
Perbandingan fungsi aktivasi pada vektor z = [-4. -1.  0.  2.  5.]

     z   step  sigmoid     tanh   relu   leaky
  -4.0      0   0.0180  -0.9993    0.0   -0.40
  -1.0      0   0.2689  -0.7616    0.0   -0.10
   0.0      1   0.5000   0.0000    0.0    0.00
   2.0      1   0.8808   0.9640    2.0    2.00
   5.0      1   0.9933   0.9999    5.0    5.00

softmax(z) :  0.0001  0.0023  0.0064  0.0470  0.9442
jumlah     : 1.0
Grafik disimpan ke aktivasi.png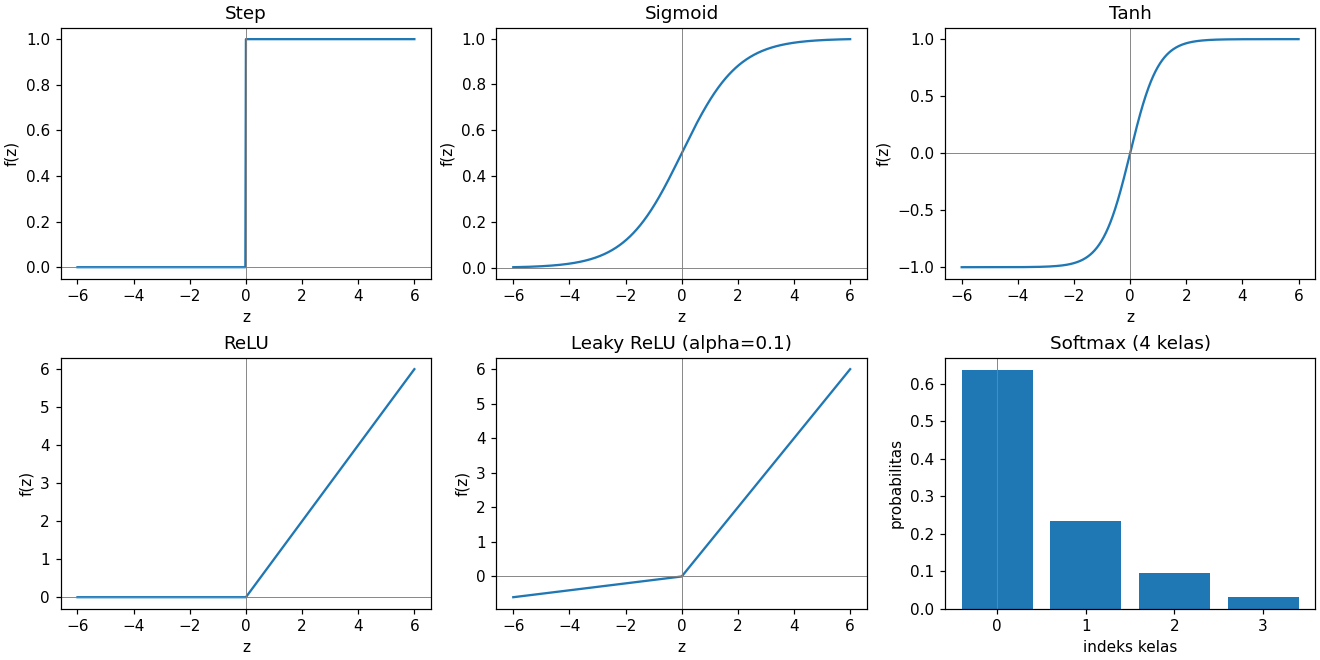
Beberapa perilaku menonjol dari tabel dan kurva di atas. Sigmoid dan tanh sama-sama menjepit nilai ekstrem: pada z = -4 keduanya sudah menempel di batas bawah rentangnya (0,0180 dan −0,9993), sementara di z = 5 keduanya menempel di batas atas. ReLU membiarkan nilai positif lewat tanpa diubah dan memotong seluruh nilai negatif menjadi nol; Leaky ReLU melakukan hal yang sama tetapi menyisakan bocoran kecil -0.4 dan -0.1 di wilayah negatif. Softmax mengubah kelima nilai menjadi probabilitas dengan z = 5 menguasai 94,42 persen — nilai terbesar ditonjolkan, nilai kecil ditekan, dan jumlahnya tepat satu. Mari kita telaah kode di atas baris per baris:
- Baris 8-13 (impor):
matplotlib.use("Agg")dipanggil sebelumpyplotagar grafik tersimpan ke berkas tanpa perlu tampilan layar; NumPy menyusul setelahnya. - Baris 16-18 (
step): perbandinganz >= 0.0menghasilkan array boolean yang dikonversiastype(float)menjadi0.0/1.0. - Baris 21-23 (
sigmoid): terjemahan langsung rumus1 / (1 + e^-z)dengannumpy.expyang bekerja elemen per elemen. - Baris 26-33 (
tanh,relu):np.tanhadalah implementasi bawaan; ReLU cukup satu panggilannp.maximum(0.0, z)yang memilih nilai terbesar antara nol danz. - Baris 36-38 (
leaky_relu):numpy.wherememilih cabang per elemen —zuntuk wilayah non-negatif,alpha * zuntuk wilayah negatif. - Baris 41-44 (
softmax): pengurangannp.max(z)sebelumnp.expmenjaga angka tetap kecil secara numerik — hasilnya tidak berubah karena pembilang dan penyebut terbagi konstanta yang sama. - Baris 47-59 (tabel keluaran): satu loop mencetak kelima fungsi elementwise dalam kolom yang sejajar, lalu softmax dicetak terpisah bersama jumlahnya sebagai bukti distribusi.
- Baris 61-91 (grafik):
np.linspacemenyiapkan 601 titik dari −6 sampai 6,plt.subplots(2, 3)menata enam panel, danfig.savefig("aktivasi.png", dpi=110)menuliskan hasilnya ke berkas di dalam bundle chapter ini.
Masalah Dying ReLU #
ReLU punya kelemahan yang khas: neuron yang menerima z negatif terus-menerus akan selalu mengeluarkan nol. Karena turunan ReLU di wilayah negatif juga nol, gradient yang mengalir balik ke bobot neuron tersebut selalu nol — bobotnya berhenti diperbarui selamanya meski training berlanjut. Kondisi ini disebut dying ReLU. Jaringan yang besar persentasenya neuron berhenti bereaksi kehilangan kapasitas representasi secara diam-diam; loss berhenti turun tanpa pesan galat. Penyebabnya biasanya inisialisasi bobot yang buruk atau learning rate yang terlalu besar. Leaky ReLU mengatasinya dengan menyisakan gradien kecil α di wilayah negatif — bocoran -0.4 dan -0.1 pada tabel kita itulah jalur hidupnya.
Memilih Fungsi Aktivasi #
Pilihan fungsi berbeda antara hidden layer dan output layer. Untuk hidden layer, ReLU adalah titik awal terbaik: murah dihitung, tidak menjepit nilai positif, dan terbukti stabil pada jaringan dalam. Tanh layak dipertimbangkan bila keluaran berpusat di nol membantu (misalnya arsitektur berulang), dan Leaky ReLU bila gejala dying ReLU muncul. Untuk output layer, pilihan ditentukan tugasnya:
| Tugas output | Fungsi | Alasan |
|---|---|---|
| Regresi (nilai bebas) | Linear (tanpa aktivasi) | Nilai target tidak terikat rentang |
| Binary classification | Sigmoid | Keluaran probabilitas satu kelas |
| Multi-class classification | Softmax | Distribusi probabilitas antar kelas |
Kita kini punya seluruh komponen individual: neuron, bobot, bias, dan fungsi aktivasi. Chapter berikutnya merakitnya menjadi alur lengkap forward propagation — data batch mengalir dari layer ke layer hingga menjadi prediksi — dengan implementasi dua layer NumPy yang bentuk matriksnya kita periksa di setiap tahap.