Setelah melepas rekurensi, Transformer memproses seluruh token sekaligus — dan justru itulah masalah barunya: operasi paralel tidak mengenal urutan. Kalimat ikan makan dan makan ikan menghasilkan matriks X yang sama persis, karena attention hanya membaca isi token tanpa peduli posisinya. RNN mendapatkan urutan secara gratis dari rantai waktunya; Transformer harus menyuntikkannya sendiri. Solusi makalah asli adalah positional encoding: vektor sinus-kosinus yang khas untuk tiap posisi, dijumlahkan langsung ke embedding sebelum masuk lapisan pertama. Chapter ini menghitung polanya untuk d_model = 8, membuktikan properti rotasinya dengan angka, lalu melihat keseluruhan pola pada heatmap.
Paralel tapi Butuh Urutan #
Suntikan posisi dilakukan lewat penjumlahan, bukan penempelannya: z_t = x_t + PE_t. Keduanya berukuran sama d_model, sehingga arsitektur tidak berubah satu bit — lapisan attention berikutnya menerima tensor berukuran persis seperti sebelumnya. Posisi menjadi bagian dari isi token itu sendiri.
Diagram di atas menunjukkan satu-satunya titik tempat informasi posisi masuk: sebelum lapisan pertama. Setiap lapisan Transformer berikutnya bekerja pada representasi yang sudah membawa sinyal posisi tersebut.
Rumus Sinus dan Kosinus #
Makalah Attention Is All You Need mendefinisikan positional encoding sebagai pasangan gelombang pada tiap dua kolom berdekatan:
PE(pos, 2i)   = sin(pos / 10000^(2i/d_model))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d_model))
Tiap pasangan kolom (2i, 2i+1) bergetar pada satu frekuensi omega_i = 10000^(-2i/d_model) yang melambat eksponensial seiring i. Untuk d_model = 8 kita mendapat empat pasangan: frekuensi 1 berosilasi penuh setiap 6,3 posisi, sementara frekuensi 0,001 baru menyelesaikan satu getaran setelah 6283 posisi. Kombinasinya seperti jam dengan jarum detik, menit, dan jam: pasangan cepat membedakan posisi yang berdekatan, pasangan lambat membedakan posisi yang berjauhan, dan bersama-sama keempatnya memberi tiap posisi sidik jari unik.
Menghitung PE dengan NumPy #
Program berikut menghitung PE untuk enam posisi, mencatat frekuensi tiap pasangan kolom, memverifikasi properti rotasi dengan dua pasangan angka, dan menyimpan pola keseluruhan sebagai heatmap:
"""Positional encoding sinus-kosinus ala Transformer asli (d_model=8).

Pola sinus-kosinus dihitung untuk 6 posisi, frekuensi tiap pasangan
dimensi ditampilkan, properti rotasi diverifikasi dengan angka
(PE(pos+k) adalah transformasi linear dari PE(pos) untuk tiap
frekuensi), dan pola keseluruhan disimpan sebagai heatmap PNG.
"""

import numpy as np
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt

np.set_printoptions(precision=4, suppress=True)


def positional_encoding(panjang, d_model):
    """PE(pos, 2i) = sin(pos / 10000^(2i/d)); PE(pos, 2i+1) = cos(...)."""
    pos = np.arange(panjang)[:, None]
    dua_i = np.arange(0, d_model, 2)[None, :]  # nilai 2i tiap pasangan
    sudut = pos / 10000 ** (dua_i / d_model)  # (panjang, d_model/2)
    PE = np.zeros((panjang, d_model))
    PE[:, 0::2] = np.sin(sudut)
    PE[:, 1::2] = np.cos(sudut)
    return PE


T, D = 6, 8
PE = positional_encoding(T, D)

print(f"Positional encoding untuk {T} posisi, d_model={D}:")
print(PE)
print()

frek = 10000 ** (-np.arange(0, D, 2) / D)
print("Frekuensi tiap pasangan dimensi (sin di kolom genap, cos di ganjil):")
for i, w in enumerate(frek):
    print(f"  kolom {2 * i}-{2 * i + 1}: omega = {w:.4f}"
          f"   (periode ~ {2 * np.pi / w:.1f} posisi)")
print("-> frekuensi tinggi di kolom awal berosilasi cepat;")
print("   frekuensi rendah di kolom akhir nyaris konstan")

print()
print("== Properti rotasi: PE(pos+k) = M(omega*k) @ PE(pos) ==")
print()

pos, k = 1, 2
for i in (0, 1):
    w = frek[i]
    M = np.array(
        [
            [np.cos(w * k), np.sin(w * k)],
            [-np.sin(w * k), np.cos(w * k)],
        ]
    )
    pasangan = slice(2 * i, 2 * i + 2)
    asli = PE[pos + k, pasangan]
    prediksi = M @ PE[pos, pasangan]
    selisih = float(np.abs(asli - prediksi).max())
    if selisih < 1e-15:  # di bawah tingkat derau pembulatan float64
        selisih = 0.0
    print(f"pasangan kolom {2 * i}-{2 * i + 1} (omega={w:.4f}), "
          f"pos={pos}, k={k}:")
    print(f"  PE({pos + k})[{2 * i}:{2 * i + 2}] = {asli}")
    print(f"  M @ PE({pos})[{2 * i}:{2 * i + 2}] = {prediksi}")
    print(f"  selisih maksimum = {selisih:.2e} (setara nol pada float64)")
    print()
print("Menggeser posisi = memutar pasangan (sin, cos): posisi relatif")
print("dapat dipelajari lewat transformasi linear pada PE.")

fig, ax = plt.subplots(figsize=(6.5, 3.2))
im = ax.imshow(PE, cmap="RdBu_r", vmin=-1, vmax=1, aspect="auto")
ax.set_xticks(range(D))
ax.set_yticks(range(T))
ax.set_yticklabels([f"pos {p}" for p in range(T)])
ax.set_xlabel("dimensi")
ax.set_ylabel("posisi token")
fig.colorbar(im, ax=ax, label="nilai PE")
fig.tight_layout()
fig.savefig("positional_encoding.png", dpi=110, bbox_inches="tight")
plt.close(fig)
print()
print("Heatmap disimpan ke positional_encoding.png")
Output yang Dihasilkan:
Positional encoding untuk 6 posisi, d_model=8:
[[ 0.      1.      0.      1.      0.      1.      0.      1.    ]
 [ 0.8415  0.5403  0.0998  0.995   0.01    1.      0.001   1.    ]
 [ 0.9093 -0.4161  0.1987  0.9801  0.02    0.9998  0.002   1.    ]
 [ 0.1411 -0.99    0.2955  0.9553  0.03    0.9996  0.003   1.    ]
 [-0.7568 -0.6536  0.3894  0.9211  0.04    0.9992  0.004   1.    ]
 [-0.9589  0.2837  0.4794  0.8776  0.05    0.9988  0.005   1.    ]]

Frekuensi tiap pasangan dimensi (sin di kolom genap, cos di ganjil):
  kolom 0-1: omega = 1.0000   (periode ~ 6.3 posisi)
  kolom 2-3: omega = 0.1000   (periode ~ 62.8 posisi)
  kolom 4-5: omega = 0.0100   (periode ~ 628.3 posisi)
  kolom 6-7: omega = 0.0010   (periode ~ 6283.2 posisi)
-> frekuensi tinggi di kolom awal berosilasi cepat;
   frekuensi rendah di kolom akhir nyaris konstan

== Properti rotasi: PE(pos+k) = M(omega*k) @ PE(pos) ==

pasangan kolom 0-1 (omega=1.0000), pos=1, k=2:
  PE(3)[0:2] = [ 0.1411 -0.99  ]
  M @ PE(1)[0:2] = [ 0.1411 -0.99  ]
  selisih maksimum = 0.00e+00 (setara nol pada float64)

pasangan kolom 2-3 (omega=0.1000), pos=1, k=2:
  PE(3)[2:4] = [0.2955 0.9553]
  M @ PE(1)[2:4] = [0.2955 0.9553]
  selisih maksimum = 0.00e+00 (setara nol pada float64)

Menggeser posisi = memutar pasangan (sin, cos): posisi relatif
dapat dipelajari lewat transformasi linear pada PE.

Heatmap disimpan ke positional_encoding.png
Mari kita telaah kode di atas baris per baris:
- Baris 18-26: fungsi
positional_encodingmemanfaatkan broadcasting —posberbentuk (panjang, 1) dikombinasikan dengandua_iberbentuk (1, d_model/2) menghasilkan sudut setiap pasangan posisi-frekuensi; kolom genap diisisin, kolom ganjilcos. - Baris 29-34: PE dihitung untuk 6 posisi dan 8 dimensi lalu dicetak penuh sebagai tabel yang bisa dibaca baris demi baris.
- Baris 36-42: frekuensi
10000^(-2i/d)dicetak beserta periodenya — dari satu getaran per 6,3 posisi hingga satu getaran per 6283 posisi. - Baris 48-59: verifikasi rotasi. Matriks
M(omega*k)berukuran 2x2 adalah matriks rotasi;asliadalah PE pada posisi 3,prediksiadalah hasil memutar PE pada posisi 1 dengan sudutomega*k. - Baris 60-68: hasil kedua pasangan dicetak. Selisih mentahnya paling besar satu ulp (sekitar 1e-16) dari pembulatan float64, sehingga baris 61-62 melaporkan nilai di bawah 1e-15 sebagai nol agar keluaran stabil antar eksekusi.
- Baris 72-84: heatmap PE dirender dengan
imshowdan disimpan sebagaipositional_encoding.pngpada 110 dpi.
Pada tabel PE di output, baris pos 1 memperlihatkan rentang perilaku yang lebar: kolom 0-1 sudah melompat ke [0,8415; 0,5403], kolom 2-3 baru merangkak ke [0,0998; 0,995], sedangkan kolom 6-7 praktis tak bergerak dari [0,001; 1]. Enam posisi dibedakan paling tajam oleh pasangan cepat dan paling kasar oleh pasangan lambat — persis pembagian kerja jarum jam yang berbeda kecepatan.
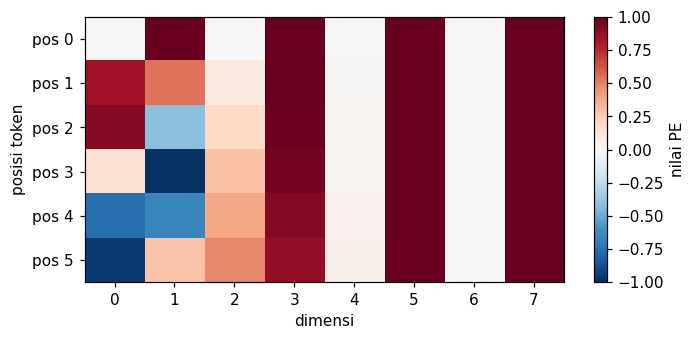
Heatmap di atas merangkum pola tersebut: sisi kiri (dimensi rendah) penuh pergantian warna antar baris posisi, sisi kanan (dimensi tinggi) nyaris satu warna. Model besar memakai pola yang sama pada d_model ratusan dimensi, dengan rentang frekuensi yang jauh lebih rapat.
Properti Rotasi: Posisi Relatif dari Transformasi Linear #
Mengapa sinus dan kosinus, bukan misalnya indeks posisi yang dinormalisasi? Alasannya adalah properti yang barusan kita buktikan: pasangan [sin(omega*pos); cos(omega*pos)] yang digeser k langkah hanyalah pasangan yang diputar dengan sudut omega*k — verifikasi kita menunjukkan selisih nol pada presisi float64 (selisih mentahnya setinggi satu ulp, sekitar 1e-16). Rotasi adalah transformasi linear, dan attention bekerja justru lewat operasi linear seperti perkalian titik. Model karenanya bisa menangkap hubungan k langkah dari token ini tanpa tabel posisi tambahan. Identitas trigonometri sin(a)sin(b) + cos(a)cos(b) = cos(a-b) memberi bonus yang rapi: perkalian titik PE(p) · PE(q) sama dengan jumlah cos(omega_i (p-q)) atas semua pasangan frekuensi — kemiripan dua vektor posisi hanya bergantung pada selisih posisinya, bukan letak absolutnya.
Alternatif Modern #
Rumus sinus-kosinus bukan satu-satunya jawaban. Learned positional embedding — dipakai GPT-2 — mengganti rumus dengan tabel parameter yang dilatih: fleksibel, tetapi tidak terdefinisi untuk posisi lebih panjang dari yang dilihat saat training. Pendekatan yang kini dominan pada model bahasa besar adalah RoPE (rotary position embedding): alih-alih menambah PE ke embedding, RoPE memutar vektor Q dan K sendiri sebelum perkalian titik, sehingga skor attention hanya bergantung pada offset relatif antar token — semangat rotasi yang sama dengan yang kita verifikasi di atas, ditanam langsung ke tempat skor dihitung.
Dengan positional encoding, seluruh bata Transformer akhirnya lengkap: token berisi plus informasi posisi, proyeksi tiga peran, scaled dot-product, dan multi-head attention. Chapter berikutnya merangkai bata-bata itu menjadi lapisan utuh pertama — Transformer encoder — lengkap dengan residual connection dan layer normalization yang menjaga stabilitas kedalaman.