Hampir seluruh pekerjaan data mengukur sebagian untuk menyimpulkan keseluruhan, dan jembatannya adalah dua gagasan yang berpaut, yaitu kesalahan baku (standard error) yang menyatakan keraguan satu rata-rata sampel, serta teorema limit pusat (CLT) yang menjadikan keraguan itu dapat dihitung. Topik ini memperagakan keduanya dengan simulasi berbiji tetap atas data pengukuran latihan. Setelah membacanya, angka dari sampel terlacak rasa ketidakpastiannya, dan dasar interval kepercayaan pada topik berikutnya sudah terbentuk.
Sampel, populasi, dan variabilitas yang tak terhindarkan#
Populasi adalah himpunan yang hendak disimpulkan, sedangkan sampel adalah bagian yang benar-benar terukur, dan rata-rata sampel tidak pernah persis sama dengan rata-rata populasi. Selisih itu bukan kesalahan kerja, melainkan konsekuensi mengukur sebagian, dan pertanyaan kerjanya berubah menjadi seberapa jauh ia biasanya menyimpang.
Jawabannya adalah kesalahan baku, yaitu simpangan dari distribusi rata-rata sampel, dan rumusnya tegas untuk sampel acak sederhana:
dengan menyatakan simpangan baku sampel dan ukurannya. Rumus tersebut menjelaskan dua perilaku yang dialami setiap pekerjaan data, yaitu sampel yang lebih besar mengecilkan ketidakpastian sebanding dengan akar kuadrat , serta populasi yang lebih tersebar memperbesarnya.
Membedakan simpangan baku dengan kesalahan baku adalah literasi pertama pada topik ini. Simpangan baku menyatakan sebaran pengukuran tunggal, sedangkan kesalahan baku menyatakan sebaran rata-rata dari sampel berukuran , dan angka keduanya berbeda sebesar faktor .
CLT dan simulasi yang memeriksanya#
Teorema limit pusat menyatakan bahwa rata-rata dari sampel acak berukuran cukup besar berdistribusi mendekati normal sekitar rata-rata populasi, apa pun bentuk distribusi asalnya, dan lebarnya adalah kesalahan baku di atas. Properti inilah yang membuat satu angka dari sampel dapat diberi jarak kepercayaan tanpa mengetahui distribusi populasi.
Simulasi berikut mengambil dua ribu sampel berukuran 30 dari data pengukuran latihan, menghitung rata-rata setiap sampel, lalu membandingkan sebarannya dengan rumus kesalahan baku.
"""Distribusi rata-rata sampel dan teorema limit pusat."""
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

data = pd.read_csv(
    "ukuran_udara.csv",
    na_values=["kosong", "-999.0"],
    dtype={"pm25": "string", "kelembapan": "string"},
)
data["pm25"] = data["pm25"].astype("float")
populasi = data.loc[data["pm25"] < 500, "pm25"].dropna().to_numpy()

rng = np.random.default_rng(42)
n = 30
estimasi = rng.choice(populasi, size=(2000, n)).mean(axis=1)

se_teoritik = populasi.std(ddof=1) / np.sqrt(n)
print(f"mean populasi          : {populasi.mean():.2f}")
print(f"mean rata-rata sampel  : {estimasi.mean():.2f}")
print(f"SE teori  {n}: {se_teoritik:.2f} | SE simulasi: {estimasi.std():.2f}")

fig, ax = plt.subplots(figsize=(6.4, 3.6), constrained_layout=True)
ax.hist(estimasi, bins=30, color="#4c72b0", edgecolor="white")
ax.axvline(populasi.mean(), color="#c44e52", linewidth=2)
ax.set_title("Distribusi rata-rata 2000 sampel (garis merah: mean populasi)")
ax.set_xlabel("rata-rata PM2.5 sampel")
ax.set_ylabel("frekuensi")
fig.savefig("distribusi-rata-sampel.png", dpi=110)
print("tersimpan: distribusi-rata-sampel.png")mean populasi : 44.86
mean rata-rata sampel : 44.87
SE teori 30: 2.22 | SE simulasi: 2.21
tersimpan: distribusi-rata-sampel.png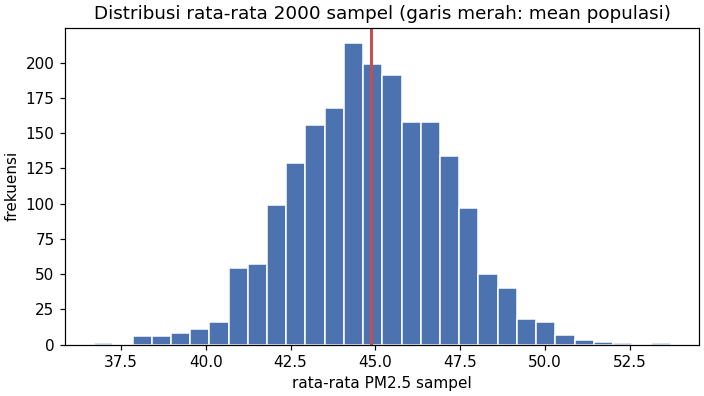
Keluarannya memverifikasi tiga klaim sekaligus. Rata-rata dua ribu sampel berimpit dengan rata-rata populasi, yaitu 44.87 berbanding 44.86, lebar sebarannya cocok dengan rumus, yaitu 2.21 berbanding 2.22, dan histogramnya berbentuk lonceng meski data asalnya bukan distribusi normal sempurna. Simulasi semacam ini adalah cara termurah memahami teorema, karena setiap barisnya dapat diubah, misalnya ukuran sampel dinaikkan menjadi 100 untuk melihat kesalahan baku menyusut sekitar separuhnya.
Syarat yang menyertai teorema#
CLT bukan mantra yang bekerja tanpa syarat, dan tiga syarat utamanya wajib diperiksa. Sampel harus acak dan independen, karena data deret waktu yang saling bergantung membuat rumus kesalahan baku terlalu optimis, dan ukuran sampel yang cukup besar bergantung pada kemencengan distribusi asalnya.
Ukuran yang cukup biasanya dianggap sekitar tiga puluh untuk distribusi yang tidak terlalu menceng, sedangkan distribusi dengan ekor tebal menuntut lebih. Pada data kecil atau sangat menceng, jalur yang jujur adalah bootstrap sebagaimana dipakai pada topik interval kepercayaan, karena ia membangun sebaran rata-rata dari data itu sendiri tanpa asumsi bentuk.
Syarat terakhir adalah populasi yang didefinisikan dengan jelas. Rata-rata PM2.5 yang disimpulkan di sini berlaku untuk himpunan pengukuran yang disampel, dan perpanjangan ke stasiun atau tahun lain adalah klaim baru yang membutuhkan data baru, sebagaimana perbedaan temuan dan hipotesis pada modul EDA.
Kesalahan umum#
Kesalahan pertama adalah melaporkan rata-rata sampel tanpa ketidakpastiannya. Satu angka tanpa kesalahan baku mengklaim presisi yang tidak dimilikinya, sementara penulisan “44.9 dengan SE 1.7” menyatakan sisa keraguannya secara jujur.
Kesalahan kedua adalah menyampel dengan pola yang tidak acak, misalnya hanya jam kerja atau hanya hari yang ramai. Rumus kesalahan baku menghitung keraguan acak saja, sedangkan bias pemilihan tidak menyusut dengan bertambah besarnya sampel, dan sampel bias yang besar tetap bias.
Kesalahan ketiga adalah mengira CLT menyamakan populasi dengan normal. Distribusi populasi tetap berbentuk asalnya, yang berubah adalah distribusi rata-ratanya, dan klaim normalitas populasi adalah keputusan lain yang butuh bukti sendiri.
Ringkasan#
- Rata-rata sampel berdenyut di sekitar rata-rata populasi, dan lebarnya adalah kesalahan baku .
- CLT membuat distribusi rata-rata sampel mendekati normal sekitar rata-rata populasi, dan simulasi berbiji tetap memeriksa keduanya dalam beberapa baris.
- Simpangan baku menyatakan sebaran pengukuran tunggal, sedangkan kesalahan baku menyatakan keraguan rata-rata, dan keduanya tidak dipertukarkan.
- Sampel acak, independen, dan cukup besar adalah syarat yang diperiksa sebelum rumus dipercaya.
Referensi#
- NumPy.random Generator — NumPy documentation — rujukan resmi generator acak berbiji yang dipakai simulasi ini.
- SciPy Stats Reference — SciPy documentation — rujukan distribusi normal yang menjadi batas limit teorema.
- The Art of Statistics — David Spiegelhalter, Basic Books — pembahasan kesalahan baku dan limit pusat untuk pembaca terapan.