Pipeline lengkap menyatukan seluruh keterampilan jalur ini dalam satu skrip
yang berjalan dari berkas mentah sampai grafik tanpa tangan yang menyelingi,
dan inilah bentuk akhir yang membuat analisis dapat diulang siapa pun. Topik
ini membangun pipeline.py untuk dataset latihan, membaca keputusan
struktur di baliknya, dan mengeksekusinya utuh. Setelah membacanya, satu
perintah menghasilkan angka bersih, ringkasan, model, dan grafik yang sama
setiap dijalankan.
Fungsi per tahap, bukan satu skrip panjang#
Pipeline yang sehat terbagi menjadi fungsi per tahap, karena kejelasan
batasnya menolong tiga hal sekaligus, yaitu pengujian per tahap, pembacaan
alurnya oleh orang baru, dan perubahan satu tahap tanpa menyentuh yang lain.
Fungsi muat_dan_bersihkan menampung seluruh kamus pembersihan, dan badan
skrip bergerak dari bersih, ringkas, model, hingga grafik.
Fungsi pembersihan adalah inti yang paling bernilai, karena seluruh keputusan dari modul pembersihan terkandung di sana, dan ia dipakai ulang oleh notebook, pipeline, dan dashboard melalui import, sehingga satu sumber kebenaran itu tidak pernah terpecah.
Skrip berikut adalah pipelinenya secara utuh, dan setiap bagiannya adalah padatan langsung dari modul-modul jalur ini.
"""Pipeline ujung-ke-ujung: akuisisi, pembersihan, eksplorasi, model, grafik."""
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import train_test_split


def muat_dan_bersihkan(path):
    """Membaca berkas mentah dan menerapkan kamus pembersihan jalur ini."""
    data = pd.read_csv(
        path,
        na_values=["kosong", "-999.0"],
        dtype={"pm25": "string", "kelembapan": "string", "kualitas": "string"},
    )
    data["pm25"] = data["pm25"].astype("float")
    data["kelembapan"] = (
        data["kelembapan"].str.replace(",", ".", regex=False).astype("float")
    )
    data["waktu"] = pd.to_datetime(data["waktu"], format="mixed", dayfirst=True)
    data["stasiun"] = (
        data["stasiun"].str.strip().str.replace(r"\s+", " ", regex=True).str.title()
    )
    data = data.drop_duplicates()
    data.loc[data["pm25"] > 500, "pm25"] = pd.NA      # sensor rusak jadi hilang
    return data


data = muat_dan_bersihkan("ukuran_udara.csv")
print(f"baris bersih: {len(data)}")

segmentasi = data.groupby("stasiun")["pm25"].agg(["count", "mean"]).round(1)
print(segmentasi.to_string())

sah = data.dropna(subset=["pm25", "suhu_c", "kelembapan"]).copy()
X = pd.get_dummies(sah[["stasiun", "suhu_c", "kelembapan"]], columns=["stasiun"])
X_latih, X_uji, y_latih, y_uji = train_test_split(
    X, sah["pm25"], test_size=0.25, random_state=42
)
model = LinearRegression().fit(X_latih, y_latih)
print(f"R2 uji model ringkas: {r2_score(y_uji, model.predict(X_uji)):.3f}")

per_stasiun = sah.groupby("stasiun")["pm25"].mean()
fig, ax = plt.subplots(figsize=(5.6, 3.2), constrained_layout=True)
ax.bar(per_stasiun.index, per_stasiun.values, color=["#4c72b0", "#c44e52"], width=0.5)
ax.set_ylim(0, 60)
ax.set_ylabel("rata-rata PM2.5")
ax.set_title("Rata-rata per stasiun (data bersih)")
fig.savefig("ringkasan-pipeline.png", dpi=110)
print("tersimpan: ringkasan-pipeline.png")baris bersih: 60
count mean
stasiun
Stasiun A 25 34.3
Stasiun B 25 55.0
R2 uji model ringkas: 0.657
tersimpan: ringkasan-pipeline.png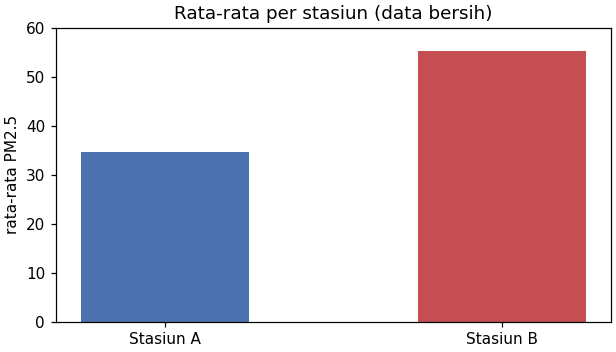
Keluarannya menceritakan keseluruhan jalur dalam lima baris, yaitu enam puluh baris bersih dari enam puluh dua baris mentah, dua stasiun dengan selisih rata-rata yang jelas, dan model sederhana dengan R-squared uji 0.657 yang sejalan dengan hasil modul kapan ML membantu. Grafik yang tersimpan dibangun ulang persis pada setiap eksekusi, dan inilah arti reproduktibel.
Keputusan struktur di baliknya#
Tiga keputusan struktur menopang skrip tersebut. Pertama, data mentah tidak pernah disunting, dan seluruh perlakuan berjalan lewat kode, sehingga berkas sumbernya tetap menjadi bukti aslinya. Kedua, sensor rusak diperlakukan sebagai data hilang alih-alih dibuang barisnya, sehingga keputusan itu terekam di satu tempat dan dapat dibedah. Ketiga, pembagian latih-uji berbiji tetap, sehingga angka modelnya stabil antar eksekusi.
Alur tersebut juga menegaskan urutan yang dipelajari sepanjang jalur, yaitu pembersihan mendahului eksplorasi, eksplorasi mendahului model, dan grafik dibangun dari data bersih yang sama dengan angka pada teksnya, sehingga tidak ada jalur kedua yang menghasilkan kebenaran berbeda.
Pipeline ini adalah lantai dasar yang diukur ulang pada proyek nyata, yaitu sumber yang berpindah dari berkas ke basis data hanya mengganti fungsi pertamanya, dan seluruh tahap di belakangnya tetap berdiri.
Dari skrip tunggal ke alur yang tumbuh#
Batas skrip tunggal muncul saat alurnya dibagi lintas tahap atau berbutir terjadwal, dan tanda pertamanya adalah waktu eksekusi yang membuat siklus sunting berat. Pada titik itu fungsi per tahap yang sudah terpisah membuat pemecahan menjadi modul atau orkestrasi terjadwal menjadi perpindahan yang halus, bukan penulisan ulang.
Pengujian yang menyertai adalah pemeriksaan murah per fungsi, misalnya jumlah baris setelah bersih, tipe kolom utama, dan rentang pm25, dan tiga pernyataan kecil semacam itu menangkap kerusakan sumber sebelum menyebarkan ke laporan. Kebiasaan ini menjadi dasar pengujian pada proyek yang dikerjakan tim.
Keseragaman keluaran juga disiplin yang disengaja, yaitu grafik dan angka bernama yang sama diperbarui setiap eksekusi, dan pembandingan antar minggu menjadi perbandingan berkas, bukan perbandingan ingatan.
Kesalahan umum#
Kesalahan pertama adalah menyunting berkas mentah untuk mempercepat pipeline. Keputusan pembersihan yang ditanam di berkas menghilang dari kode, sedangkan seluruh nilai pipeline justru ada pada kemampuannya dibangun ulang.
Kesalahan kedua adalah pipeline yang angkanya berubah setiap eksekusi tanpa
penjelasan. Pembagian acak tanpa biji atau kamus yang terpecah membuat dua
laporan berbeda dari kode yang sama, dan random_state bersama fungsi
bersihkan yang tunggal menutupnya.
Kesalahan ketiga adalah menggabungkan keluaran lama dengan yang baru di satu folder tanpa nama yang membedakan. Hasil yang saling menimpa menghancurkan jejak perbandingan, sedangkan nama keluaran yang menyertakan tanggalnya menjaga riwayatnya.
Ringkasan#
- Pipeline membagi alurnya menjadi fungsi per tahap, dan
muat_dan_bersihkanmenampung seluruh kamus pembersihan sebagai satu sumber kebenaran. - Satu eksekusi menghasilkan lima baris kebenaran, dari enam puluh baris bersih sampai R-squared uji 0.657 yang sejalan dengan modul sebelumnya.
- Data mentah tak tersentuh, sensor rusak menjadi data hilang yang terekam, dan pembagian latih-uji berbiji tetap.
- Fungsi per tahap menjadikan pertumbuhan ke modul dan orkestrasi sebagai perpindahan yang halus.
Referensi#
- Cookiecutter Data Science — driven data — konvensi struktur proyek yang melandasi pembagian tahap pipeline.
- Getting Started — scikit-learn documentation — pola fit dan predict yang dipakai tahap pemodelan pipeline.