Setelah satu variabel dipahami, pertanyaan bergerak ke hubungan antara dua variabel, dan tiga perkakas menjawabnya sesuai jenis pasangannya, yaitu scatter plot untuk dua variabel numerik, korelasi untuk kekuatan hubungan lurusnya, dan tabel silang untuk dua variabel kategori. Topik ini mempraktikkan ketiganya pada dataset latihan, lengkap dengan peringatan bahwa korelasi mengukur hubungan lurus saja. Setelah membacanya, pemilihan perkakas untuk setiap pasangan variabel menjadi keputusan yang terarah.
Scatter untuk dua variabel numerik#
Scatter plot menaruh satu variabel pada sumbu mendatar dan satu pada sumbu tegak, sehingga setiap baris menjadi satu titik, dan bentuk awannya menyatakan hubungannya lebih jujur daripada angka tunggal mana pun. Pada dataset latihan ini pertanyaannya adalah apakah PM2.5 bergerak bersama suhu, dan dua stasiun diberi warna berbeda agar polanya dapat dibaca per stasiun.
"""Hubungan bivariat: sebar, korelasi, dan silang kategori."""
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

data = pd.read_csv(
    "ukuran_udara.csv",
    na_values=["kosong", "-999.0"],
    dtype={"pm25": "string", "kelembapan": "string", "kualitas": "string"},
)
data["pm25"] = data["pm25"].astype("float")
data["kelembapan"] = data["kelembapan"].str.replace(",", ".", regex=False).astype("float")
data["stasiun"] = (
    data["stasiun"].str.strip().str.replace(r"\s+", " ", regex=True).str.title()
)
sah = data[data["pm25"] < 500]

fig, ax = plt.subplots(figsize=(6.4, 3.8), constrained_layout=True)
for stasiun, warna in [("Stasiun A", "#4c72b0"), ("Stasiun B", "#c44e52")]:
    potong = sah[sah["stasiun"] == stasiun]
    ax.scatter(potong["suhu_c"], potong["pm25"], s=22, alpha=0.7,
               label=stasiun, color=warna)
ax.set_xlabel("suhu (derajat Celsius)")
ax.set_ylabel("PM2.5")
ax.set_title("PM2.5 terhadap suhu per stasiun")
ax.legend(title="stasiun")
fig.savefig("sebar-pm25-suhu.png", dpi=110)
print("tersimpan: sebar-pm25-suhu.png")
print()

print(sah[["pm25", "suhu_c", "kelembapan"]].corr().round(2).to_string())
print()
print(pd.crosstab(sah["kualitas"].str.title(), sah["stasiun"]).to_string())tersimpan: sebar-pm25-suhu.png
pm25 suhu_c kelembapan
pm25 1.00 0.25 0.24
suhu_c 0.25 1.00 -0.09
kelembapan 0.24 -0.09 1.00
stasiun Stasiun A Stasiun B
kualitas
Baik 26 6
Sedang 0 20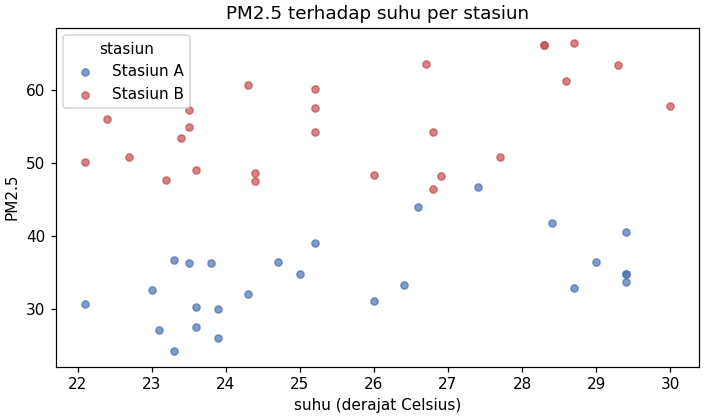
Awan titik di atas berpisah per stasiun, yaitu Stasiun A menumpuk rendah dan Stasiun B menumpuk tinggi, sedangkan hubungan dengan suhu terlihat naik perlahan pada keduanya. Pola yang berpisah per kelompok semacam ini adalah sinyal segmentasi yang akan dikerjakan pada topik berikutnya.
Korelasi: kekuatan hubungan lurus#
Koefisien korelasi Pearson mengukur kekuatan hubungan lurus antara dua variabel numerik, dengan rentang dari -1 sampai 1, dan tabel korelasi pada keluaran di atas memberi angka 0.25 untuk pasangan PM2.5 dengan suhu serta 0.24 dengan kelembapan.
Dua batasan harus menyertai setiap pembacaan korelasi. Pertama, korelasi mengukur hubungan lurus saja, sehingga hubungan berbentuk lengkung yang nyata dapat menghasilkan angka mendekati nol, dan scatter plot selalu mendahului angka korelasi. Kedua, korelasi tidak menyatakan sebab akibat, karena variabel ketiga yang tidak terukur dapat menggerakkan keduanya, misalnya aktivitas lalu lintas pagi yang menaikkan PM2.5 sekaligus suhu udara di sekitar sensor.
Angka korelasi juga peka terhadap outlier dan granularitas. Satu baris ekstrem dapat menaikkan atau menurunkan koefisien secara besar, dan penggabungan data jam menjadi harian dapat mengubah angkanya, sehingga korelasi dilaporkan bersama granularitas datanya.
Tabel silang untuk dua kategori#
Pasangan variabel kategori dijawab dengan crosstab, yaitu tabel berisi
jumlah baris untuk setiap kombinasi kategori, dan keluaran di atas
memperlihatkan pola yang tegas, yaitu seluruh pengukuran Stasiun A berada
pada kategori Baik, sedangkan Stasiun B terpecah antara Sedang dan Baik.
Tabel silang juga menjadi tempat menguji konsistensi yang dibangun pada modul pembersihan, karena kategori Baik pada dataset ini diturunkan dari ambang PM2.5, sehingga pembagian 26 berbanding 6 pada sisi Baik mengikuti distribusi nilainya. Baris “Sedang” yang kosong untuk Stasiun A adalah fakta yang layak dilaporkan, bukan kekosongan yang harus diisi.
Proporsi sering lebih mudah dibaca daripada jumlah mentah, dan
normalize="index" menyajikannya per baris, sehingga perbandingan antar
stasiun tidak tertipu oleh jumlah pengukuran yang berbeda, sebagaimana
pelajaran paradoks Simpson pada modul cara berpikir.
Kesalahan umum#
Kesalahan pertama adalah membaca korelasi rendah sebagai ketiadaan hubungan. Hubungan berbentuk U atau ambang tidak lurus, dan scatter plot pada data yang sama akan memperlihatkan polanya, sehingga angka dan gambar selalu dipasangkan.
Kesalahan kedua adalah melompat dari korelasi ke sebab akibat. Kalimat yang sah adalah “PM2.5 dan suhu bergerak searah dengan kekuatan 0.25”, sedangkan kalimat “suhu menaikkan PM2.5” menuntut bukti yang lebih kuat, dan jalur pengujian itu dibahas pada modul statistik.
Kesalahan ketiga adalah membaca tabel silang jumlah mentah tanpa memikirkan ukuran kelompok. Stasiun dengan lebih banyak pengukuran tampak lebih “menyumbang” pada setiap kategori, dan normalisasi per baris menyeimbangkan perbandingannya.
Ringkasan#
- Scatter plot mendahului angka, karena bentuk hubungan tidak selalu lurus dan pola per kelompok terlihat pada gambar lebih dahulu.
- Korelasi Pearson mengukur kekuatan hubungan lurus, rentangnya -1 sampai 1, dan ia tidak menyatakan sebab akibat.
- Tabel silang membandingkan dua kategori, dan normalisasi per baris membuat perbandingan adil terhadap ukuran kelompok.
- Pemilihan perkakas mengikuti jenis pasangan variabel, bukan kebiasaan.
Referensi#
- pandas.DataFrame.corr — pandas documentation — rujukan resmi tabel korelasi beserta metodenya.
- pandas.crosstab — pandas documentation — rujukan resmi tabel silang beserta argumen normalize.
- matplotlib.pyplot.scatter — Matplotlib documentation — dokumentasi resmi scatter plot yang dipakai di topik ini.