Analisis eksploratif dimulai dari satu variabel pada satu waktu, sebab
distribusi yang belum dipahami membuat setiap perbandingan berikutnya mudah
salah baca. Topik ini membaca PM2.5 dan kelembapan pada dataset latihan yang
sudah bersih, membacanya dengan describe(), menandai outlier dengan aturan
IQR, dan menutupnya dengan histogram yang menunjukkan bentuk sebarannya.
Setelah membacanya, pemeriksaan satu variabel berjalan dengan urutan yang
tetap dan menghasilkan kalimat deskripsi yang dapat dilaporkan.
Ringkasan angka sebelum grafik#
describe() memberikan lima angka posisi ditambah rata-rata dan simpangan
baku, dan membacanya dengan urutan tetap menangkap sebagian besar keanehan.
Median dibandingkan dengan rata-rata untuk mendeteksi kemencengan, kuartil
pertama dan ketiga menyatakan lebar tubuh sebaran, dan maksimum diuji terhadap
kuartil ketiga untuk mendeteksi nilai yang jauh.
Skrip berikut menjalankan ringkasan tersebut pada dua kolom numerik dataset latihan, lalu menghitung batas atas IQR serta menghitung outlier-nya.
"""Eksplorasi univariat: distribusi, ringkasan, dan outlier PM2.5."""
import matplotlib

matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

data = pd.read_csv(
    "ukuran_udara.csv",
    na_values=["kosong", "-999.0"],
    dtype={"pm25": "string", "kelembapan": "string"},
)
data["pm25"] = data["pm25"].astype("float")
data["kelembapan"] = data["kelembapan"].str.replace(",", ".", regex=False).astype("float")
data["stasiun"] = (
    data["stasiun"].str.strip().str.replace(r"\s+", " ", regex=True).str.title()
)

print(data[["pm25", "kelembapan"]].describe().round(1).to_string())
print()

q1, q3 = data["pm25"].quantile([0.25, 0.75])
iqr = q3 - q1
atas = q3 + 1.5 * iqr
print(f"IQR: {iqr:.1f} | batas atas: {atas:.1f}")
print("outlier IQR:", int((data["pm25"] > atas).sum()))
print()

# sensor yang jelas rusak dikeluarkan dari grafik distribusi
sah = data[data["pm25"] < 500]

fig, ax = plt.subplots(figsize=(6.4, 3.6), constrained_layout=True)
ax.hist(sah["pm25"], bins=20, color="#4c72b0", edgecolor="white")
ax.set_title("Distribusi PM2.5 (tanpa outlier ekstrem)")
ax.set_xlabel("PM2.5 (ug/m3)")
ax.set_ylabel("jumlah pengukuran")
fig.savefig("histogram-pm25.png", dpi=110)
print("tersimpan: histogram-pm25.png") pm25 kelembapan
count 53.0 59.0
mean 232.7 72.9
std 1367.4 3.2
min 24.3 66.3
25% 34.8 70.0
50% 46.7 73.1
75% 55.0 75.2
max 9999.0 80.8
IQR: 20.2 | batas atas: 85.3
outlier IQR: 1
tersimpan: histogram-pm25.pngPembacaan paling penting ada pada baris rata-rata yang jauh di atas median, yaitu 232.7 berbanding 46.7, dengan simpangan baku 1367.4. Satu baris sensor rusak bernilai 9999.0 menarik rata-ratanya tanpa menggeser median, dan inilah contoh paling gamblang mengapa median lebih aman sebagai ukuran pusat pada data yang mengandung nilai ekstrem. Outlier IQR yang terhitung satu juga menunjuk baris yang sama.
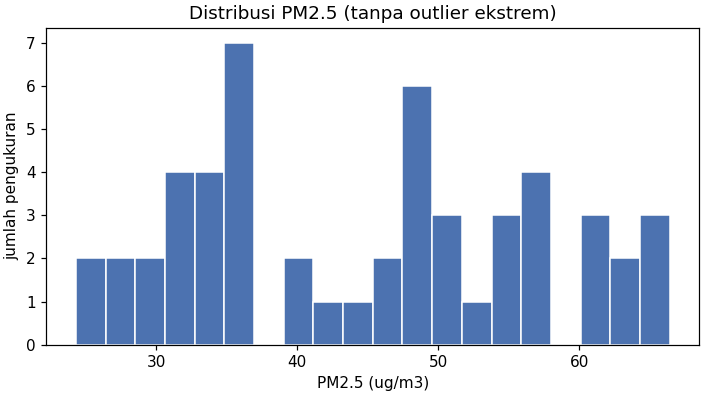
Histogram di atas disusun setelah baris sensor rusak dikeluarkan, dan bentuk tubuhnya menumpuk pada rentang 25 sampai 60 dengan ekor kanan yang pendek. Pembacaan bentuk dilengkapi angka kemencengannya pada modul statistik, dan pengajaran terpentingnya tetap pada baris rata-rata yang ditarik satu outlier, sehingga median beserta kuartil selalu dihitung sebagai pembanding setiap kali ujung data diragukan.
Outlier: menandai, bukan menghapus#
Aturan IQR menandai nilai di luar batas kuartil yang diperlebar 1.5 kali, dan hasilnya di sini tepat satu baris, yaitu sensor rusak. Pemisahan peran penting ditegaskan, yaitu statistik menandai kandidat, sedangkan keputusan menyimpan atau membuangnya berbicara dengan pengetahuan domain.
Nilai 9999.0 bukan polusi ekstrem yang menarik, melainkan kegagalan sensor yang jelas, sehingga barisnya dikeluarkan dari grafik distribusi dengan komentar yang menyatakan alasannya. Penandaan ini berbeda dengan baris yang di luar rentangnya karena peristiwa nyata, misalnya kebakaran di dekat stasiun, yang justru harus tetap ada dalam data dan didokumentasikan sebagai peristiwa khusus.
Kebiasaan yang menyertai adalah menghitung ulang ringkasan dengan dan tanpa kandidat outlier, sebab selisih keduanya mengukur pengaruh baris tersebut atas kesimpulan. Apabila selisihnya besar, kesimpulan yang dilaporkan harus menyebut kedua versi angkanya.
Kebiasaan eksplorasi univariat#
Satu variabel memberi jembatan ke pertanyaan berikutnya. Distribusi PM2.5
yang miring menyarankan pembandingan median antar stasiun, kelembapan
yang nyaris simetris dengan simpangan kecil menyarankan ia cocok menjadi
kandidat prediktor yang stabil, dan count yang berbeda antar kolom, yaitu
53 berbanding 59, mengingatkan bahwa data hilangnya tidak seragam.
Urutan kerja yang dipakai di sini menjadi baku pada seluruh modul EDA,
yaitu describe() lebih dahulu, aturan IQR untuk menandai, histogram untuk
melihat bentuk, dan kalimat deskripsi sebagai penutup. Kalimat penutupnya
misalnya berbunyi “PM2.5 berpusat pada 46.7 dengan sebaran antar kuartil
20.2, miring ke kanan, dengan satu baris sensor rusak yang dikeluarkan dari
grafik”.
Kesalahan umum#
Kesalahan pertama adalah melaporkan rata-rata tanpa median pada data yang menceng. Keluaran di atas memperlihatkan rata-rata 232.7 yang tidak menggambarkan satu pun hari pengukuran, sedangkan median 46.7 mewakili pengalaman khasnya.
Kesalahan kedua adalah membiang histogram tanpa menangani outlier ekstrem. Sumbu yang tertarik sampai 9999 membuat seluruh batang terhimpit menjadi satu, dan grafiknya tampak kosong padahal datanya ada, sehingga nilai yang jelas rusak dikeluarkan lebih dahulu dengan alasan yang dituliskan.
Kesalahan ketiga adalah memilih jumlah bin yang menyesatkan. Bin terlalu sedikit menyembunyikan dua puncak yang sebenarnya ada, sedangkan bin terlalu banyak membuat histogram bergerigi tanpa makna, dan pemeriksaan cepatnya adalah mencoba dua pilihan bin sebelum menyimpulkan bentuknya.
Ringkasan#
describe()dibaca dengan urutan tetap, yaitu median versus rata-rata, lebar kuartil, dan maksimum versus kuartil ketiga.- Aturan IQR menandai outlier, sedangkan keputusan atasnya berbicara dengan pengetahuan domain.
- Histogram dibaca untuk bentuknya, dan kemencengan ke kanan menuntut median serta kuartil sebagai ukuran pelaporan.
- Ringkasan univariat ditutup dengan satu kalimat deskripsi yang dapat dipindahkan langsung ke laporan.
Referensi#
- pandas.DataFrame.describe — pandas documentation — rujukan resmi ringkasan statistik per kolom.
- matplotlib.pyplot.hist — Matplotlib documentation — dokumentasi resmi histogram beserta argumen bins-nya.
- The Art of Statistics — David Spiegelhalter, Basic Books — pembahasan membaca distribusi dan ukuran pusat secara jujur.