p-value adalah angka yang paling sering dilaporkan dalam analisis dan sekaligus yang paling sering disalahpahami. Topik ini membahas maknanya yang sebenarnya, memperlihatkan perilakunya melalui simulasi ketika tidak ada efek nyata, merangkum galeri penyalahgunaan yang paling umum, dan menutup dengan pola pelaporan yang jujur. Setelah membacanya, p-value dapat dibaca dan dilaporkan tanpa diberi makna yang lebih besar daripada yang dimilikinya.
Makna p-value#
p-value adalah peluang memperoleh data yang setidaknya seekstrem data teramati, dengan asumsi hipotesis nihil benar. Secara notasi, p-value dituliskan sebagai , yaitu peluang data dengan syarat , bukan sebaliknya. p-value yang kecil berarti data sulit dijelaskan oleh kebetulan semata di bawah , sehingga menjadi bukti yang melawan .
Kebalikannya adalah salah paham yang paling menyebar. p-value tidak menyatakan peluang hipotesis nihil benar, yaitu , karena arah syarat dan arah hasilnya terbalik. p-value 0,03 bukan berarti memiliki peluang 3% untuk benar, melainkan berarti data seekstrem itu muncul 3% kali apabila benar. Pembalikan arah ini mengubah makna angka secara total, dan inilah asal banyak kesimpulan yang terlalu percaya diri.
Makna yang benar ini juga menjelaskan sifat p-value yang tidak simetris. p-value yang besar bukan bukti bahwa benar, melainkan tanda bahwa data tidak memberi cukup alasan untuk menolaknya. Bukti yang melawan dan bukti yang mendukung bukanlah kebalikan sempurna, dan p-value hanya menyelesaikan salah satu arahnya.
Perilaku p-value ketika tidak ada efek#
Perilaku p-value paling mudah diamati pada eksperimen yang sengaja dibuat tanpa efek. Kode berikut mengulang eksperimen tiga ribu kali, dan setiap eksperimen membandingkan dua kelompok tiga puluh data yang dibangkitkan dari populasi yang sama persis, sehingga hipotesis nihilnya benar. Seed ditetapkan agar eksperimennya dapat direproduksi.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from scipy import stats

rng = np.random.default_rng(42)
banyak_eksperimen = 3000
n = 30

# setiap eksperimen membandingkan dua kelompok yang dibangkitkan dari populasi yang sama
p_value = np.empty(banyak_eksperimen)
for i in range(banyak_eksperimen):
    a = rng.normal(70, 10, n)
    b = rng.normal(70, 10, n)
    p_value[i] = stats.ttest_ind(a, b, equal_var=False).pvalue

print(f"banyak eksperimen : {banyak_eksperimen}")
print(f"p < 0.05          : {(p_value < 0.05).mean() * 100:.1f}%")
print(f"p < 0.01          : {(p_value < 0.01).mean() * 100:.1f}%")
print(f"median p-value    : {np.median(p_value):.3f}")

plt.figure(figsize=(8, 4.5))
plt.hist(p_value, bins=20, range=(0, 1), color="#4C72B0", edgecolor="white")
plt.title("Distribusi p-value ketika H0 benar")
plt.xlabel("p-value")
plt.ylabel("Banyak eksperimen")
plt.savefig("p-value-h0.png", dpi=120)
print("Grafik tersimpan: p-value-h0.png")banyak eksperimen : 3000
p < 0.05 : 4.9%
p < 0.01 : 0.9%
median p-value : 0.494
Grafik tersimpan: p-value-h0.png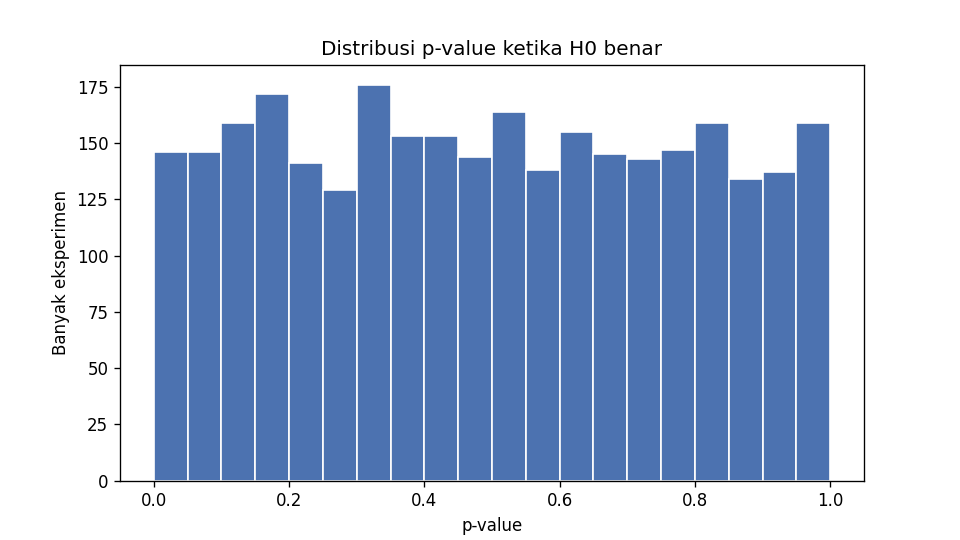
Dari tiga ribu eksperimen tanpa efek, 4,9% tetap menghasilkan p-value di bawah 0,05 dan 0,9% di bawah 0,01. Persentase tersebut bukan kegagalan metode, melainkan sifat yang dijanjikan oleh definisi ambangnya. Histogram pada gambar tampak mendekati rata di seluruh rentang, yang berarti p-value 0,01 dan p-value 0,99 sama lazimnya ketika tidak ada efek. Karena itu, satu p-value kecil pada satu pengujian dapat bersumber murni dari kebetulan, dan ambang 0,05 menetapkan berapa sering kebetulan itu dibiarkan lewat.
Median p-value 0,494 melengkapi gambar yang sama. Apabila p-value benar-benar menyebar rata dari 0 sampai 1, mediannya mendekati 0,5, dan angka yang teramati sesuai dengan dugaan itu. Tiga indikator, yaitu persentase di ambang, bentuk histogram, dan median, memberi cerita yang konsisten tanpa saling bertumpu. Simulasi semacam ini murah dijalankan dan sering menjadi cara termurah untuk menguji pemahaman atas definisi ambang.
Galeri penyalahgunaan#
Penyalahgunaan pertama adalah memperlakukan ambang 0,05 sebagai takdir. p-value 0,049 dan 0,051 menyimpan bukti yang praktis sama kuatnya, tetapi yang pertama dilaporkan signifikan sedangkan yang kedua dibuang. Ambang adalah konvensi kerja yang dideklarasikan lebih dulu, bukan garis yang memisahkan benar dan salah.
Penyalahgunaan kedua adalah p-hacking, yaitu mencoba banyak pemotongan data, subkelompok, dan bentuk uji sampai sebuah p-value menyentuh ambang. Setiap percobaan baru adalah undangan kebetulan baru, dan pada ratusan percobaan, p-value kecil hampir pasti muncul walau tidak ada efeknya. Penyalahgunaan ketiga adalah menguji banyak hipotesis sekaligus tanpa koreksi. Dua puluh uji independen dengan tingkat 5% masing-masing memberi peluang minimal satu hasil signifikan sebesar , atau sekitar 64%. Simulasi berikut menguji dua puluh hipotesis tanpa efek dengan seed tetap, lalu membandingkan hasilnya dengan koreksi Bonferroni yang membagi ambang dengan banyaknya uji.
import numpy as np
from scipy import stats

# 20 uji independen pada data yang tidak memiliki efek nyata (H0 benar)
rng = np.random.default_rng(7)
p_value = np.empty(20)
for i in range(20):
    a = rng.normal(70, 10, 30)
    b = rng.normal(70, 10, 30)
    p_value[i] = stats.ttest_ind(a, b, equal_var=False).pvalue

print(f"p-value terkecil                  : {p_value.min():.4f}")
print(f"banyak uji dengan p < 0.05        : {(p_value < 0.05).sum()}")
print(f"peluang minimal satu p < 0.05     : {(1 - 0.95 ** 20) * 100:.1f}%")
print(f"ambang Bonferroni (0.05 / 20) : {0.05 / 20:.4f}")p-value terkecil : 0.0187
banyak uji dengan p < 0.05 : 1
peluang minimal satu p < 0.05 : 64.2%
ambang Bonferroni (0.05 / 20) : 0.0025Dari dua puluh uji, satu uji menghasilkan p-value 0,0187. Apabila hanya uji itu yang dilaporkan, kesimpulannya ada efek, padahal peluang mendapati minimal satu p-value semacam itu pada dua puluh uji sudah 64,2% sejak awal. Koreksi Bonferroni menurunkan ambang menjadi 0,0025, dan p-value 0,0187 tidak meloloskannya. Cara lain yang jujur adalah melaporkan seluruh uji yang dilakukan, termasuk yang tidak signifikan, sehingga pembaca dapat menimbang buktinya secara utuh.
Penyalahgunaan keempat kembali ke pembalikan arah peluang. p-value diartikan sebagai peluang hipotesis nihil benar, sehingga p-value 0,05 dianggap berarti peluang benar sebesar 5%. Makna itu tidak didukung definisi apa pun, dan menghitung peluang benar memerlukan pendekatan lain yang menyertakan peluang awal dari hipotesis yang ditimbang.
Melaporkan p-value secara jujur#
Pelaporan yang jujur menempatkan p-value sebagai satu bagian dari cerita, bukan keseluruhan ceritanya. Angka p ditulis apa adanya, misalnya p = 0,13 dan bukan sekadar tidak signifikan, karena pembaca berhak menilai jaraknya terhadap ambang. Ukuran efek dan interval kepercayaan dilaporkan bersamanya, sehingga pembaca mengetahui besar efek sekaligus ketidakpastiannya.
Jumlah uji yang dilakukan juga dinyatakan. Bila satu hipotesis utama diuji satu kali, kalimatnya sederhana. Bila banyak hipotesis diuji, metrik utama dinyatakan lebih dahulu, koreksinya disebutkan, dan metrik lain dilaporkan sebagai eksploratif. Kalimat hasil yang utuh kira-kira berbunyi: “Selisih mean antarkelas 3,21 poin dengan ukuran efek 0,44, uji t memberi p = 0,13 pada ambang 0,05, sehingga bukti perbedaannya belum cukup.”
Pola yang sama berlaku ketika hasilnya tidak signifikan. Hasil gagal menolak tetap berharga karena membatasi klaim, sedangkan hasil yang disembunyikan membuat koleksi temuan condong ke arah kebetulan. Laporan yang lengkap memuat statistik ujinya, ukuran sampelnya, dan batas keputusannya, sehingga analisis lain dapat menimbang kembali dengan data yang sama.
Ringkasan#
- p-value adalah peluang data seekstrem teramati dengan syarat benar, bukan peluang benar.
- Ketika tidak ada efek, p-value tetap tersebar rata dan sekitar 5% eksperimen menyentuh ambang karena kebetulan semata.
- Ambang 0,05 yang diperlakukan sebagai takdir, p-hacking, dan uji berulang tanpa koreksi melipatgandakan hasil keliru yang dilaporkan.
- Pelaporan jujur menyertakan p secara penuh, ukuran efek, interval kepercayaan, dan jumlah uji yang dilakukan.
Referensi#
- scipy.stats — SciPy Project — Dokumentasi stats.ttest_ind yang digunakan pada simulasi distribusi p-value.
- OpenIntro Statistics — OpenIntro — Bab inferensi yang membahas makna p-value dan penyalahgunaannya.
- Dokumentasi resmi numpy — NumPy Project — Dokumentasi Generator yang membangkitkan eksperimen simulasi dengan seed tetap.