Angka mean (rata-rata) sampel merangkum data menjadi satu nilai, tetapi satu angka itu menyembunyikan ketidakpastian yang melekat pada pengambilan sampel. Topik ini membahas interval kepercayaan sebagai cara menyatakan ketidakpastian, mulai dari standard error yang menjadi bahan pembentuknya, perhitungan interval dengan scipy pada data durasi tunggu klinik, pendekatan bootstrap dengan seed tetap, sampai cara membaca dan melaporkan hasilnya. Setelah membacanya, mean dari sebuah sampel dapat dilaporkan bersama rentang ketidakpastiannya.
Makna interval kepercayaan#
Interval kepercayaan (confidence interval) adalah rentang yang dihitung dari data sampel dan mengelilingi statistik yang dilaporkan. Interval kepercayaan 95% berarti prosedur pembuatannya menangkap parameter populasi pada 95% pengambilan sampel yang mungkin, bukan berarti parameter berada di dalam interval tertentu dengan peluang 95%. Setelah interval satu set data dihitung, interval itu sudah menangkap parameter atau tidak, dan tidak ada keacakan tersisa pada hasilnya. Kepercayaan 95% melekat pada prosedurnya, bukan pada satu interval hasilnya.
Cara termudah memahami maknanya adalah mengulang analisis pada banyak sampel. Sebagian besar interval yang dihasilkan memuat parameter yang sebenarnya, sedangkan sebagian kecil meleset, dan tidak ada petunjuk yang menunjukkan interval mana yang meleset. Karena itu, satu interval dilaporkan selalu bersama tingkat kepercayaannya, dan klaimnya dibaca sebagai perkiraan rentang, bukan sebagai batas yang pasti.
Interval juga menyampaikan informasi yang tidak dimiliki mean tunggal. Interval yang lebar menandakan data yang sedikit atau sangat bervariasi, sedangkan interval yang sempit menandakan estimasi yang mantap. Dua analisis dengan mean yang sama dapat menyimpan tingkat ketidakpastian yang berbeda, dan perbedaan itu baru terlihat ketika interval dilaporkan.
Standard error dan interval t#
Bahan pembentuk interval adalah sebaran statistik sampel, yang disebut standard error. Untuk mean, standard error dihitung dari simpangan baku sampel dan banyaknya data :
Pembagi menjelaskan perilaku yang terlihat pada simulasi pengambilan sampel, yaitu ukuran sampel yang lebih besar mengecilkan sebaran mean. Interval kepercayaan untuk mean dibentuk dengan menjauhi ke kedua arah sejauh , dengan berupa nilai kritis dari distribusi t berderajat kebebasan :
Distribusi t digunakan, bukan distribusi normal, karena simpangan baku populasi tidak diketahui dan hanyalah perkiraannya. Pada ukuran sampel yang besar, nilai untuk tingkat kepercayaan 95% mendekati 1,96, sedangkan pada sampel kecil nilainya lebih besar sebagai kompensasi ketidakpastian tambahan. Kode berikut menghitung interval untuk mean durasi tunggu tiga puluh pasien klinik dengan dua cara, yaitu manual dan dengan fungsi bawaan scipy.
import numpy as np
from scipy import stats

# durasi tunggu 30 pasien di satu klinik (menit), tercatat sepanjang satu hari
durasi = np.array([4, 5, 6, 7, 7, 8, 8, 9, 9, 10, 10, 11, 11, 12, 12,
                   13, 13, 14, 14, 15, 16, 17, 18, 19, 21, 23, 25, 28, 32, 38])

n = len(durasi)
mean = durasi.mean()
se = durasi.std(ddof=1) / np.sqrt(n)
t_kritis = stats.t.ppf(0.975, df=n - 1)
bawah = mean - t_kritis * se
atas = mean + t_kritis * se

# perhitungan yang sama dengan fungsi bawaan scipy
bawah2, atas2 = stats.t.interval(confidence=0.95, loc=mean,
                                 scale=stats.sem(durasi), df=n - 1)

print(f"n                        : {n}")
print(f"mean                     : {mean:.2f}")
print(f"simpangan baku           : {durasi.std(ddof=1):.2f}")
print(f"standard error           : {se:.2f}")
print(f"nilai t kritis (95%)     : {t_kritis:.3f}")
print(f"interval 95% (manual)    : ({bawah:.2f}, {atas:.2f})")
print(f"interval 95% (scipy) : ({bawah2:.2f}, {atas2:.2f})")n : 30
mean : 14.50
simpangan baku : 8.14
standard error : 1.49
nilai t kritis (95%) : 2.045
interval 95% (manual) : (11.46, 17.54)
interval 95% (scipy) : (11.46, 17.54)Mean durasi tunggu sampel adalah 14,50 menit dengan standard error 1,49 menit. Nilai sebesar 2,045 menghasilkan interval dari 11,46 sampai 17,54 menit, dan kedua cara perhitungan memberi hasil yang sama. Kalimat pelaporannya misalnya berbunyi: “Mean durasi tunggu populasi diperkirakan antara 11,46 dan 17,54 menit dengan tingkat kepercayaan 95%.” Rentang itu bukan sebaran durasi pasien individual, yang jauh lebih lebar, melainkan rentang bagi mean populasi.
Bootstrap dengan seed tetap#
Bootstrap adalah pendekatan modern yang menghitung interval tanpa rumus tertutup. Prinsipnya memperlakukan sampel sebagai populasi kecil, lalu mengambil resample, yaitu sampel ulang dengan pengembalian, sebanyak ukuran aslinya. Mean dihitung pada setiap resample, pengambilan diulang ribuan kali, dan persentil ke-2,5 serta ke-97,5 dari kumpulan mean resample menjadi batas interval 95%. Pendekatan ini berguna ketika statistik yang dilaporkan sulit diturunkan rumus intervalnya, misalnya median.
Kode berikut mengulang bootstrap lima ribu kali pada data durasi tunggu yang sama dengan seed tetap. Sebaran mean resample digambar sebagai histogram, dan dua batas intervalnya ditandai garis putus-putus merah.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np

# durasi tunggu 30 pasien di satu klinik (menit), data yang sama dengan blok sebelumnya
durasi = np.array([4, 5, 6, 7, 7, 8, 8, 9, 9, 10, 10, 11, 11, 12, 12,
                   13, 13, 14, 14, 15, 16, 17, 18, 19, 21, 23, 25, 28, 32, 38])

n = len(durasi)
banyak_resample = 5000
rng = np.random.default_rng(42)

# bootstrap: resample dengan pengembalian, lalu hitung mean setiap resample
mean_resample = np.empty(banyak_resample)
for i in range(banyak_resample):
    resample = rng.choice(durasi, size=n, replace=True)
    mean_resample[i] = resample.mean()

bawah, atas = np.percentile(mean_resample, [2.5, 97.5])
print(f"mean sampel            : {durasi.mean():.2f}")
print(f"interval bootstrap 95% : ({bawah:.2f}, {atas:.2f})")

plt.figure(figsize=(8, 4.5))
plt.hist(mean_resample, bins=40, color="#4C72B0", edgecolor="white")
plt.axvline(bawah, color="#C44E52", linestyle="--", linewidth=1.5)
plt.axvline(atas, color="#C44E52", linestyle="--", linewidth=1.5)
plt.title("Distribusi bootstrap mean durasi tunggu")
plt.xlabel("Mean resample (menit)")
plt.ylabel("Banyak resample")
plt.savefig("histogram-bootstrap.png", dpi=120)
print("Grafik tersimpan: histogram-bootstrap.png")mean sampel : 14.50
interval bootstrap 95% : (11.80, 17.57)
Grafik tersimpan: histogram-bootstrap.png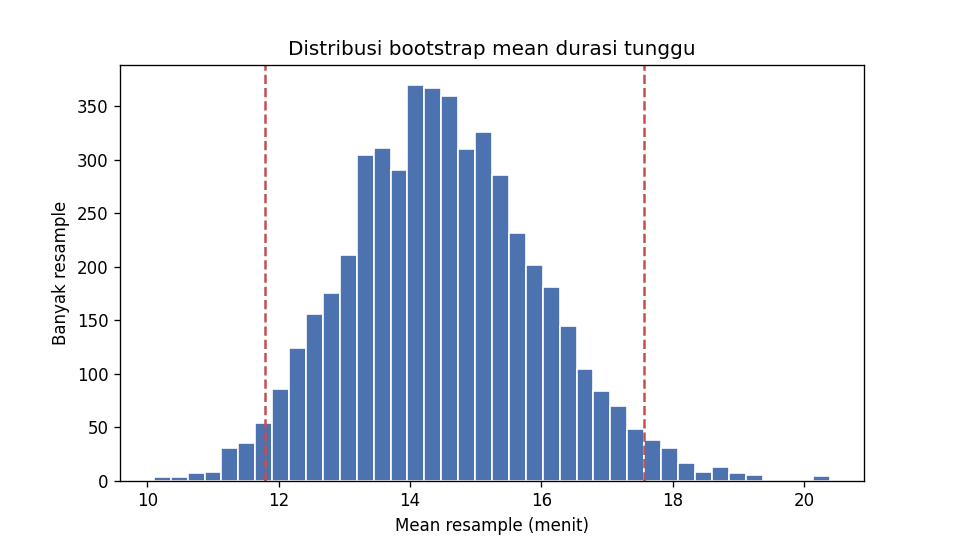
Interval bootstrap dari 11,80 sampai 17,57 menit berdekatan dengan interval t pada 11,46 sampai 17,54 menit, meskipun tidak identik karena keduanya menempuh jalan yang berbeda. Histogram memperlihatkan sebaran mean resample yang sedikit termiring ke kanan, mengikuti bentuk data aslinya, dan garis putus-putus merah menandai kedua batas interval. Ketidakcocokan kecil antara kedua metode adalah hal yang wajar pada sampel berukuran tiga puluh yang datanya tidak simetris.
Membaca dan melaporkan interval#
Pola pelaporan yang baik menempatkan interval di samping statistiknya dalam satu kalimat, misalnya mean durasi tunggu 14,50 menit dengan interval kepercayaan 95% dari 11,46 sampai 17,54 menit. Lebar interval itu sendiri adalah informasi, karena interval yang lebar menyatakan estimasi yang belum mantap dan mengajak kehati-hatian sebelum keputusan diambil. Ketika dua kelompok dibandingkan, interval yang jauh terpisah menandakan perbedaan yang jelas, sedangkan interval yang saling menumpuk baru dapat dipastikan dengan pengujian formal.
Salah baca yang paling umum adalah menganggap interval sebagai sebaran data. Kalimat “95% pasien menunggu antara 11,46 dan 17,54 menit” tidak didukung oleh perhitungan ini, karena interval bercakap tentang mean populasi, bukan tentang durasi individual. Kesalahan lain adalah memperlakukan tingkat kepercayaan sebagai peluang setelah interval terhitung. Tabel berikut merangkum pernyataan yang tepat dan yang keliru.
| Pernyataan | Status |
|---|---|
| Mean populasi diperkirakan antara 11,46 dan 17,54 menit dengan kepercayaan 95% | tepat |
| 95% pasien menunggu antara 11,46 dan 17,54 menit | keliru, itu sebaran durasi individual |
| Peluang mean populasi berada di dalam interval ini adalah 95% | keliru, interval yang sudah terhitung bersifat tetap |
Perintah praktisnya sederhana. Laporkan statistik bersama interval dan tingkat kepercayaannya, sebutkan ukuran sampelnya, dan hindari kalimat yang mengubah interval menjadi janji tentang data individual. Interval yang lebar dilaporkan apa adanya, bukan disembunyikan, karena lebar itulah yang menjaga laporan tetap jujur terhadap data yang sedikit.
Ringkasan#
- Interval kepercayaan menyatakan rentang ketidakpastian statistik sampel, dan tingkat kepercayaannya melekat pada prosedur, bukan pada satu interval hasil.
- Standard error menjadi bahan utama interval mean, sehingga ukuran sampel yang lebih besar mempersempit interval.
- Bootstrap menghitung interval dari ribuan resample berseed tetap dan memberi hasil yang berdekatan dengan interval t pada data yang sama.
- Interval dilaporkan bersama statistik dan ukuran sampelnya, lalu dibaca sebagai rentang bagi parameter, bukan sebaran data individual.
Referensi#
- scipy.stats — SciPy Project — Dokumentasi distribusi t, stats.t.interval, dan stats.sem yang digunakan pada perhitungan interval.
- Dokumentasi resmi numpy — NumPy Project — Dokumentasi Generator dan np.percentile yang digunakan pada bootstrap.
- OpenIntro Statistics — OpenIntro — Bab estimasi berbasis sampel yang membahas standard error dan interval kepercayaan.