Retensi menjawab pertanyaan inti hampir setiap layanan yang berjalan lama, yaitu apakah orang yang masuk pada bulan lalu masih menggunakan layanannya hari ini. Topik ini membahas analisis kohort, yaitu teknik menyusun tabel retensi dengan mengelompokkan anggota menurut bulan pertama tercatatnya, lalu menghitung banyaknya yang masih aktif pada bulan-bulan berikutnya. Seluruh perhitungan dijalankan dengan pandas atas catatan peminjaman perpustakaan sekolah, dan hasil akhirnya berupa tabel retensi lengkap dengan visualisasinya.
Konsep kohort dan retensi#
Sebuah kohort adalah kelompok yang anggotanya melalui peristiwa yang sama pada periode yang sama, dan pada analisis retensi peristiwa itu adalah bulan pertama tercatat. Anggota yang pertama kali meminjam pada Juli membentuk kohort Juli, dan seterusnya untuk setiap bulan. Ukuran kohort adalah banyaknya anggota pada bulan masuk, sedangkan retensi adalah proporsi anggota yang masih aktif pada bulan ke-n sejak masuk. Angka retensi selalu dimulai dari 100 persen pada bulan ke-0, karena bulan itu sendiri menjadi bulan masuk kohortnya. Perbandingan antarkohort menjadi adil karena setiap kohort diukur dari titik masuknya masing-masing, bukan dari tanggal kalender yang sama. Pada skenario perpustakaan, aktif diartikan sebagai meminjam sekurang-kurangnya satu judul pada bulan tersebut, dan definisi sederhana seperti ini perlu dinyatakan karena angka retensi berubah apabila definisinya berubah.
Data aktivitas peminjaman#
Data contoh berupa catatan peminjaman delapan anggota perpustakaan sepanjang Juli sampai November 2024, yang disederhanakan menjadi dua kolom, yaitu nama dan tanggal. Satu baris berarti satu peminjaman, dan satu anggota dapat muncul beberapa kali karena meminjam lebih dari satu judul. Data disusun dari literal pada blok berikut, lalu disimpan sebagai berkas peminjaman-anggota.csv yang digunakan ulang oleh seluruh blok sesudahnya.
import pandas as pd

pinjam = {
    "Ali":   ["2024-07-05", "2024-07-19", "2024-08-08", "2024-09-11", "2024-10-15", "2024-11-06"],
    "Budi":  ["2024-07-12", "2024-08-20", "2024-10-09"],
    "Citra": ["2024-07-25", "2024-09-04"],
    "Dewi":  ["2024-07-16", "2024-08-13", "2024-09-24", "2024-11-19"],
    "Eka":   ["2024-08-02", "2024-08-28", "2024-09-10"],
    "Fajar": ["2024-08-22", "2024-09-17", "2024-10-03", "2024-11-12"],
    "Gita":  ["2024-09-06", "2024-09-27", "2024-10-21", "2024-11-25"],
    "Hadi":  ["2024-09-13", "2024-09-30", "2024-10-09"],
}

df = pd.DataFrame(
    [(nama, tanggal) for nama, daftar in pinjam.items() for tanggal in daftar],
    columns=["nama", "tanggal"],
)
df["tanggal"] = pd.to_datetime(df["tanggal"])
df.to_csv("peminjaman-anggota.csv", index=False)
print(df) nama tanggal
0 Ali 2024-07-05
1 Ali 2024-07-19
2 Ali 2024-08-08
3 Ali 2024-09-11
4 Ali 2024-10-15
5 Ali 2024-11-06
6 Budi 2024-07-12
7 Budi 2024-08-20
8 Budi 2024-10-09
9 Citra 2024-07-25
10 Citra 2024-09-04
11 Dewi 2024-07-16
12 Dewi 2024-08-13
13 Dewi 2024-09-24
14 Dewi 2024-11-19
15 Eka 2024-08-02
16 Eka 2024-08-28
17 Eka 2024-09-10
18 Fajar 2024-08-22
19 Fajar 2024-09-17
20 Fajar 2024-10-03
21 Fajar 2024-11-12
22 Gita 2024-09-06
23 Gita 2024-09-27
24 Gita 2024-10-21
25 Gita 2024-11-25
26 Hadi 2024-09-13
27 Hadi 2024-09-30
28 Hadi 2024-10-09Seluruhnya 29 baris mencatat delapan anggota, dengan masuk paling awal pada Juli dan paling akhir pada September. Susunan tanggalnya sengaja memuat tiga pola yang sering dijumpai, yaitu anggota yang meminjam setiap bulan, anggota yang melewatkan satu bulan lalu kembali, dan anggota yang berhenti setelah bulan-bulan pertamanya. Pola inilah yang nanti tampil sebagai perbedaan retensi antarkohort.
Bulan masuk dan jarak bulan#
Kohort ditentukan dari bulan pertama setiap anggota tercatat, dan perhitungannya berjalan dalam tiga langkah. Kolom tanggal dikonversi menjadi periode bulan dengan to_period, sehingga tanggal berapa pun dalam satu bulan jatuh pada nilai yang sama. Metode groupby dengan min mencari bulan pertama setiap anggota, lalu pemetaan nama mengembalikan kohortnya ke setiap baris. Jarak bulan dihitung sebagai selisih angka periode, yaitu bulan ke-0 untuk bulan masuk, bulan ke-1 untuk satu bulan sesudahnya, dan seterusnya.
import pandas as pd

df = pd.read_csv("peminjaman-anggota.csv", parse_dates=["tanggal"])
df["bulan"] = df["tanggal"].dt.to_period("M")
kohort = df.groupby("nama")["bulan"].min()
df["kohort"] = df["nama"].map(kohort)
df["bulan_ke"] = df["bulan"].astype("int64") - df["kohort"].astype("int64")
print(df[["nama", "bulan", "kohort", "bulan_ke"]].head(9)) nama bulan kohort bulan_ke
0 Ali 2024-07 2024-07 0
1 Ali 2024-07 2024-07 0
2 Ali 2024-08 2024-07 1
3 Ali 2024-09 2024-07 2
4 Ali 2024-10 2024-07 3
5 Ali 2024-11 2024-07 4
6 Budi 2024-07 2024-07 0
7 Budi 2024-08 2024-07 1
8 Budi 2024-10 2024-07 3Kolom kohort bernilai sama untuk seluruh baris satu anggota, sedangkan kolom bulan_ke bertambah setiap kali anggota itu meminjam pada bulan berikutnya. Baris Budi memperlihatkan bulan September yang dilewatkan, yaitu loncatan dari bulan ke-1 langsung ke bulan ke-3. Konversi menjadi periode bulan membuat perhitungan jarak ini tidak perlu peduli panjang bulan, karena tanggal apa pun dalam satu bulan diperlakukan sama.
Tabel pivot kohort#
Tabel kohort dibangun dengan pivot_table yang menghitung banyaknya anggota unik untuk setiap pasangan kohort dan bulan_ke. Argumen aggfunc="nunique" penting, karena satu anggota dapat meminjam dua kali dalam satu bulan seperti Eka pada Agustus, dan penghitungan biasa akan menghitungnya dua kali. Index hasilnya berupa kohort, sedangkan kolomnya berupa jarak bulan.
import pandas as pd

df = pd.read_csv("peminjaman-anggota.csv", parse_dates=["tanggal"])
df["bulan"] = df["tanggal"].dt.to_period("M")
kohort = df.groupby("nama")["bulan"].min()
df["kohort"] = df["nama"].map(kohort)
df["bulan_ke"] = df["bulan"].astype("int64") - df["kohort"].astype("int64")

aktif = df.pivot_table(index="kohort", columns="bulan_ke", values="nama", aggfunc="nunique")
print(aktif)bulan_ke 0 1 2 3 4
kohort
2024-07 4.0 3.0 3.0 2.0 2.0
2024-08 2.0 2.0 1.0 1.0 NaN
2024-09 2.0 2.0 1.0 NaN NaNBentuk tabelnya sudah sesuai kebiasaan analisis kohort, yaitu baris untuk kohort Juli, Agustus, dan September, dengan kolom bulan ke-0 sampai ke-4. Sel 4.0 pada pojok kiri berarti keempat anggota kohort Juli meminjam pada bulan masuknya, sedangkan angka yang mengecil ke arah kanan menunjukkan banyak anggota yang berhenti. Sel NaN berarti tidak ada baris untuk pasangan kohort dan bulan tersebut, dan pada tabel ini semua NaN berada di sisi kanan, yaitu bulan yang jatuh sesudah data berakhir pada November 2024.
Angka aktif belum menjadi retensi karena ukuran kohortnya berbeda, yaitu empat, dua, dan dua anggota. Retensi diperoleh dengan membagi setiap kolom pada kolom bulan ke-0 yang berisi ukuran kohortnya, sehingga hasilnya berupa proporsi yang mudah dibandingkan dari baris ke baris.
import pandas as pd

df = pd.read_csv("peminjaman-anggota.csv", parse_dates=["tanggal"])
df["bulan"] = df["tanggal"].dt.to_period("M")
kohort = df.groupby("nama")["bulan"].min()
df["kohort"] = df["nama"].map(kohort)
df["bulan_ke"] = df["bulan"].astype("int64") - df["kohort"].astype("int64")

aktif = df.pivot_table(index="kohort", columns="bulan_ke", values="nama", aggfunc="nunique")
retensi = aktif.div(aktif[0], axis=0)
print(retensi)bulan_ke 0 1 2 3 4
kohort
2024-07 1.0 0.75 0.75 0.5 0.5
2024-08 1.0 1.00 0.50 0.5 NaN
2024-09 1.0 1.00 0.50 NaN NaNKetiga kohort mempertahankan seluruh anggotanya pada bulan pertama, lalu turun bertahap menuju sekitar separuh anggota pada bulan-bulan berikutnya yang cukup teramati. Kohort Juli terukur paling jauh karena masuk paling awal, sedangkan bulan ke-4 kohort Agustus serta bulan ke-3 dan ke-4 kohort September kosong karena jatuh pada Desember dan Januari, sesudah data berakhir. Pola batas data seperti ini wajar pada analisis kohort dan perlu dinyatakan saat tabelnya dilaporkan.
Menampilkan retensi sebagai heatmap#
Tabel retensi dengan beberapa kohort dan bulan terbaca lebih cepat sebagai heatmap, yaitu grafik kisi yang mewarnai setiap sel sesuai nilainya. Fungsi sns.heatmap dari seaborn menerima tabel retensi langsung, dan argumen annot=True menuliskan angka proporsinya pada setiap sel dalam bentuk persen. Sel yang nilainya NaN tidak diberi warna dan tidak diberi angka, sehingga batas data terlihat tanpa garis tambahan.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

df = pd.read_csv("peminjaman-anggota.csv", parse_dates=["tanggal"])
df["bulan"] = df["tanggal"].dt.to_period("M")
kohort = df.groupby("nama")["bulan"].min()
df["kohort"] = df["nama"].map(kohort)
df["bulan_ke"] = df["bulan"].astype("int64") - df["kohort"].astype("int64")

aktif = df.pivot_table(index="kohort", columns="bulan_ke", values="nama", aggfunc="nunique")
retensi = aktif.div(aktif[0], axis=0)

fig, ax = plt.subplots(figsize=(7, 3.2))
sns.heatmap(retensi, annot=True, fmt=".0%", cmap="Blues", vmin=0, vmax=1, ax=ax,
            cbar_kws={"label": "Retensi"})
ax.set_xlabel("Bulan ke-")
ax.set_ylabel("Kohort bulan masuk")
ax.set_title("Retensi peminjaman per kohort bulan masuk")
plt.savefig("peta-panas-retensi.png", dpi=120)
print("Gambar tersimpan sebagai peta-panas-retensi.png")Gambar tersimpan sebagai peta-panas-retensi.png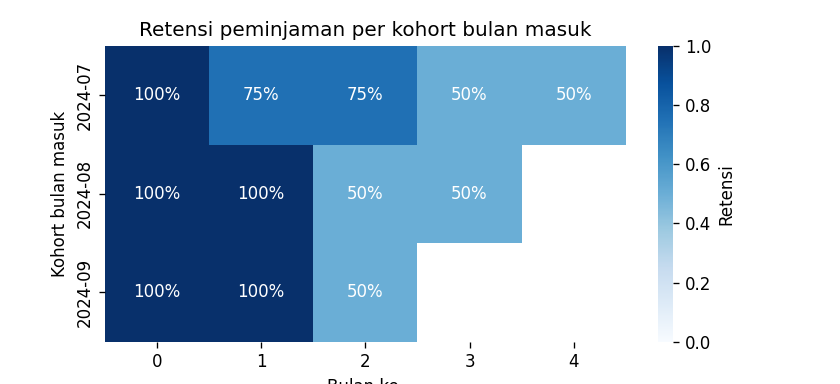
Warna sel memudar dari kiri ke kanan pada setiap baris, sesuai retensi yang menurun, dan garis pemisah antarsel memudahkan perbandingan antarkohort. Angka 50 persen yang berulang pada kolom-kolom kanan menjadi temuan utamanya, yaitu sekitar separuh anggota baru yang berhenti seiring waktu. Untuk laporan, tabel angka dan heatmap digunakan berdampingan, karena tabel memberi nilai pasti sedangkan heatmap memberi gambaran bentuk polanya.
Kesalahan umum#
Kesalahan pertama adalah menghitung baris, bukan anggota. Argumen aggfunc="count" menghitung setiap peminjaman, sehingga anggota yang meminjam dua kali dalam satu bulan seperti Eka membuat retensi kohortnya terhitung terlalu tinggi. Fungsi yang tepat adalah nunique, yaitu banyaknya anggota unik, dan pemeriksaan cepatnya berupa perbandingan ukuran kohort bulan ke-0 dengan daftar anggotanya.
Kesalahan kedua adalah menghitung jarak bulan dari selisih hari. Membagi selisih tanggal dengan 30 menghasilkan angka yang meleset karena panjang bulan berbeda, misalnya 31 hari untuk Agustus. Konversi menjadi periode bulan dengan to_period("M") membuang tanggalnya, sehingga selisih periodenya selalu berupa bilangan bulat yang tepat.
Kesalahan ketiga adalah membagi retensi dengan jumlah anggota seluruh data. Pembagi yang benar adalah ukuran kohort pada bulan ke-0, yaitu kolom pertama tabel aktif, bukan banyaknya anggota pada berkas. Apabila pembaginya salah, kohort kecil tampak lemah padahal retensinya sehat, dan kesimpulan perbandingan antarkohort langsung rusak.
Ringkasan#
- Kohort ditentukan dari bulan pertama tercatat melalui
groupbydanmin, lalu jarak bulan dihitung dari selisih periode bulan. pivot_tabledenganaggfunc="nunique"menghasilkan tabel anggota aktif per kohort dan bulan_ke, dan pembagian pada kolom bulan ke-0 menghasilkan tabel retensi.- Sel NaN menandakan bulan di luar jangkauan data, bukan retensi nol, sehingga batas data perlu dinyatakan saat tabel dilaporkan.
- Heatmap seaborn menampilkan retensi sebagai kisi warna beranotasi persen, dengan sel NaN yang tetap kosong sebagai tanda batas data.
Referensi#
- pandas documentation — Pandas — Dokumentasi resmi pandas yang mencakup groupby, pivot_table, dan tipe periode bulan.
- pandas user guide — Pandas — Panduan resmi pandas dengan bagian group by dan reshaping untuk menyusun tabel kohort.