Perangkuman per kelompok adalah operasi yang paling sering dijalankan pada data tabular, misalnya rata-rata nilai per kelas atau jumlah peminjaman per bulan. Topik ini membahas pola split-apply-combine, yakni pola membagi, menerapkan, dan menggabungkan yang melandasinya, beserta penerapannya dengan groupby dan agg pada pandas. Setelah topik ini, data mentah dapat dirangkum menjadi tabel ringkasan per kelompok yang memuat beberapa ukuran sekaligus, dilengkapi grafik pembanding antarkelompok.
Pola split-apply-combine#
Pola split-apply-combine terdiri atas tiga tahap. Tahap split membagi baris data menjadi kelompok berdasarkan nilai satu kolom, misalnya per kelas. Tahap apply menerapkan satu fungsi pada setiap kelompok secara terpisah, misalnya menghitung rata-rata. Tahap combine menggabungkan hasil setiap kelompok menjadi satu tabel ringkasan baru. Metode groupby menyatukan ketiga tahap itu dalam satu baris kode, dan diagram berikut memperlihatkan alurnya.
Diagram tersebut menggunakan data dua belas siswa pada tiga kelas. Baris dibagi menjadi tiga kelompok pada tahap split, rata-rata matematika dihitung pada tahap apply, lalu tiga angka hasilnya digabung menjadi satu tabel kecil pada tahap combine. Pola yang sama berlaku untuk fungsi agregasi apa pun, bukan hanya rata-rata, termasuk median, jumlah, dan nilai maksimum.
Merangkum dengan groupby#
Data contoh berisi nilai dua mata pelajaran untuk dua belas siswa dari tiga kelas. Potongan pertama membangun data tersebut dari literal, menyimpannya sebagai berkas nilai-tiga-kelas.csv, lalu menampilkannya kembali. Berkas CSV itu menjadi bagian dari proyek topik ini dan tersimpan di folder topik.
import pandas as pd

nilai = pd.DataFrame({
    "kelas": ["7A", "7A", "7A", "7A", "7B", "7B", "7B", "7B", "8A", "8A", "8A", "8A"],
    "nama": ["Ali", "Budi", "Citra", "Dewi", "Eka", "Fajar", "Gita", "Hadi", "Indah", "Joko", "Kartika", "Lutfi"],
    "matematika": [78, 85, 90, 76, 88, 79, 84, 91, 82, 87, 95, 73],
    "bahasa": [82, 79, 88, 81, 90, 84, 77, 86, 89, 80, 92, 78],
})
nilai.to_csv("nilai-tiga-kelas.csv", index=False)
print(pd.read_csv("nilai-tiga-kelas.csv")) kelas nama matematika bahasa
0 7A Ali 78 82
1 7A Budi 85 79
2 7A Citra 90 88
3 7A Dewi 76 81
4 7B Eka 88 90
5 7B Fajar 79 84
6 7B Gita 84 77
7 7B Hadi 91 86
8 8A Indah 82 89
9 8A Joko 87 80
10 8A Kartika 95 92
11 8A Lutfi 73 78Panggilan nilai.groupby("kelas") mengembalikan objek bertipe DataFrameGroupBy, bukan tabel. Objek ini hanya menyimpan rencana pembagian kelompok, dan perhitungannya baru dijalankan saat fungsi agregasi dipanggil. Metode size menghitung jumlah baris per kelompok dan menjadi cara cepat memeriksa pembagiannya.
import pandas as pd

nilai = pd.read_csv("nilai-tiga-kelas.csv")

pengelompokan = nilai.groupby("kelas")
print(type(pengelompokan).__name__)
print()
print(pengelompokan.size())DataFrameGroupBy
kelas
7A 4
7B 4
8A 4
dtype: int64Pemilihan kolom sebelum agregasi, yaitu ["matematika"] setelah groupby, membatasi perhitungan pada satu kolom. Hasil agregasinya berupa Series dengan label kelompok sebagai index.
import pandas as pd

nilai = pd.read_csv("nilai-tiga-kelas.csv")

rata = nilai.groupby("kelas")["matematika"].mean()
print(rata)kelas
7A 82.25
7B 85.50
8A 84.25
Name: matematika, dtype: float64Tiga angka pada keluaran adalah rata-rata matematika kelas 7A, 7B, dan 8A. Perhitungan yang sama tanpa groupby, yaitu nilai["matematika"].mean(), hanya menghasilkan satu rata-rata untuk seluruh siswa dan menghapus informasi per kelas. Karena itu, groupby adalah cara baku ketika pertanyaan analisis menyebut kata “per”, misalnya per kelas, per bulan, atau per kategori.
Beberapa agregasi sekaligus dengan agg#
Satu rata-rata saja jarang cukup untuk membaca kelompok. Metode agg menerima daftar nama fungsi dan menerapkannya sekaligus, sehingga hasilnya berupa tabel dengan satu kolom per fungsi agregasi.
import pandas as pd

nilai = pd.read_csv("nilai-tiga-kelas.csv")

ringkasan = nilai.groupby("kelas")["matematika"].agg(["mean", "median", "max"])
print(ringkasan) mean median max
kelas
7A 82.25 81.5 90
7B 85.50 86.0 91
8A 84.25 84.5 95Tabel itu menunjukkan sesuatu yang tidak terlihat pada rata-rata saja. Rata-rata ketiga kelas berdekatan, sedangkan nilai maksimumnya berjauhan. Kelas 8A memuat siswa dengan nilai tertinggi, yaitu 95, tetapi rata-ratanya justru di bawah 7B, sehingga angka maksimum saja menyesatkan sebagai ukuran kinerja kelas. Perbandingan mean dengan median yang berdekatan juga menjadi petunjuk awal bahwa sebaran nilai tiap kelompoknya tidak ekstrem.
Nama kolom mean, median, dan max berasal dari nama fungsinya, dan nama itu tidak selalu deskriptif untuk laporan. Named aggregation, yakni agregasi dengan nama kolom hasil yang ditentukan sendiri, memberi kontrol penuh atasnya. Setiap argumen menyatakan nama kolom baru beserta pasangan kolom sumber dan fungsinya.
import pandas as pd

nilai = pd.read_csv("nilai-tiga-kelas.csv")

ringkasan = nilai.groupby("kelas").agg(
    rata_matematika=("matematika", "mean"),
    bahasa_tertinggi=("bahasa", "max"),
    jumlah_siswa=("nama", "count"),
)
print(ringkasan) rata_matematika bahasa_tertinggi jumlah_siswa
kelas
7A 82.25 88 4
7B 85.50 90 4
8A 84.25 92 4Hasilnya siap ditempatkan ke dalam laporan tanpa penggantian nama tambahan. Kolom jumlah_siswa menghitung baris terisi pada kolom nama, sehingga berfungsi sebagai penghitung anggota kelompok. Pencampuran kolom sumber dan fungsi yang berbeda dalam satu panggilan agg seperti ini adalah pola ringkasan yang lazim pada laporan analisis.
Membaca hasil agregasi dengan grafik#
Tabel ringkasan berukuran kecil sudah cukup untuk dibaca langsung. Apabila kelompoknya banyak, grafik batang membantu membandingkan ukurannya secara sekilas. Grafik berikut menggambar rata-rata matematika per kelas dari hasil groupby dan menyimpannya sebagai berkas PNG di folder topik.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

nilai = pd.read_csv("nilai-tiga-kelas.csv")
rata = nilai.groupby("kelas")["matematika"].mean()

plt.bar(rata.index, rata.values, color="#4C72B0")
plt.title("Rata-rata nilai matematika per kelas")
plt.xlabel("Kelas")
plt.ylabel("Rata-rata nilai")
plt.ylim(0, 100)
plt.savefig("rata-rata-per-kelas.png", dpi=120)
print("Gambar tersimpan sebagai rata-rata-per-kelas.png")Gambar tersimpan sebagai rata-rata-per-kelas.png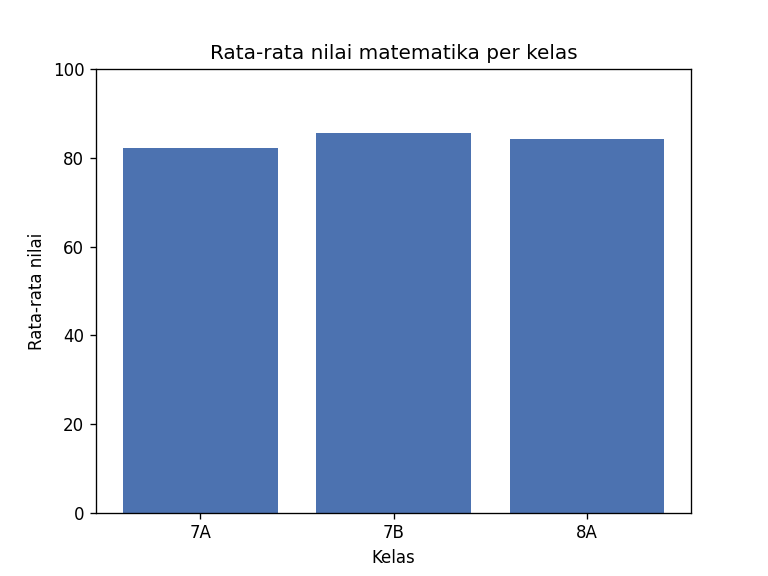
Tiga batang pada grafik memberi gambaran yang sama dengan tabel agg sebelumnya, yaitu kelas 7B sedikit di atas dua kelas lainnya dan seluruh rata-rata berada di kisaran 80 sampai 86. Grafik membuat perbandingan antarkelompok terlihat seketika, tetapi angka di baliknya tetap menjadi acuan laporan. Tabel ringkasan dan grafik yang berasal dari perhitungan yang sama menjaga keduanya tetap konsisten.
Kesalahan umum#
Kesalahan pertama adalah mengagregasi tanpa memilih kolom. Apabila groupby dipanggil tanpa pemilihan kolom, pandas mencoba menerapkan fungsi pada seluruh kolom, termasuk kolom teks seperti nama. Fungsi mean tidak berlaku untuk teks, sehingga panggilan semacam itu berakhir dengan TypeError. Pilih kolomnya secara eksplisit, misalnya ["matematika", "bahasa"], agar hanya kolom yang dimaksud yang dihitung.
Kesalahan kedua adalah melupakan bentuk index hasilnya. Hasil groupby menjadikan kolom kunci pengelompokan sebagai index, sehingga kelas tidak lagi berada di kolom. Perilaku ini praktis untuk seleksi dengan loc, tetapi menyulitkan saat hasilnya digabung dengan tabel lain. Argumen as_index=False atau metode reset_index mengembalikan kunci pengelompokan menjadi kolom biasa.
Kesalahan ketiga adalah menafsirkan rata-rata dari kelompok yang kecil tanpa kehati-hatian. Rata-rata dari empat baris mudah tergeser oleh satu nilai ekstrem, dan kelompok yang anggotanya satu atau dua baris hampir tidak memberi informasi. Periksa size sebelum menafsirkan, dan laporkan jumlah anggota kelompok bersama rata-ratanya.
Ringkasan#
- Pola split-apply-combine bekerja dengan
groupbyyang membagi baris per kelompok, fungsi agregasi yang diterapkan per kelompok, dan hasil yang digabung menjadi satu tabel. aggmenerima beberapa fungsi sekaligus, dan named aggregation memberi nama kolom hasil yang deskriptif untuk laporan.- Grafik batang dari hasil
groupbymempercepat perbandingan antarkelompok, sedangkansizememastikan jumlah anggota setiap kelompok sebelum penafsiran.
Referensi#
- pandas.DataFrame.groupby — Pandas
— Parameter
groupbydan perilaku index pada hasil pengelompokannya. - pandas user guide — Pandas — Panduan resmi pandas yang memuat bagian group by dengan pola split-apply-combine.