Distribusi menggambarkan cara nilai-nilai sebuah kolom tersebar, yaitu letak konsentrasi nilainya, arah pemanjangan ekornya, dan jumlah puncaknya. Topik ini membahas histogram sebagai alat utamanya, bentuk-bentuk distribusi yang umum, serta makna kata normal pada data terukur. Setelah membacanya, histogram dari data sendiri dapat dibuat dengan matplotlib dan bentuknya dapat dijelaskan dengan istilah yang tepat.
Histogram dan cara membacanya#
Histogram adalah grafik batang yang membagi rentang nilai numerik menjadi kelompok interval berurutan, kemudian menghitung banyaknya data pada setiap kelompok. Tinggi batang menyatakan banyaknya data dalam kelompok itu, sedangkan posisi batang menyatakan rentang nilainya. Grafik ini menjadi langkah pertama yang lazim untuk membaca bentuk distribusi karena polanya langsung terlihat sebelum angka apa pun dihitung.
Contoh berikut menggunakan nilai ujian 24 siswa pada satu kelas dengan skala 0 sampai 100. Rentang nilai dibagi menjadi kelompok berlebar lima poin, mulai dari 55 sampai 95. Kode menggambar histogramnya dengan matplotlib kemudian menyimpannya sebagai berkas PNG.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

# nilai ujian 24 siswa pada satu kelas, skala 0 sampai 100
nilai = [62, 65, 66, 68, 70, 71, 72, 73, 73, 74, 75, 75, 76, 76, 77, 78,
         79, 80, 81, 82, 84, 85, 88, 90]

plt.figure(figsize=(8, 4.5))
plt.hist(nilai, bins=range(55, 100, 5), color="#4C72B0", edgecolor="white")
plt.title("Distribusi nilai ujian 24 siswa")
plt.xlabel("Nilai ujian")
plt.ylabel("Banyak siswa")
plt.savefig("histogram-nilai-ujian.png", dpi=120)
print("Grafik tersimpan: histogram-nilai-ujian.png")Grafik tersimpan: histogram-nilai-ujian.png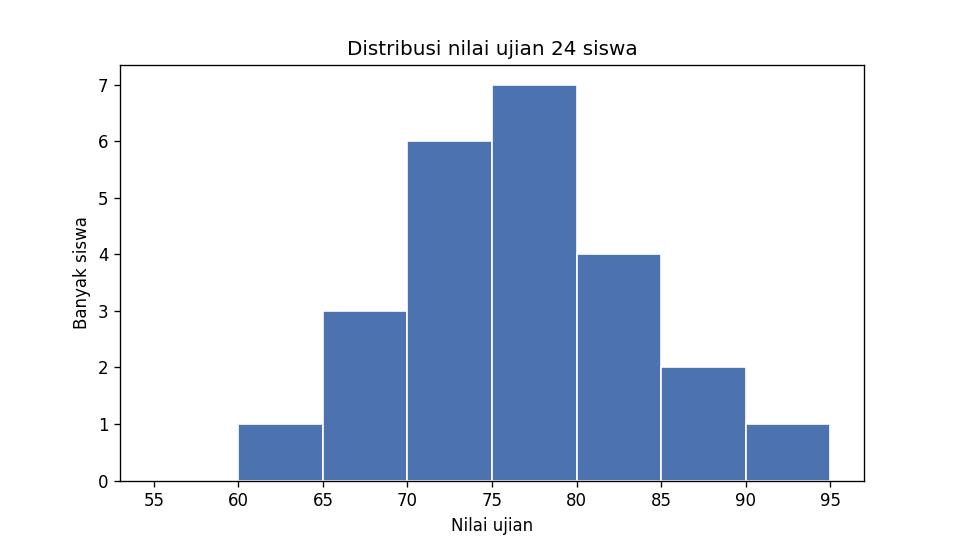
Gambar di atas memperlihatkan satu puncak yang jelas. Batang tertinggi berada pada rentang 75 sampai 80 dan memuat tujuh siswa, batang di sebelah kirinya memuat enam siswa, sedangkan batang di sebelah kanannya memuat empat siswa. Di kedua ujungnya, batang mengecil, yaitu satu siswa pada rentang 60 sampai 65 dan satu siswa pada rentang 90 sampai 95. Pola seperti ini disebut memusat karena nilai-nilainya berkumpul di tengah dan menipis ke arah tepi.
Tampilan histogram bergantung pada lebar kelompok yang dipilih. Data yang sama dihitung ulang dengan dua lebar berbeda untuk melihat efeknya. Rentangnya tetap 55 sampai 95, sehingga yang berubah hanyalah banyaknya batang.
import numpy as np

# data nilai ujian yang sama, dihitung dengan dua lebar kelompok
nilai = [62, 65, 66, 68, 70, 71, 72, 73, 73, 74, 75, 75, 76, 76, 77, 78,
         79, 80, 81, 82, 84, 85, 88, 90]

for lebar in (5, 10):
    tepi = np.arange(55, 100, lebar)
    banyak, _ = np.histogram(nilai, bins=tepi)
print(f"lebar {lebar}: {banyak.tolist()}")lebar 5: [0, 1, 3, 6, 7, 4, 2, 1]
lebar 10: [1, 9, 11, 3]Dengan lebar lima poin, banyaknya siswa per kelompok terbaca rinci. Dengan lebar sepuluh poin, batangnya tinggal empat dan puncaknya lebih lebar, tetapi kesan satu puncak di tengah tetap sama. Lebar yang terlalu kecil membuat batang jarang dan sulit dibaca, sedangkan lebar yang terlalu besar menyembunyikan perubahan bentuk. Nilai sepuluh sampai dua puluh kelompok sering menjadi titik awal yang aman untuk data berukuran kecil, dan hasilnya diperiksa kembali dengan mata sebelum disimpulkan.
Bentuk distribusi yang umum#
Tiga bentuk muncul berulang kali pada data terukur. Distribusi satu puncak (unimodal) memiliki satu batang tertinggi dengan nilai-nilai lain menipis ke kedua sisinya. Distribusi condong (skewed) memiliki ekor yang memanjang lebih jauh ke satu sisi, dan arah ekor itulah yang menjadi namanya, misalnya condong kanan apabila ekornya memanjang ke nilai besar. Distribusi dua puncak (bimodal) memiliki dua batang menonjol yang dipisahkan lekukan di tengah.
Cara mengenalinya di layar cukup sederhana. Amati letak batang tertingginya, bayangkan garis tengah datanya, kemudian lihat sisi mana yang ekornya lebih panjang. Contoh klasik condong kanan adalah durasi tunggu layanan, karena sebagian besar pengguna dilayani cepat sedangkan segelintir kasus menunggu sangat lama. Distribusi dua puncak biasanya menandakan data yang menggabungkan dua kelompok berbeda, misalnya nilai ujian dari dua kelas dengan tingkat penguasaan materi yang jauh.
Setiap bentuk mendorong pertanyaan lanjutan yang berbeda. Distribusi memusat cukup dirangkum dengan ukuran pusat dan ukuran sebarannya. Distribusi condong menuntut kehati-hatian karena nilai rata-ratanya tergeser ke arah ekor. Distribusi dua puncak menyarankan pemecahan data per kelompoknya sebelum disimpulkan. Karena itulah pembacaan bentuk selalu mendahului perhitungan.
Makna kata normal pada data terukur#
Kata normal pada statistika menyatakan bentuk tertentu, bukan penilaian baik atau wajar. Distribusi normal adalah distribusi yang simetris, memiliki satu puncak tepat di tengah, dan memiliki ekor yang menipis sama jauh ke kedua sisi. Data yang mendekati bentuk ini sering disebut kira-kira normal, karena data nyata hampir tidak pernah simetris sempurna.
Bentuk ini sering muncul pada data terukur karena nilai akhirnya merupakan hasil penjumlahan banyak pengaruh kecil. Nilai ujian dipengaruhi penguasaan materi, kondisi saat mengerjakan, dan kebetulan pemilihan soal. Tinggi badan dipengaruhi banyak faktor biologis yang bekerja bersamaan. Apabila pengaruh-pengaruh kecil itu tidak saling bergantung, kumpulan nilainya cenderung berkumpul di tengah dan menipis simetris ke kedua ujung, yaitu bentuk yang menyerupai kurva lonceng (bell curve).
Pada praktiknya, kecocokan yang kira-kira sudah cukup. Simetri kasar, satu puncak di tengah, dan ekor yang menipis tanpa tonjolan biasanya cukup untuk menyebut data kira-kira normal. Sebaliknya, distribusi yang condong jelas bukan normal, dan memaksanya disebut normal akan menyesatkan analisis berikutnya karena banyak metode statistik mengandalkan asumsi bentuk ini. Data yang condong tetap sah untuk dianalisis, tetapi ukuran dan metodenya perlu menyesuaikan bentuk, misalnya dengan memilih median sebagai ukuran pusat.
Yang tidak dikatakan histogram#
Histogram menampilkan hitungan per kelompok, bukan nilai individual. Dua kumpulan data yang isinya berbeda dapat menghasilkan histogram yang tampak sama, karena batang hanya menyatakan banyaknya data dalam rentang tertentu. Posisi mean, yaitu rata-rata yang dihitung dari seluruh nilai, dan median, yaitu nilai tengah data, tidak digambarkan secara presisi, sehingga kedua ukuran itu tetap dihitung terpisah.
Histogram juga tidak menyimpan urutan pencatatan. Data konsumsi listrik selama sebulan yang digambar histogram kehilangan informasi hariannya, sehingga tren kenaikan di akhir pekan tidak terlihat. Deret waktu dibaca dengan grafik garis, bukan dengan histogram. Selain itu, pada data yang jumlahnya sedikit, bentuk histogram mudah berubah hanya karena satu nilai tambahan, sehingga kesimpulan bentuk perlu disertai catatan ukuran datanya.
Untuk distribusi dua puncak, langkah berikutnya adalah memeriksa kolom kategori yang menyertai data. Pemecahan histogram per kelas, per unit, atau per hari operasinya sering mengungkap bahwa dua puncak berasal dari dua kelompok yang berbeda. Histogram keseluruhan tetap berguna, tetapi histogram per kelompok biasanya memberi jawaban yang lebih tepat sasaran.
Ringkasan#
- Histogram membagi rentang nilai menjadi kelompok berurutan dan menghitung banyaknya data per kelompok, sehingga bentuk distribusi terbaca dari pola batangnya.
- Bentuk yang umum adalah satu puncak, condong kanan atau kiri, dan dua puncak, dan masing-masing mendorong pertanyaan lanjutan yang berbeda.
- Kata normal menyatakan bentuk simetris dengan satu puncak dan ekor menipis, bukan penilaian kewajaran data.
- Lebar kelompok, banyaknya data, dan kehadiran subkelompok mengubah tampilan histogram, sehingga bentuk dibaca hati-hati sebelum disimpulkan.
Referensi#
- Dokumentasi resmi matplotlib — Matplotlib Development Team — Dokumentasi fungsi pyplot.hist dan pengaturan kelompok histogram.
- Dokumentasi resmi numpy — NumPy Project — Dokumentasi numpy.histogram untuk menghitung kelompok secara numerik.
- OpenIntro Statistics — OpenIntro — Bab distribusi data tunggal, termasuk bentuk distribusi dan kurva normal.